
服务注册与分布式协调 / 系统课时
排查事件历史过大
排查事件历史过大
事件历史过大会拖慢 Workflow Replay,并最终触碰单次 Workflow Execution 的历史限制。本节用 CLI 导出并统计历史,区分高频 Signal、循环 Activity 与大 Payload 三种主要增长来源,再分别使用 Continue-As-New、批处理和外部存储把历史控制在稳定范围。
学习目标
- 从事件类型和 Payload 体量判断 Event History 的主要增长来源
- 选择 Continue-As-New、状态精简或外部存储处理不同问题
- 在不破坏 Workflow 状态连续性的前提下验证新 Run 的历史已重置
先区分事件数量和历史体积
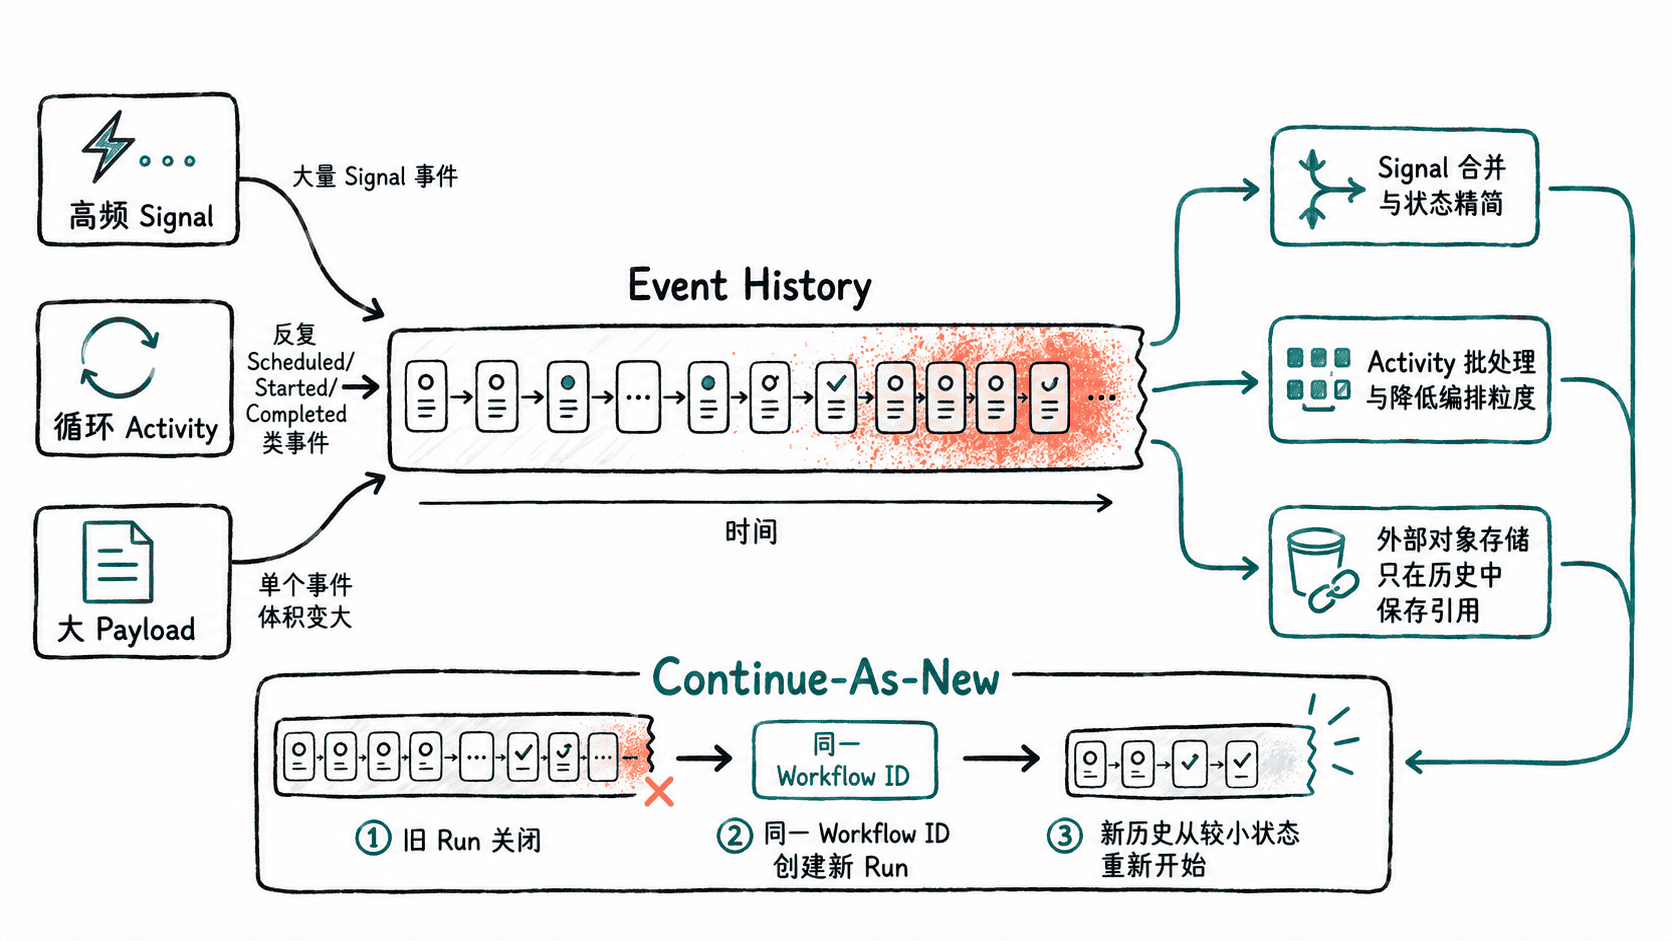
Event History 是 Workflow Execution 的追加日志。每次 Signal、Activity 调度与完成、Timer 等都会贡献事件;Workflow 或 Activity 的输入输出又会把 Payload 写入历史。因此“事件很多”和“事件不多但每个 Payload 很大”是两类不同问题。
高频 Signal 往往让事件数量快速增加;无限循环或细粒度 Activity 会持续产生调度与完成事件;大对象在 Workflow 参数、Activity 参数或返回值之间反复传递,则主要推高历史字节数。三种情况可能同时存在,所以先量化再改代码。
导出历史并找出主要贡献者
先导出指定 Run,避免只给 Workflow ID 时误查到最新 Run。下面的主示例还用 jq 统计事件总数与出现最多的事件类型。
temporal workflow show \
  --workflow-id <WORKFLOW_ID> \
  --run-id <RUN_ID> \
  --namespace <NAMESPACE> \
  --output json > history.json

jq '.events | length' history.json
jq -r '.events[].eventType' history.json | sort | uniq -c | sort -nr | head
预期输出中的数量取决于实际历史;关键是先得到总事件数,再看到高频事件类型。
<EVENT_COUNT>
<COUNT> <EVENT_TYPE>
<COUNT> <EVENT_TYPE>
<COUNT> <EVENT_TYPE>
如果 Signal 相关事件占比很高,检查发送端是否把可合并的状态变化拆成了大量消息;如果 Activity 相关事件反复出现,回到 Workflow 看是否存在无边界循环或过细的编排粒度。事件数不高但 history.json 很大时,则重点检查 Workflow/Activity 输入输出是否携带完整文档、图片、批量记录或其他大对象。
按增长来源选择修复手段
高频 Signal 的重点是减少“每个变化都永久写入历史”的次数。能合并的状态更新尽量批量发送,业务上只保留当前状态而不需要完整明细时,在 Workflow 内维护精简状态;长生命周期实体 Workflow 则应周期性 Continue-As-New,而不是让一个 Run 无限增长。
循环 Activity 应先检查是否把大量同质小任务逐个编排。能够批量处理的数据可让单个 Activity 一次处理一批,或在 Workflow 中以明确批次推进游标。这样既减少历史事件,也降低服务端与 Worker 的调度开销。
大 Payload 不应靠 Continue-As-New 单独解决,因为每个新 Run 仍可能继续携带大对象。更稳妥的做法是把对象写入数据库或对象存储,只把对象 ID、版本号或路径放进 Workflow 与 Activity 参数。这样历史保存的是稳定引用,而不是整份业务数据。
把 Continue-As-New 变成可控的边界
以下 Go SDK 代码是片段示例,依赖已经注册名为 ProcessBatch 的 Activity。它在每轮批处理前检查服务端给出的 Continue-As-New 建议,并把当前游标作为新 Run 的输入。
type BatchState struct {
    Cursor int
}

func BatchWorkflow(ctx workflow.Context, state BatchState) error {
    ctx = workflow.WithActivityOptions(ctx, workflow.ActivityOptions{
        StartToCloseTimeout: time.Minute,
    })

    for {
        // 让 SDK/服务端的建议成为历史轮转信号,而不是写死极限值。
        if workflow.GetInfo(ctx).GetContinueAsNewSuggested() {
            return workflow.NewContinueAsNewError(ctx, BatchWorkflow, state)
        }

        var next int
        if err := workflow.ExecuteActivity(ctx, "ProcessBatch", state.Cursor).
            Get(ctx, &next); err != nil {
            return err
        }
        state.Cursor = next
    }
}
生效行为是:当前 Run 以 Continued-As-New 结束,同一个 Workflow ID 获得新的 Run ID,新 Run 从 BatchState 恢复业务游标,但不会继承旧 Run 的 Event History。若 Workflow 使用 Signal 或 Update Handler,应先确保正在处理的 Handler 已完成,再进入 Continue-As-New 边界。
验证修复没有只把问题推迟
部署后先观察新 Run 的历史是否从较小规模重新开始,再在多个轮转周期内检查增长斜率。事件数持续快速增加,说明只是更频繁地“切历史”,还没有解决 Signal 频率或 Activity 粒度;文件体积仍异常,则继续检查 Payload 是否真正外部化。
最终验收应同时满足:Replay 延迟恢复正常,新 Run 能从最小必要状态继续业务,历史增长速度与业务吞吐成可解释关系,而且没有因为 Continue-As-New 丢失未处理消息或状态。