
Rust / 系统课时
诊断延迟与吞吐问题
诊断延迟与吞吐问题
延迟升高和吞吐下降常常同时出现,但原因可能分别来自运行时线程被阻塞、任务堆积、通道背压、锁竞争或缓冲过大。本篇建立固定诊断顺序,并用一个可运行的小型流水线同时采集调度延迟、并发任务数、发送等待和锁等待,避免只调一个参数就碰运气。
学习目标
- 按“调度线程 → 任务数量 → 通道 → 锁 → 缓冲”的顺序定位性能瓶颈
- 用可重复负载和同一组指标比较修复前后,而不是只观察平均耗时
- 识别扩大任务数、通道容量或缓冲区可能掩盖背压并放大尾延迟的场景
先固定诊断顺序
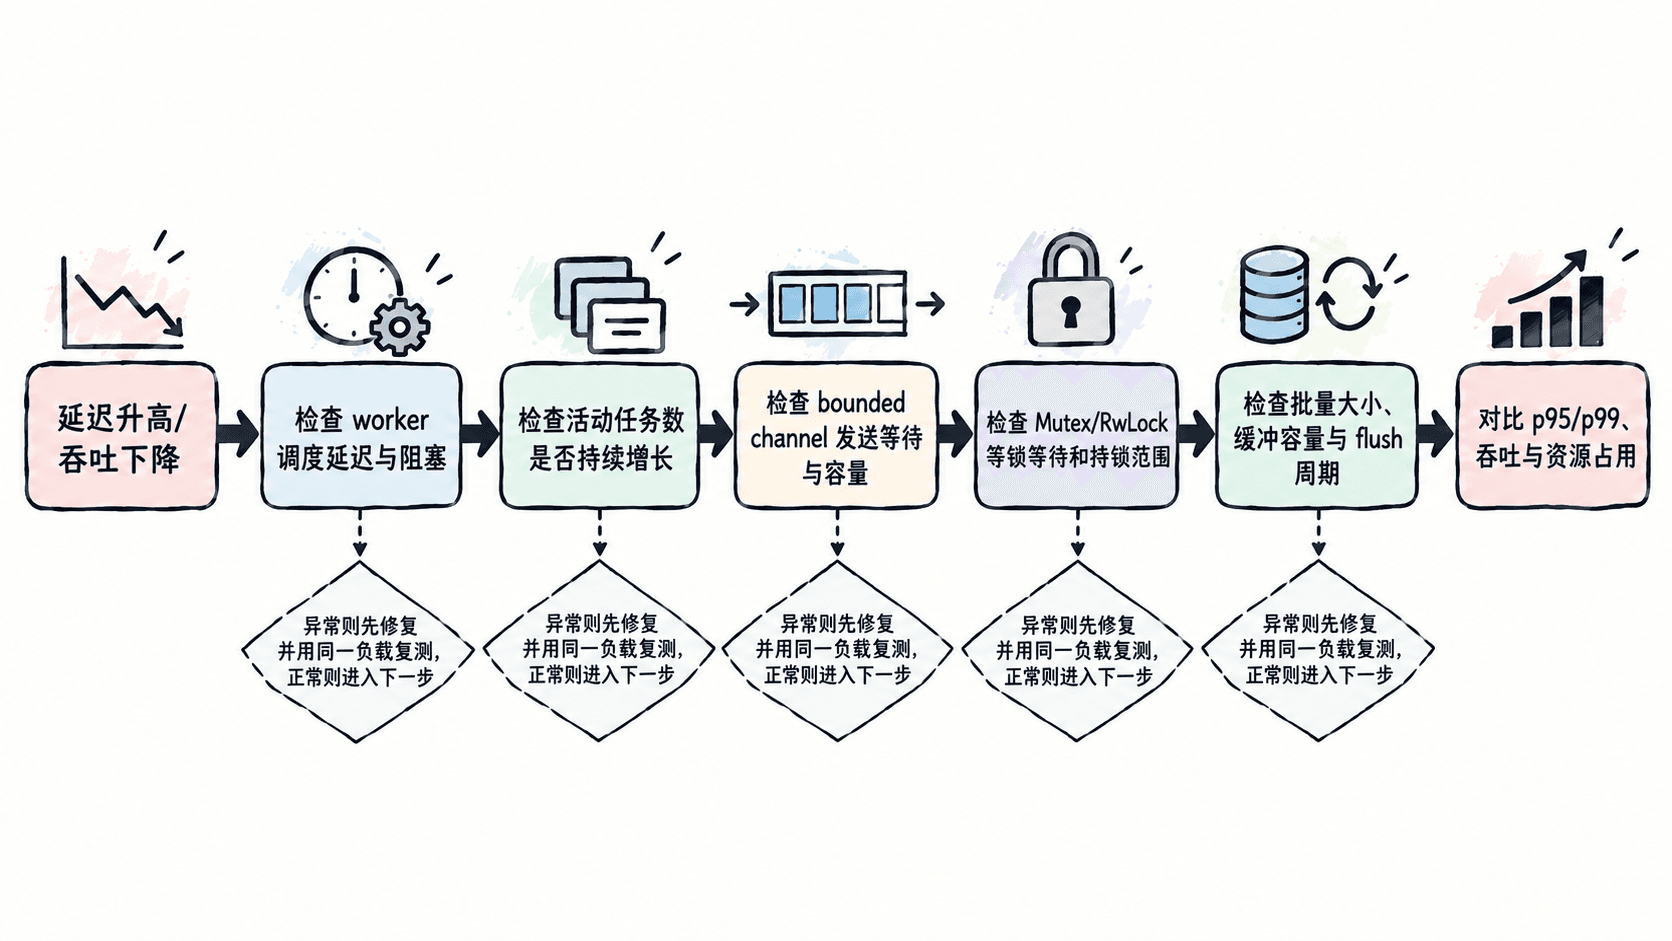
第一步先确认工作线程是否被同步阻塞或长时间计算占满,因为这会让后续所有异步指标一起恶化。第二步看任务数量是否持续增长;任务增长通常说明入口速度高于完成速度,不能简单理解为“并发越高越好”。第三步再看有界通道发送等待,确认背压出现在哪里。
随后检查锁等待和临界区长度。如果大量任务都在等同一个锁,应先缩短持锁范围,而不是增加 worker 数。最后才调整通道容量、批量大小和 flush 周期:更大的缓冲能吸收短突发,但也可能让请求在队列里停留更久。
用一个流水线同时采证据
示例使用容量为 16 的 mpsc 作为入口缓冲,用 Semaphore 把活动工作任务限制为 8 个,并记录发送等待、锁等待、心跳调度延迟和最大活动任务数。bad 模式故意在异步任务里持锁执行 std::thread::sleep;good 模式缩短持锁范围,并把模拟等待改成异步定时器。
[package]
name = "tokio-perf-diagnose"
version = "0.1.0"
edition = "2021"

[dependencies]
tokio = { version = "1", features = ["full"] }
该配置只引入示例需要的 Tokio 能力;下面的运行命令会同时完成编译验证。
use std::{
    env,
    sync::{
        atomic::{AtomicBool, AtomicU64, AtomicUsize, Ordering},
        Arc,
    },
    time::Duration,
};
use tokio::{
    sync::{mpsc, Mutex, Semaphore},
    task::JoinSet,
    time::Instant,
};

const JOBS: u64 = 80;
const CHANNEL_CAPACITY: usize = 16;
const CONCURRENCY: usize = 8;

#[derive(Clone, Copy)]
enum Mode {
    Bad,
    Good,
}

impl Mode {
    fn name(self) -> &'static str {
        match self {
            Mode::Bad => "bad",
            Mode::Good => "good",
        }
    }
}

#[tokio::main(flavor = "multi_thread", worker_threads = 1)]
async fn main() {
    let mode = match env::args().nth(1).as_deref() {
        Some("bad") => Mode::Bad,
        _ => Mode::Good,
    };
    run(mode).await;
}

async fn run(mode: Mode) {
    let (tx, mut rx) = mpsc::channel::<u64>(CHANNEL_CAPACITY);
    let shared = Arc::new(Mutex::new(0_u64));
    let slots = Arc::new(Semaphore::new(CONCURRENCY));

    let active = Arc::new(AtomicUsize::new(0));
    let max_active = Arc::new(AtomicUsize::new(0));
    let max_send_wait = Arc::new(AtomicU64::new(0));
    let max_lock_wait = Arc::new(AtomicU64::new(0));
    let max_heartbeat_lag = Arc::new(AtomicU64::new(0));
    let stop = Arc::new(AtomicBool::new(false));

    // 心跳延迟近似反映 runtime worker 无法及时重新调度任务的程度。
    let heartbeat_lag = max_heartbeat_lag.clone();
    let heartbeat_stop = stop.clone();
    let heartbeat = tokio::spawn(async move {
        while !heartbeat_stop.load(Ordering::Relaxed) {
            let started = Instant::now();
            tokio::time::sleep(Duration::from_millis(10)).await;
            let lag = started
                .elapsed()
                .saturating_sub(Duration::from_millis(10));
            heartbeat_lag.fetch_max(lag.as_micros() as u64, Ordering::Relaxed);
        }
    });

    let send_wait = max_send_wait.clone();
    let producer = tokio::spawn(async move {
        for job in 0..JOBS {
            let started = Instant::now();
            tx.send(job).await.expect("receiver must stay alive");
            send_wait.fetch_max(started.elapsed().as_micros() as u64, Ordering::Relaxed);
        }
    });

    let started = Instant::now();
    let mut tasks = JoinSet::new();

    while let Some(job) = rx.recv().await {
        // 在 spawn 前取得许可,避免把“限流”写进任务内部后仍创建海量等待任务。
        let permit = slots.clone().acquire_owned().await.unwrap();
        let shared = shared.clone();
        let active = active.clone();
        let max_active = max_active.clone();
        let lock_wait = max_lock_wait.clone();

        tasks.spawn(async move {
            let now = active.fetch_add(1, Ordering::Relaxed) + 1;
            max_active.fetch_max(now, Ordering::Relaxed);

            match mode {
                Mode::Bad => {
                    let lock_started = Instant::now();
                    let mut guard = shared.lock().await;
                    lock_wait.fetch_max(
                        lock_started.elapsed().as_micros() as u64,
                        Ordering::Relaxed,
                    );
                    // 故意阻塞唯一 worker,并把阻塞时间放大到锁临界区。
                    std::thread::sleep(Duration::from_millis(5));
                    *guard += job;
                }
                Mode::Good => {
                    let lock_started = Instant::now();
                    {
                        let mut guard = shared.lock().await;
                        lock_wait.fetch_max(
                            lock_started.elapsed().as_micros() as u64,
                            Ordering::Relaxed,
                        );
                        *guard += job;
                    }
                    tokio::time::sleep(Duration::from_millis(5)).await;
                }
            }

            active.fetch_sub(1, Ordering::Relaxed);
            drop(permit);
        });

        while let Some(result) = tasks.try_join_next() {
            result.expect("worker task panicked");
        }
    }

    producer.await.expect("producer panicked");
    while let Some(result) = tasks.join_next().await {
        result.expect("worker task panicked");
    }

    stop.store(true, Ordering::Relaxed);
    heartbeat.await.expect("heartbeat panicked");

    println!(
        "mode={} elapsed_ms={} max_active={} max_send_wait_us={} max_lock_wait_us={} max_heartbeat_lag_us={}",
        mode.name(),
        started.elapsed().as_millis(),
        max_active.load(Ordering::Relaxed),
        max_send_wait.load(Ordering::Relaxed),
        max_lock_wait.load(Ordering::Relaxed),
        max_heartbeat_lag.load(Ordering::Relaxed),
    );
}
预期结果
程序接受 bad 或 good 模式参数,并输出 elapsed、活动任务数、发送等待、锁等待和心跳调度延迟。在同一台机器、同一构建配置下连续运行两种模式:
cargo run -- bad
cargo run -- good
预期输出
mode=bad elapsed_ms=<TIME> max_active=<COUNT> max_send_wait_us=<TIME> max_lock_wait_us=<TIME> max_heartbeat_lag_us=<TIME>
mode=good elapsed_ms=<TIME> max_active=<COUNT> max_send_wait_us=<TIME> max_lock_wait_us=<TIME> max_heartbeat_lag_us=<TIME>数值受机器负载影响,不应比较绝对值。这个受控示例里,bad 通常会出现更大的心跳延迟、锁等待和发送等待;good 让模拟等待主动让出 worker,并避免在等待期间持锁,因此同一批 80 个任务应更快排空。
把指标映射到根因
如果心跳延迟明显升高,先搜索异步上下文里的同步文件 I/O、同步网络调用、std::thread::sleep 或长时间 CPU 计算。可替换成真正异步 API 的优先替换;必须调用阻塞 API 时,把有界、会结束的工作放进 tokio::task::spawn_blocking,并对大量 CPU 密集工作额外限制并行度。
如果 max_active 长期顶住并发上限,同时发送等待继续上升,瓶颈在消费侧而不是通道太小。此时扩大 CHANNEL_CAPACITY 只会允许更多请求排队。相反,如果负载只是短促突发、消费者很快追上,适度缓冲才可能降低入口抖动。
如果锁等待高但心跳正常,重点看临界区:是否跨 .await、是否把序列化/格式化等计算也放在锁内、是否可以按 key 分片状态。增加任务数通常会让锁竞争更严重,不会提升吞吐。
调整缓冲时同时看尾延迟
缓冲策略必须和延迟目标一起验证。增大 channel、批量聚合或延迟 flush 往往可以减少调度和 I/O 次数,却也增加单个请求在队列中的停留时间。每次只改一个变量,并用同一负载比较吞吐、p95/p99、发送等待、锁等待和内存占用,才能知道优化究竟移动了瓶颈还是消除了瓶颈。