
Rust / 系统课时
使用 spawn_blocking 与 block_in_place
使用 spawn_blocking 与 block_in_place
Tokio 提供 spawn_blocking 和 block_in_place 来隔离不得不执行的同步阻塞代码,但两者改变的执行边界不同。本节通过线程模型、可运行示例和取消限制建立选择规则,避免把阻塞线程池当成无限 CPU 资源,也避免在错误运行时中调用 block_in_place。
学习目标
- 区分
spawn_blocking与block_in_place的线程行为和返回方式 - 根据同步调用的边界选择合适的阻塞隔离 API
- 说明两种 API 的取消与运行时关闭限制
两个 API 改变的是不同边界
spawn_blocking 把闭包提交到 Tokio 的阻塞线程池,调用方得到 JoinHandle 并异步等待结果;即使使用单线程异步调度器,它仍可以另外创建阻塞线程。block_in_place 则让当前线程直接执行闭包,同时通知多线程运行时把该工作线程上的其他异步工作交给别的工作线程,因此闭包本身不会被搬到阻塞线程池。
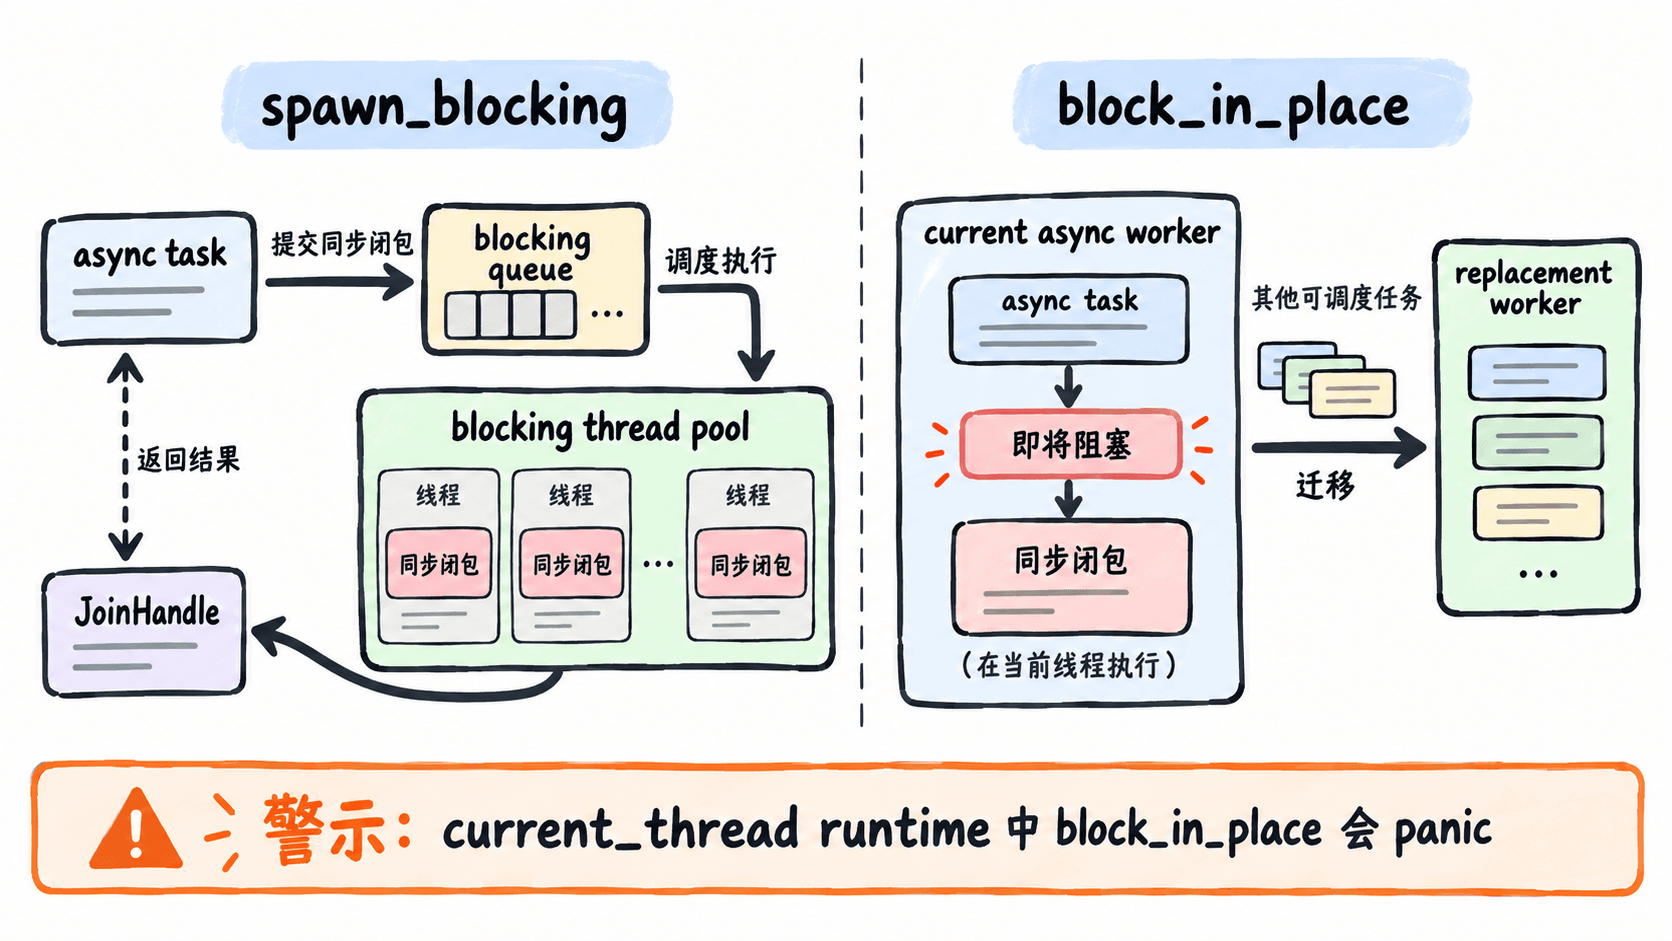
| 对比点 | spawn_blocking |
block_in_place |
|---|---|---|
| 闭包执行位置 | Tokio 阻塞线程池中的线程 | 当前线程 |
| 调用结果 | 返回 JoinHandle<R>,通常需要 .await |
直接返回 R |
| 单线程运行时 | 可以使用,阻塞工作仍在额外线程执行 | 在 current_thread 运行时内部调用会 panic |
| 对当前任务的影响 | 当前异步任务可挂起等待结果 | 当前任务同步停在闭包内 |
| 典型用途 | 同步库调用、文件处理、有界 CPU 工作 | 多线程运行时中必须原地执行的短阻塞段 |
| 取消特性 | 已开始后 abort 不能停止闭包 |
闭包执行期间不能取消 |
用一个程序比较两种调用方式
下面的项目同时调用两个 API。spawn_blocking 执行期间,同一个 join! 中的异步分支仍能推进;随后 block_in_place 在当前线程执行一个短同步片段。
[package]
name = "blocking-api-demo"
version = "0.1.0"
edition = "2021"

[dependencies]
tokio = { version = "1", features = ["macros", "rt-multi-thread", "time"] }
将 src/main.rs 替换为:
use std::time::Duration;
use tokio::task;
use tokio::time::sleep;

#[tokio::main(flavor = "multi_thread", worker_threads = 2)]
async fn main() {
    let blocking = task::spawn_blocking(|| {
        std::thread::sleep(Duration::from_millis(100));
        21 * 2
    });

    let async_peer = async {
        sleep(Duration::from_millis(20)).await;
        println!("async task progressed");
    };

    // 等待阻塞线程池结果时,async_peer 仍可被运行时调度。
    let (blocking_result, _) = tokio::join!(blocking, async_peer);
    let value = blocking_result.unwrap();

    // block_in_place 的闭包直接占用当前线程,适合短而明确的同步区段。
    let next = task::block_in_place(|| {
        std::thread::sleep(Duration::from_millis(50));
        value + 1
    });

    println!("spawn_blocking result: {value}");
    println!("block_in_place result: {next}");
}
在项目目录执行 cargo run。预期输出:
async task progressed
spawn_blocking result: 42
block_in_place result: 43
这个示例刻意使用多线程运行时,因为 block_in_place 需要运行时能够把其他异步工作转移给别的工作线程。它不是“把当前闭包切到后台线程”的简写,真正被重新安排的是当前工作线程原本可以调度的其他任务。
不要把阻塞线程池当成无限 CPU 池
spawn_blocking 会按需要增加阻塞线程,达到运行时配置的上限后再排队。这个上限默认适合兼容可能大量出现的阻塞 I/O,并不等于适合让大量 CPU 密集任务同时跑满。若一次提交成百上千个压缩、编码或哈希任务,过多线程会争抢 CPU、缓存和内存,整体吞吐反而可能下降。
CPU 密集任务使用 spawn_blocking 时应额外限制并发量,例如在提交前通过信号量控制同时运行的工作数;持续时间很长或长期驻留的工作更适合专用线程或专门的 CPU 线程池。spawn_blocking 的定位是“隔离有界同步工作”,不是通用的后台任务系统。
理解取消和关闭限制
普通异步任务可以在合适的调度点响应取消,但已经开始运行的同步闭包没有这样的轮询点。对 spawn_blocking 返回的 JoinHandle 调用 abort,只有任务尚未开始时才可能阻止它启动;一旦闭包已经运行,abort 不会中断它。block_in_place 中正在执行的代码同样不能被异步取消。
运行时关闭时也要考虑这一点:已开始的阻塞工作可能让运行时继续等待。即使使用带超时的关闭方式停止等待,也只是调用方不再等待,并不会强行终止同步代码。因此传给这两个 API 的工作都应该有明确终点;外部 I/O 若可能永久卡住,还需要在同步库自身提供的层面设置超时。
按边界选择 API
优先级可以保持简单:有原生异步 API 就直接使用;必须调用同步函数且可以把输入和输出整体交给另一个线程时,优先 spawn_blocking;只有在多线程运行时中确实需要保留当前线程或当前任务上下文,并且阻塞区段短而可控时,才考虑 block_in_place。对于长期循环、大规模 CPU 批处理或不可预测的永久阻塞,不应依赖这两个 API 无限制承载。