
Rust / 系统课时
使用 Codec 组织协议
使用 Codec 组织协议
手写读取循环能完成分帧,但协议解析、缓冲管理和业务处理容易纠缠在一起。本节把字节到消息的转换封装为 Decoder/Encoder,再交给 Framed 驱动,让同一个 Codec 能复用于客户端、服务端和测试。
学习目标
- 区分
Decoder、Encoder与Framed的职责边界 - 实现一个可复用的换行消息 Codec,并正确处理不完整输入
- 使用
Stream和Sink接口收发应用层消息
Framed 如何连接 I/O 与消息
Decoder 负责从读缓冲区尝试取出一条消息;字节不足时返回 Ok(None),并保留未消费的数据。Encoder 做相反工作,把一条应用消息追加到写缓冲区。Framed 持有异步 I/O、Codec 和内部缓冲区,把读取侧暴露为 Stream,把写入侧暴露为 Sink。
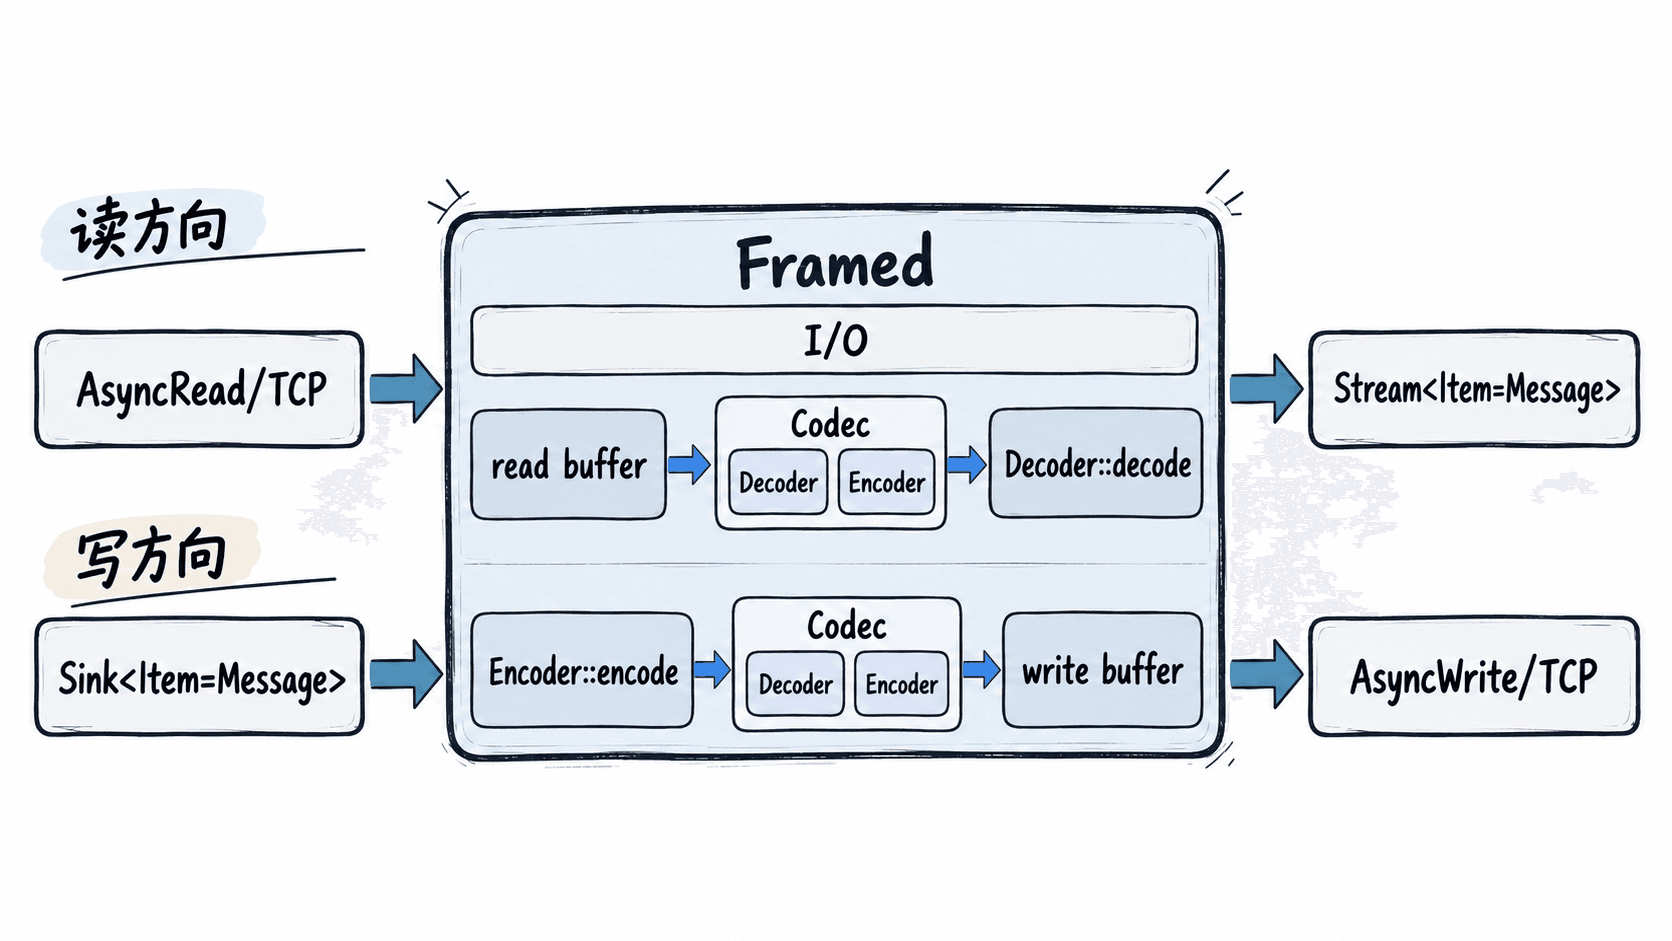
这个边界很重要:业务层应该处理 String、结构体或枚举等消息,不再关心“这次 socket 读到了多少字节”。而 Codec 只处理协议格式,不承担认证、数据库写入或业务状态迁移。
实现可复用 Codec
下面实现一个简单的换行协议:每条 UTF-8 消息以 \n 结束,正文最多 64 字节。Decoder 搜索完整分隔符;没有换行时返回 None,让 Framed 继续读取。Encoder 则把消息和结尾换行写入输出缓冲区。
项目依赖如下:
[package]
name = "codec-demo"
version = "0.1.0"
edition = "2024"

[dependencies]
bytes = "1"
futures = "0.3"
tokio = { version = "1", features = ["macros", "rt-multi-thread", "io-util"] }
tokio-util = { version = "0.7", features = ["codec"] }
主程序使用 tokio::io::duplex 模拟一对双向连接,并让客户端与服务端复用同一个 MessageCodec:
use bytes::{BufMut, BytesMut};
use futures::{SinkExt, StreamExt};
use std::io;
use tokio_util::codec::{Decoder, Encoder, Framed};

struct MessageCodec {
    max_len: usize,
}

impl MessageCodec {
    fn new(max_len: usize) -> Self {
        Self { max_len }
    }
}

impl Decoder for MessageCodec {
    type Item = String;
    type Error = io::Error;

    fn decode(&mut self, src: &mut BytesMut) -> io::Result<Option<String>> {
        let newline = src.iter().position(|byte| *byte == b'\n');

        match newline {
            Some(pos) if pos > self.max_len => Err(io::Error::new(
                io::ErrorKind::InvalidData,
                "message is too long",
            )),
            Some(pos) => {
                // split_to 只消费当前帧,连续到达的下一帧仍保留在 src 中。
                let mut line = src.split_to(pos + 1);
                line.truncate(pos);
                String::from_utf8(line.to_vec())
                    .map(Some)
                    .map_err(|_| io::Error::new(io::ErrorKind::InvalidData, "invalid utf-8"))
            }
            None if src.len() > self.max_len => Err(io::Error::new(
                io::ErrorKind::InvalidData,
                "message is too long",
            )),
            None => Ok(None),
        }
    }
}

impl Encoder<String> for MessageCodec {
    type Error = io::Error;

    fn encode(&mut self, item: String, dst: &mut BytesMut) -> io::Result<()> {
        if item.len() > self.max_len || item.as_bytes().contains(&b'\n') {
            return Err(io::Error::new(
                io::ErrorKind::InvalidInput,
                "invalid outbound message",
            ));
        }

        dst.reserve(item.len() + 1);
        dst.put_slice(item.as_bytes());
        dst.put_u8(b'\n');
        Ok(())
    }
}

#[tokio::main]
async fn main() -> io::Result<()> {
    let (client_io, server_io) = tokio::io::duplex(128);

    let server = tokio::spawn(async move {
        let mut framed = Framed::new(server_io, MessageCodec::new(64));

        while let Some(message) = framed.next().await {
            let message = message?;
            framed.send(format!("ack:{message}")).await?;
        }

        Ok::<_, io::Error>(())
    });

    let mut client = Framed::new(client_io, MessageCodec::new(64));
    client.send("ping".to_owned()).await?;

    if let Some(reply) = client.next().await {
        println!("{}", reply?);
    }

    drop(client);
    server.await.unwrap()?;
    Ok(())
}
预期输出
ack:ping这里客户端和服务端复用了同一个 MessageCodec。Framed 会在读取到新字节后调用 decode,也可能在缓冲区仍有剩余数据时再次调用,所以 decode 必须只消费已经确认属于当前消息的字节;输入不完整时不能提前删除前缀。
Decoder 与 Encoder 的实现边界
实现 Decoder 时,Ok(Some(item)) 表示已经消费并产出一帧,Ok(None) 表示暂时没有完整帧,Err 表示协议层无法继续正常解码。一个输入缓冲区可能同时包含多帧,因此成功产出一帧后应把其余字节留给后续调用。
实现 Encoder 时,应只负责验证并编码单条出站消息。示例禁止消息自身包含换行,否则接收方会把一条业务消息误拆成两帧。二进制协议则可以改用长度前缀 Codec,让消息正文无需避让分隔符。
把业务逻辑留在 Codec 之外
Codec 最适合保持确定性:给定相同字节,应得到相同消息或相同协议错误。认证、限流、数据库访问等业务操作放在 framed.next() 之后处理,这样协议层可以独立单元测试,也能在不同连接类型上复用。
当协议从简单字符串演进为命令枚举或结构体时,只需要改变 Decoder::Item 与 Encoder 接受的消息类型,业务层仍通过 Stream/Sink 面向消息工作。这样就把“TCP 是字节流”的复杂性限制在 Codec 边界内,而不是扩散到每个请求处理函数。