
Rust / 系统课时
设计重试与超时预算
设计重试与超时预算
重试不是“失败就再来一次”。本节把一次异步请求拆成总时间预算、单次尝试上限、有限重试和退避四个约束,并用 Tokio 写出一段可运行的预算控制逻辑,让慢请求不会因为重试被无限放大。
学习目标
- 用截止时间约束整次请求,而不是只给每次调用设置超时
- 区分可重试错误、不可重试错误和预算耗尽
- 组合有限重试与指数退避,并理解幂等性边界
先分配总时间预算
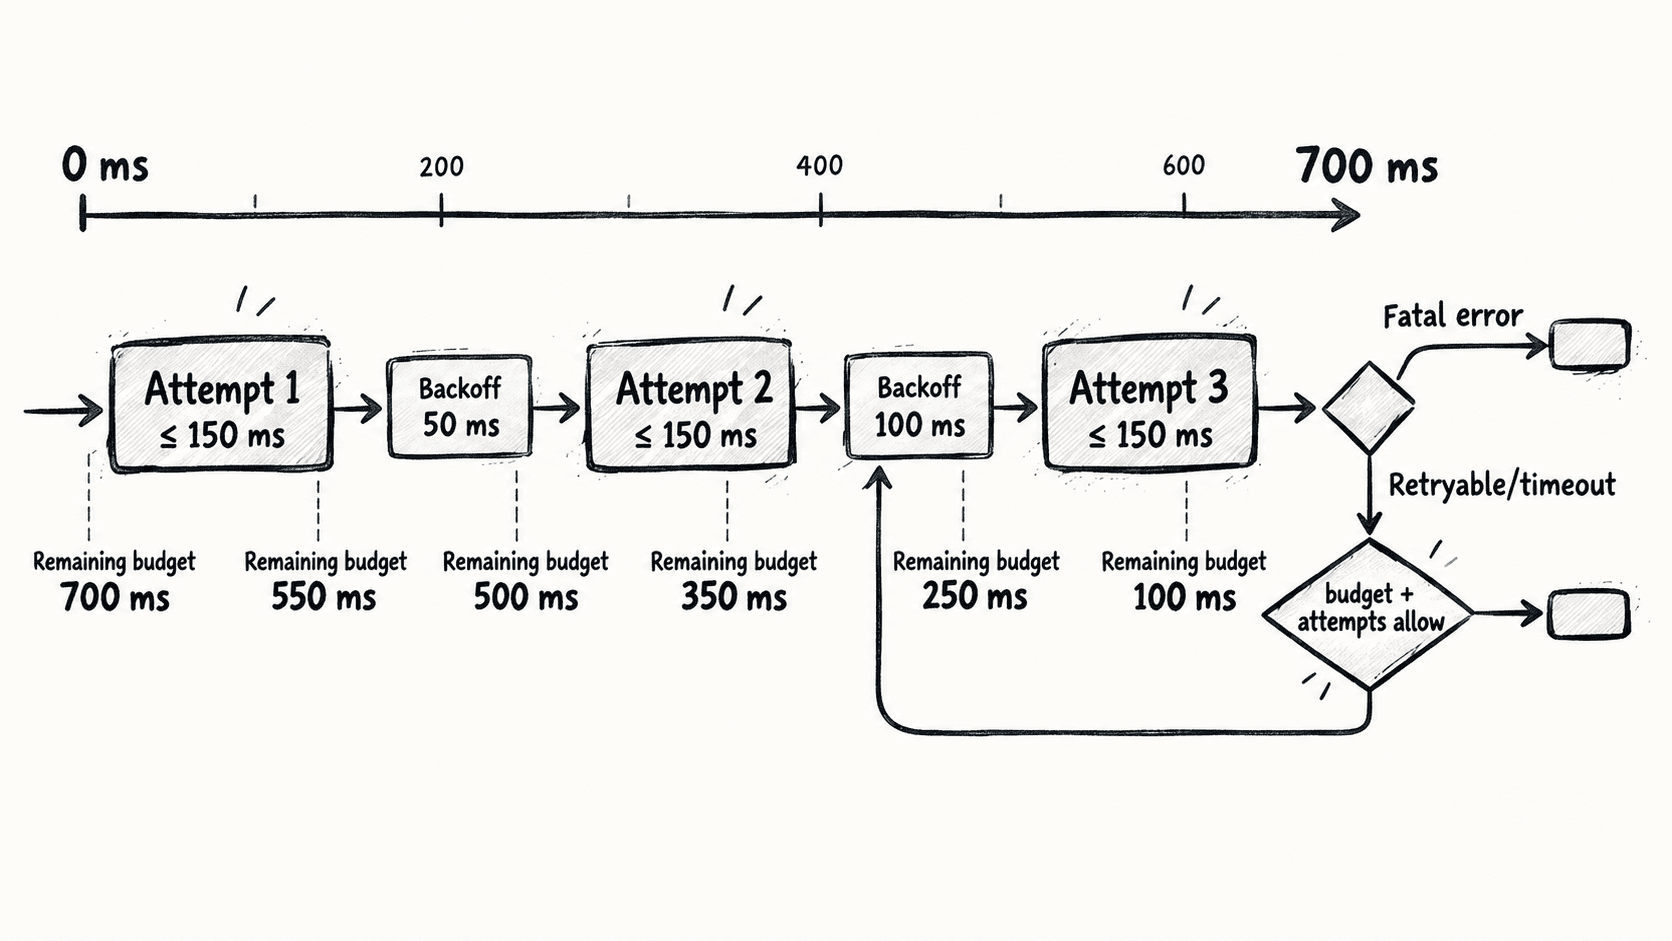
假设调用方只愿意为一次请求等待 700 ms,那么第一次调用、后续重试和退避等待都必须从这 700 ms 中扣除。只设置“每次 150 ms 超时 + 最多 4 次尝试”并不能保证总耗时,因为三次退避也会继续占用时间。
实现时先计算一个固定截止时间 deadline。每次尝试前重新读取剩余时间,再取 min(单次上限, 剩余预算) 作为本次超时。这样即使前面的尝试变慢,后面的调用也只能使用尚未消耗的预算。
先判断错误能不能重试
网络抖动、短暂过载或单次超时可能值得重试;参数错误、认证失败、协议语义错误等确定性失败通常应立即返回。更重要的是,自动重试必须建立在操作可安全重复的前提上:如果请求可能已经在远端产生副作用,就需要幂等键或业务去重,不能因为本地超时就盲目再次提交。
下面的示例假设调用是幂等的。为了让输出可复现,退避使用 50、100、200 ms 的指数序列而不加入随机抖动;生产环境通常会在退避上增加 jitter,减少大量客户端同时重试形成的尖峰。
用 Tokio 组合截止时间、超时和退避
示例项目可使用下面的完整 Cargo.toml。time 提供 sleep 与 timeout,macros 和 rt-multi-thread 用于异步入口。
[package]
name = "retry-budget-demo"
version = "0.1.0"
edition = "2021"

[dependencies]
tokio = { version = "1", features = ["macros", "rt-multi-thread", "time"] }
配置生效后,保存下面代码为 src/main.rs。max_attempts = 4 表示首次调用加最多三次重试;每次开始前都重新计算剩余预算。
use tokio::time::{sleep, timeout, Duration, Instant};

#[derive(Debug)]
enum AttemptError {
    Retryable(&'static str),
    Fatal(&'static str),
}

#[derive(Debug)]
enum CallError {
    Fatal,
    BudgetExhausted,
    RetryLimit,
}

async fn flaky_call(attempt: usize) -> Result<&'static str, AttemptError> {
    // 第二次调用故意慢于单次 150 ms 上限,用来触发 timeout。
    let delay_ms = if attempt == 2 { 200 } else { 80 };
    sleep(Duration::from_millis(delay_ms)).await;

    match attempt {
        1 => Err(AttemptError::Retryable("temporary upstream error")),
        99 => Err(AttemptError::Fatal("invalid request")),
        _ => Ok("ok"),
    }
}

fn backoff_for(attempt: usize) -> Duration {
    // 教学示例固定退避,便于验证;生产环境通常再加入随机抖动。
    let shift = (attempt - 1).min(2) as u32;
    Duration::from_millis(50 * (1_u64 << shift))
}

async fn call_with_budget(
    total_budget: Duration,
    per_attempt: Duration,
    max_attempts: usize,
) -> Result<&'static str, CallError> {
    let deadline = Instant::now() + total_budget;

    for attempt in 1..=max_attempts {
        let remaining = deadline.saturating_duration_since(Instant::now());
        if remaining.is_zero() {
            return Err(CallError::BudgetExhausted);
        }

        // 单次调用不能越过整次请求的截止时间。
        let attempt_budget = per_attempt.min(remaining);
        let retry_reason = match timeout(attempt_budget, flaky_call(attempt)).await {
            Ok(Ok(value)) => {
                println!("attempt {attempt}: success");
                return Ok(value);
            }
            Ok(Err(AttemptError::Fatal(reason))) => {
                println!("attempt {attempt}: fatal: {reason}");
                return Err(CallError::Fatal);
            }
            Ok(Err(AttemptError::Retryable(reason))) => reason,
            Err(_) => "attempt timeout",
        };

        if attempt == max_attempts {
            return Err(CallError::RetryLimit);
        }

        let delay = backoff_for(attempt);
        let remaining = deadline.saturating_duration_since(Instant::now());
        if remaining <= delay {
            return Err(CallError::BudgetExhausted);
        }

        println!(
            "attempt {attempt}: {retry_reason}; backoff {} ms",
            delay.as_millis()
        );
        sleep(delay).await;
    }

    unreachable!()
}

#[tokio::main]
async fn main() {
    let result = call_with_budget(
        Duration::from_millis(700),
        Duration::from_millis(150),
        4,
    )
    .await;

    match result {
        Ok(value) => println!("final: {value}"),
        Err(error) => println!("final error: {error:?}"),
    }
}
预期输出(执行 cargo run --quiet):
attempt 1: temporary upstream error; backoff 50 ms
attempt 2: attempt timeout; backoff 100 ms
attempt 3: success
final: ok把预算规则放到调用链入口
总预算应尽量由最上层请求入口决定,再向下游传递截止时间或剩余预算;否则每一层都重新给自己一份完整超时,会让端到端延迟失控。单次超时应明显小于总预算,并为排队、退避和上层收尾留出空间。
timeout 超时会停止继续等待被包装的 Future,但不能证明远端操作没有发生。因此真正可靠的重试策略同时需要有限次数、总时间预算、错误分类和幂等设计;四者缺一,重试都可能从容错手段变成新的故障放大器。