
Rust / 系统课时
处理 TCP 消息分帧
处理 TCP 消息分帧
TCP 只提供可靠、有序的字节流,不保留应用消息边界。本节用 4 字节长度前缀实现分帧器,让读取逻辑能正确处理半包、一次读到多帧以及恶意声明超长帧,并通过内存双工流复现这些情况。
学习目标
- 解释为什么一次 TCP
read不能等同于收到一条完整消息 - 使用长度前缀和缓冲区解析不完整帧与连续多帧
- 在读取正文前限制最大帧长度,避免无界内存占用
TCP 字节流为什么需要分帧
发送端连续写入两条消息时,接收端看到的只是按顺序到达的字节。一次读取可能只拿到长度字段的一部分,也可能拿到第一帧和第二帧的全部内容,因此不能把“本次读取返回的字节”直接当成一条业务消息。
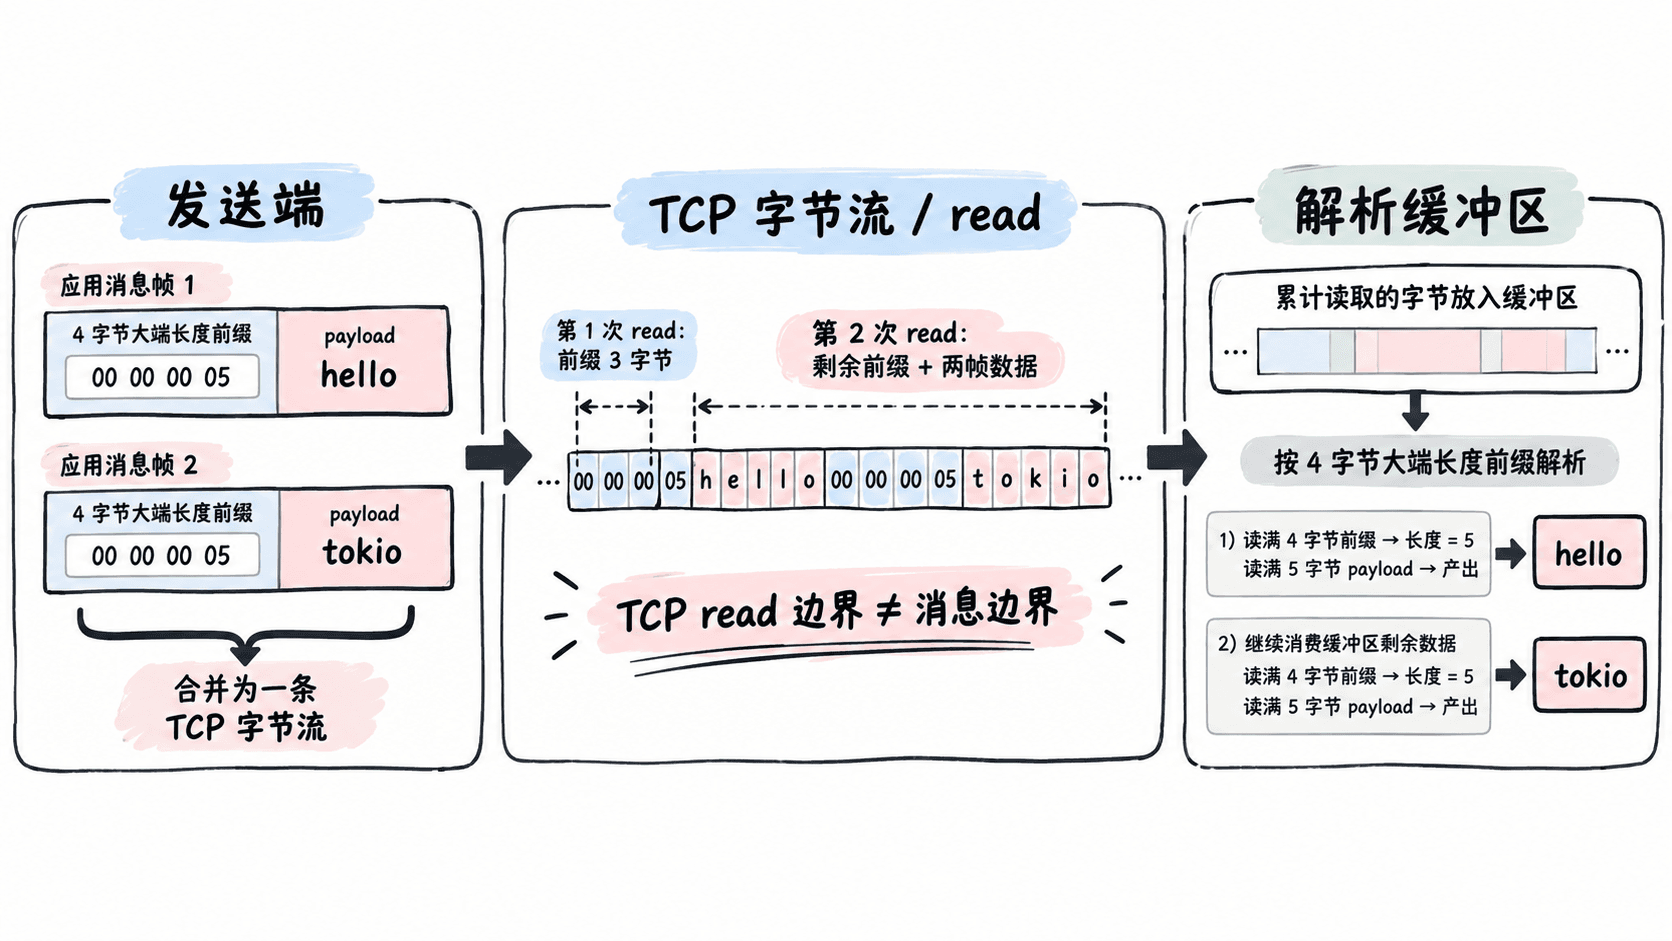
长度前缀协议可定义为“4 字节大端无符号整数 + 指定长度的 payload”。解析器先等齐 4 字节,再读取声明长度;数据不够时保留缓冲区并等待后续字节,数据足够时只取出一帧,剩余字节继续供下一次解析。
实现长度前缀解析器
下面示例使用 tokio::io::duplex 模拟一个 TCP 式字节流。发送端故意先只写 3 字节,让接收端遇到不完整长度字段,再一次写入剩余数据;接收端仍能稳定解析出两帧。
项目依赖如下。bytes 提供适合网络缓冲区拆分的 BytesMut,Tokio 提供异步读写与运行时。
[package]
name = "tcp-framing-demo"
version = "0.1.0"
edition = "2024"

[dependencies]
bytes = "1"
tokio = { version = "1", features = ["macros", "rt-multi-thread", "io-util"] }
核心分帧逻辑放在 src/main.rs 中,并让读取函数先尝试解析已有缓冲区,再按需继续读取字节:
use bytes::{Buf, BytesMut};
use std::io;
use tokio::io::{AsyncRead, AsyncReadExt, AsyncWriteExt};

const MAX_FRAME: usize = 1024;

fn encode(payload: &[u8]) -> Vec<u8> {
    let mut out = Vec::with_capacity(4 + payload.len());
    out.extend_from_slice(&(payload.len() as u32).to_be_bytes());
    out.extend_from_slice(payload);
    out
}

fn try_decode(buf: &mut BytesMut) -> io::Result<Option<Vec<u8>>> {
    if buf.len() < 4 {
        return Ok(None);
    }

    let len = u32::from_be_bytes(buf[..4].try_into().unwrap()) as usize;
    // 在等待 payload 前拒绝异常长度,避免攻击者诱导缓冲区持续增长。
    if len > MAX_FRAME {
        return Err(io::Error::new(
            io::ErrorKind::InvalidData,
            "frame is too large",
        ));
    }
    if buf.len() < 4 + len {
        return Ok(None);
    }

    buf.advance(4);
    Ok(Some(buf.split_to(len).to_vec()))
}

async fn read_next<R: AsyncRead + Unpin>(
    reader: &mut R,
    buf: &mut BytesMut,
) -> io::Result<Option<Vec<u8>>> {
    loop {
        // 先消费缓冲区;其中可能已经保存了上一轮读取带回来的下一帧。
        if let Some(frame) = try_decode(buf)? {
            return Ok(Some(frame));
        }

        let n = reader.read_buf(buf).await?;
        if n == 0 {
            return if buf.is_empty() {
                Ok(None)
            } else {
                Err(io::Error::new(
                    io::ErrorKind::UnexpectedEof,
                    "connection closed in the middle of a frame",
                ))
            };
        }
    }
}

#[tokio::main]
async fn main() -> io::Result<()> {
    let (mut client, mut server) = tokio::io::duplex(64);

    let writer = tokio::spawn(async move {
        let mut wire = encode(b"hello");
        wire.extend_from_slice(&encode(b"tokio"));

        // 故意切在长度字段内部,模拟一次读取拿不到完整帧。
        client.write_all(&wire[..3]).await?;
        tokio::task::yield_now().await;
        client.write_all(&wire[3..]).await?;
        Ok::<_, io::Error>(())
    });

    let mut buf = BytesMut::with_capacity(64);
    while let Some(frame) = read_next(&mut server, &mut buf).await? {
        println!("frame={}", String::from_utf8_lossy(&frame));
    }

    writer.await.unwrap()?;
    Ok(())
}
预期输出
frame=hello
frame=tokio
实际网络调度决定每次底层读取拿到多少字节,但输出的帧边界不应因此改变。这里的 try_decode 一次最多产出一帧,并把后续帧留在 BytesMut 中,因此一次读取拿到多帧也不会丢数据。
处理超长帧与异常关闭
最大帧限制必须在信任长度字段之前执行。若对端声明长度大于 MAX_FRAME,应立即返回协议错误并通常关闭连接,而不是按照该长度继续扩容或等待正文。真实服务还应根据业务协议选择合理上限,而不是简单把限制设得非常大。
连接在完整帧之间正常关闭时,可以把 EOF 解释为消息流结束;如果缓冲区里还残留半个长度字段或半个 payload,则属于截断帧,应返回 UnexpectedEof。这两个状态不能混为一谈,否则协议损坏会被误当成正常结束。
长度前缀还是分隔符
长度前缀适合任意二进制 payload,解析时无需扫描正文;代价是双方必须约定长度字段大小、字节序以及“长度是否包含头部”。分隔符协议更适合天然按行组织的文本,例如以换行结束的命令,但正文若允许出现分隔符,就需要转义或更高层编码。
无论选择哪一种方式,分帧器都要满足同一条原则:输入可以任意分块,输出必须只按应用协议边界产生消息。同时给帧长度设置明确上限,才能把网络流量边界转化成可控的内存边界。