
消息队列 / 系统课时
消息积压排查
消息积压排查
本课给出一条可重复执行的积压定位路径:先同时观察生产速率、消费确认速率、Ready、Unacked 和消费者数量,再判断瓶颈发生在生产突增、消费者不足、单条处理变慢还是连接与节点异常,最后用指标回落验证修复。
学习目标
- 用生产、确认、Ready、Unacked 和消费者状态判断积压属于哪一类问题。
- 按固定顺序排查消费者、下游依赖、连接与 Broker 状态,避免只靠“加并发”猜问题。
- 在恢复期间控制并发和 prefetch,并用可量化条件确认积压正在消退。
先判断积压发生在哪一段
积压最直接的现象是 messages_ready 持续增加,但它只说明“可投递消息还没被消费”,并不能单独说明根因。排查时至少把生产速率、确认速率、Ready、Unacked 和消费者数量放在同一个观察窗口里。
如果启用了 management plugin,可以直接读取目标队列的运行统计。下面假设 vhost 为 /、队列为 orders.work;默认 vhost 在 URL 中编码为 %2F。
curl -su '<USER>:<PASSWORD>' 'http://localhost:15672/api/queues/%2F/orders.work' | jq '{
  name,
  messages_ready,
  messages_unacknowledged,
  consumers,
  state,
  publish_rate: (.message_stats.publish_details.rate // 0),
  deliver_rate: (.message_stats.deliver_get_details.rate // 0),
  ack_rate: (.message_stats.ack_details.rate // 0)
}'
预期输出
{
  "name": "orders.work",
  "messages_ready": "<VALUE>",
  "messages_unacknowledged": "<VALUE>",
  "consumers": "<VALUE>",
  "state": "running",
  "publish_rate": "<VALUE>",
  "deliver_rate": "<VALUE>",
  "ack_rate": "<VALUE>"
}
实际速率和数量会随时间变化。观察重点不是某个瞬时值,而是连续几个采样周期中的趋势:如果生产速率长期大于 ACK 速率,Ready 通常会继续增长;只有当 ACK 速率持续追上并超过生产速率,历史积压才会开始下降。
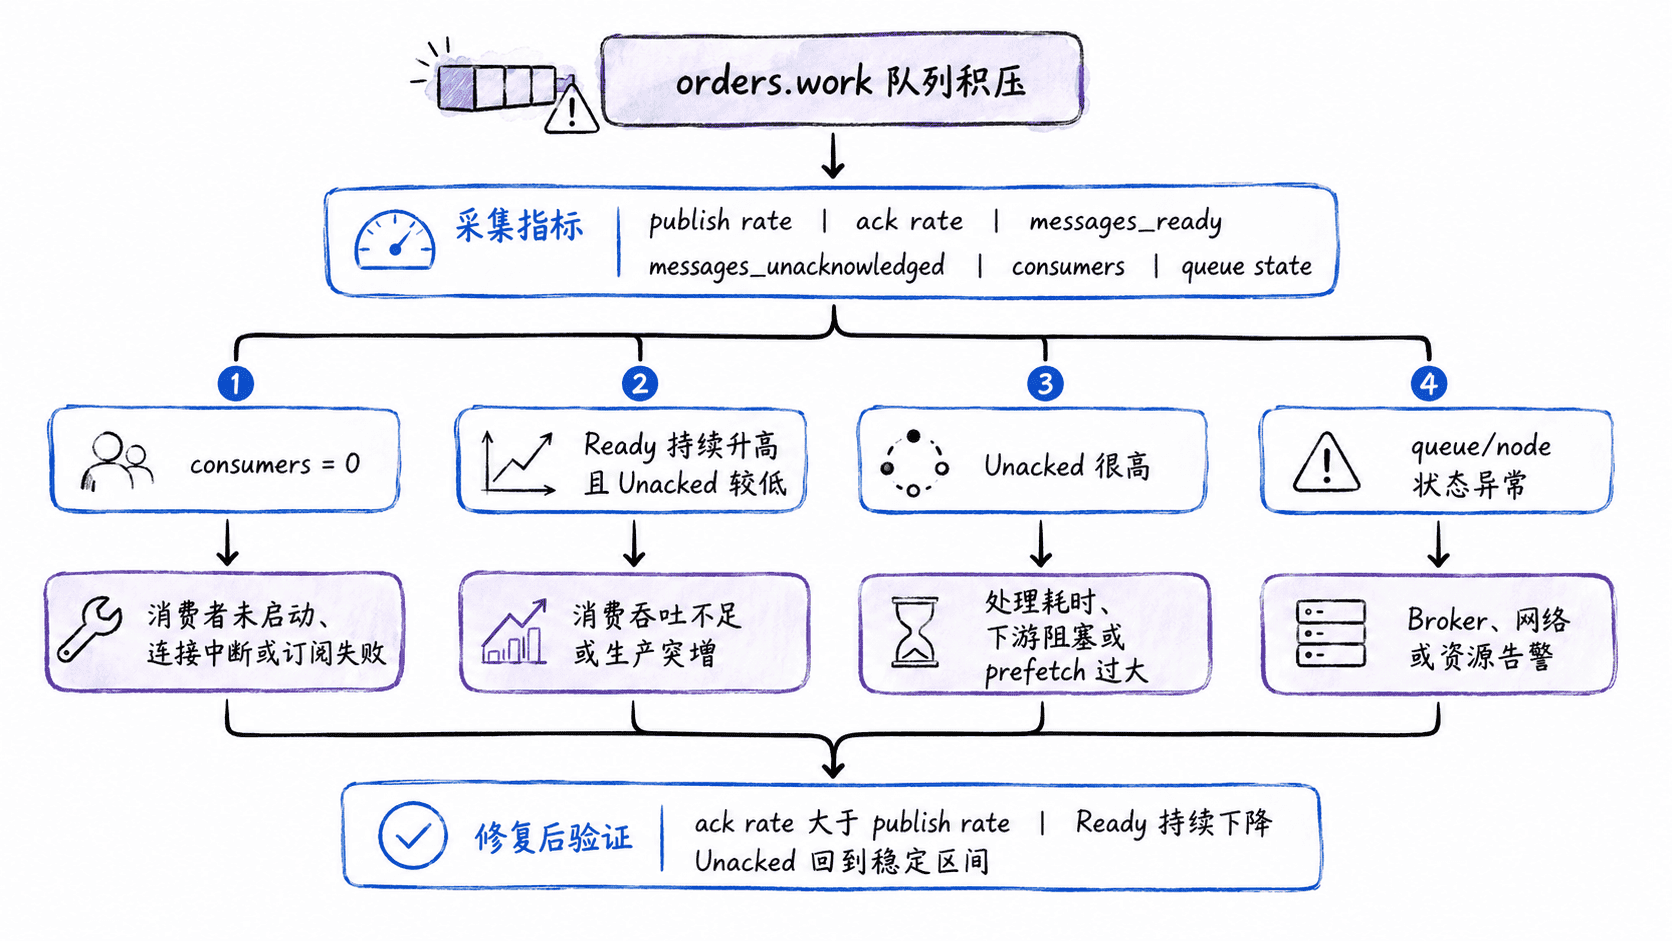
用四组信号缩小根因
| 观察组合 | 更可能的原因 | 下一步 |
|---|---|---|
consumers=0,Ready 上升 |
消费者未启动、连接断开、订阅失败 | 先查进程、连接和消费注册 |
| Ready 上升,Unacked 较低,消费者存在 | 总消费吞吐不足,或生产流量突然放大 | 比较 publish 与 ack rate,再查处理耗时 |
| Unacked 长期很高 | 单条处理慢、下游阻塞、线程卡住,或 prefetch 过大 | 查消费者日志、线程池、数据库与外部接口 |
| publish rate 突然升高,ack rate 基本不变 | 上游流量突增或批量补数据 | 判断是否预期流量,并评估扩容或限流 |
| 队列状态异常或多个队列同时恶化 | Broker、网络、磁盘、内存等公共依赖异常 | 转向节点和资源健康检查 |
检查消费者与节点状态
先用 CLI 确认队列层面的 Ready、Unacked、消费者数量和状态。若管理 API 不可用,这组字段仍能快速判断消费者是否实际挂在队列上。
rabbitmqctl list_queues -p / name messages_ready messages_unacknowledged consumers state预期输出
name         messages_ready  messages_unacknowledged  consumers  state
orders.work  <VALUE>         <VALUE>                  <VALUE>    running
如果 consumers 为 0,优先检查应用是否存活、是否连到了正确 vhost、队列名是否一致、权限是否足够,以及消费者启动是否报错。若消费者存在但 Unacked 长时间不回落,应转向应用侧线程、数据库连接池、外部 HTTP 调用和手动 ACK 路径,而不是继续盯着 RabbitMQ 队列本身。
再确认本节点能够正常响应。下面把诊断命令的原始输出隐藏,只用退出码得到稳定结果。
rabbitmq-diagnostics -q ping >/dev/null && echo broker_ping_ok预期输出
broker_ping_ok如果这里失败,先处理节点、网络或服务进程问题;如果 Broker 正常而多个消费者同时变慢,才继续检查共享的数据库、缓存、下游 API 或宿主机资源。
恢复积压时先治原因再提并发
当根因是消费能力不足时,可以增加消费者实例或并发数,但扩容前要确认下游能够承受更大的并发。否则队列里的压力只是从 RabbitMQ 转移到数据库、缓存或第三方接口,最终表现为更多超时和更高 Unacked。
prefetch 也应配合单条消息耗时调整。值过小会让消费者频繁等待投递,值过大则会让大量消息被某个慢消费者占在 Unacked 中。恢复阶段更重要的是让 ACK 速率稳定提高,而不是单纯追求更大的预取窗口。
如果积压来自一次可预期的生产突增,可以临时扩容消费者并观察下游负载;如果是单条处理变慢,应先优化慢查询、外部调用超时、锁竞争或线程池阻塞。只有根因被处理后,扩容才会真正缩短清空时间。
用趋势确认已经恢复
恢复不是看到 Ready 降了一次就结束。至少连续观察几个采样周期,并确认三个条件同时成立:ack_rate 不再长期低于 publish_rate;messages_ready 持续下降或回到日常基线;messages_unacknowledged 回到稳定区间而不是持续攀升。
如果生产流量仍在持续进入,理想状态是 ACK 速率先高于生产速率,直到历史积压清空,再回到两者大致平衡。消费者数量、prefetch 或实例数的调整也要逐步进行,每次只改一类变量,这样才能判断是哪项修改真正改善了吞吐。
排查积压的核心不是记住一条“万能扩容命令”,而是建立固定证据链:先看流量差,再看 Ready 与 Unacked 的位置,再看消费者与节点健康,最后用同一组指标证明积压确实在消退。