
消息队列 / 系统课时
内存与磁盘保护
内存与磁盘保护
本课把 RabbitMQ 的两类资源保护串成一条可操作链路:识别内存高水位和磁盘低水位,配置合理阈值,理解资源告警如何阻塞发布连接,并用诊断命令确认告警已经解除。
学习目标
- 理解内存水位和磁盘剩余空间限制分别保护什么资源。
- 配置可持久化的绝对阈值,并知道默认值的适用边界。
- 区分资源告警阻塞与普通
flow流控,完成集群级告警验证。
资源水位如何阻止失控写入
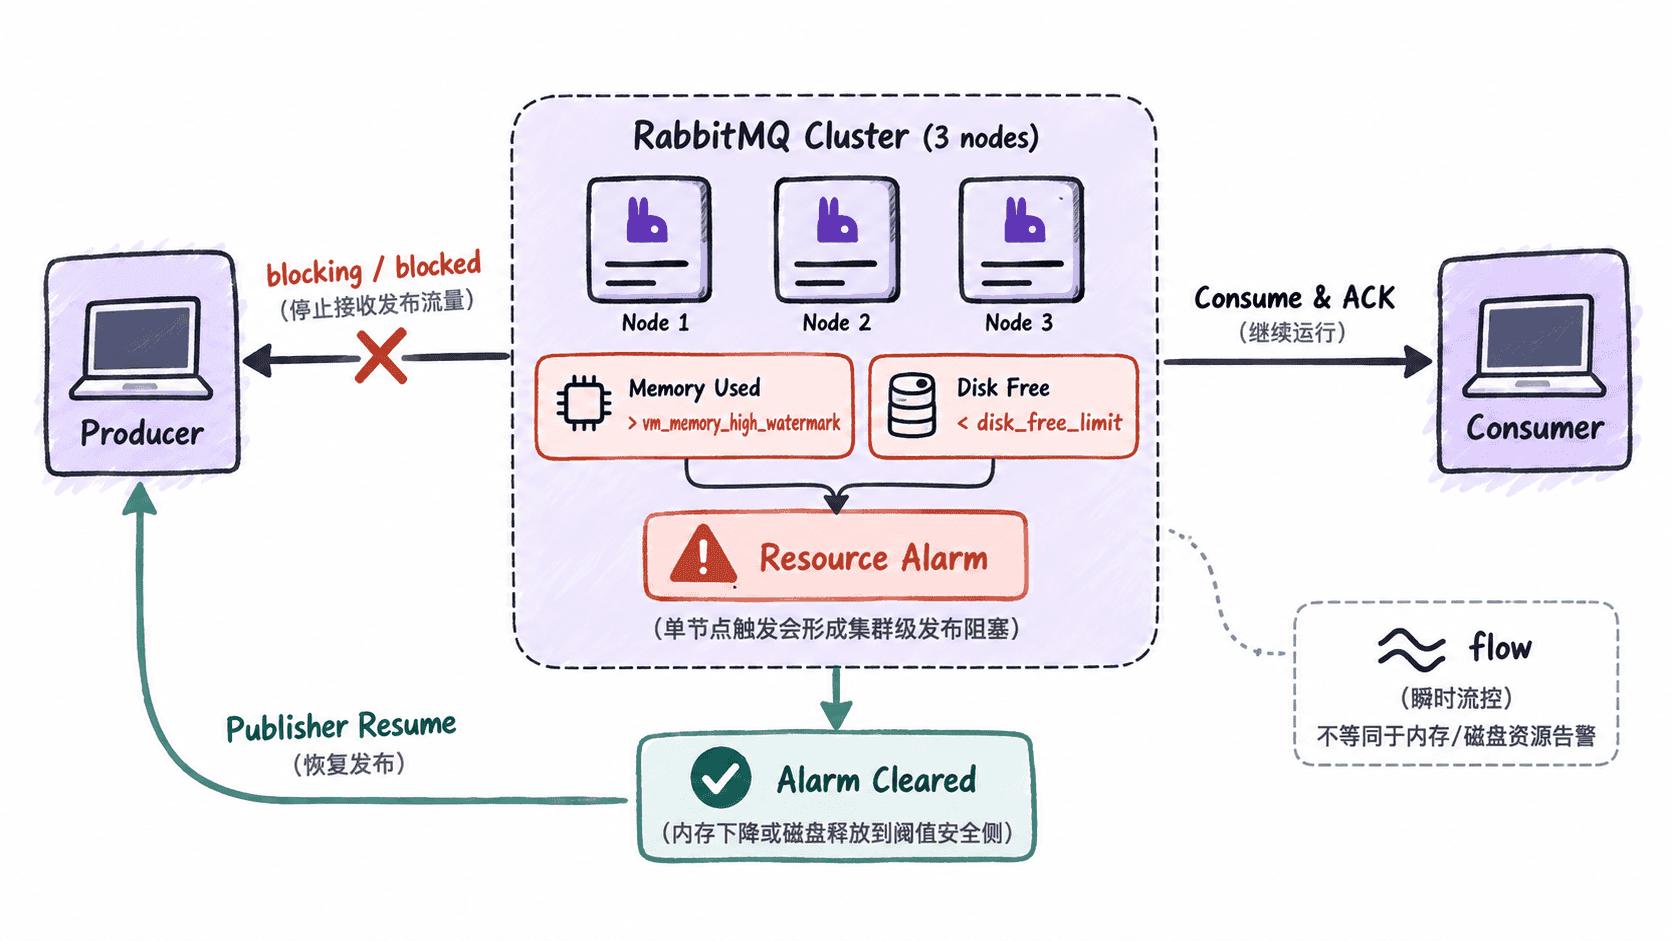
RabbitMQ 的内存阈值不是硬性内存上限,而是触发背压的水位。节点内存超过高水位后会产生 memory alarm;数据库所在磁盘的剩余空间低于 disk_free_limit 后会产生 disk alarm。任一资源告警出现时,集群会阻塞发布连接,让消费者继续消费和确认消息,以便释放内存或减少积压。
默认情况下,内存高水位约为 RabbitMQ 检测到可用内存的 60%,磁盘低水位默认是 50 MB。它们是通用兜底值,不等于生产环境的合理容量规划;尤其磁盘阈值过低时,突发分页或持久化写入仍可能在告警反应前耗尽空间。
配置可解释的绝对阈值
生产环境更适合把阈值写进 rabbitmq.conf,让节点重启后仍保持一致。容器环境尤其建议使用绝对内存阈值,因为 RabbitMQ 对“可用总内存”的检测结果可能受 cgroup 和运行环境影响。下面的数值只是示例,应按容器限制、消息峰值、磁盘容量和恢复时间预算重新计算。
vm_memory_high_watermark.absolute = 2Gi
disk_free_limit.absolute = 5GB
该配置表示:节点内存达到 2 GiB 左右时进入内存保护,数据库分区可用空间低于 5 GB 时进入磁盘保护。修改持久配置后,应按现有部署方式滚动重启或重载节点,并逐节点核对生效值;不要只用运行时命令临时修改后就认为配置已经永久保存。
如果必须临时调试,可以使用 rabbitmqctl set_vm_memory_high_watermark 或 rabbitmqctl set_disk_free_limit 修改运行节点,但故障处理完成后仍应把最终值固化到配置管理中,避免下次重启回到旧值。
发布连接被阻塞时会发生什么
资源告警的目标是减慢或停止新消息进入,而不是停止整个 Broker。只发布的连接会被背压;消费者连接仍可继续接收消息并发送 ACK。支持 RabbitMQ blocked-connection 扩展的客户端还能收到 connection.blocked 与 connection.unblocked 通知,因此生产者应有超时、失败处理和 publisher confirm 逻辑,不能把一次 publish 返回当作消息必然已经被 Broker 接纳。
还要区分连接状态中的 flow。flow 是 RabbitMQ 在内部组件跟不上发布速度时执行的短周期流控,可能一秒内多次阻塞和恢复;memory alarm 或 disk alarm 则是资源水位触发的保护状态。看到发布延迟时,应先查告警,而不是仅凭 flow 判断节点已经耗尽资源。
验证集群已经退出保护状态
RabbitMQ 提供集群级资源告警健康检查。下面的脚本在没有任何节点处于资源告警时输出成功;只要任一节点仍有 memory 或 disk alarm,就返回非零退出码,适合放进运维验收或健康检查流程。
if rabbitmq-diagnostics -q check_alarms >/dev/null; then
  echo "cluster resource alarms: none"
else
  echo "cluster resource alarms: active"
  exit 1
fi
预期输出
cluster resource alarms: none如果仍为 active,应继续释放对应资源并检查触发节点,而不是反复重启 Broker。内存问题优先看队列积压、Unacked、连接与 Erlang 进程占用;磁盘问题优先确认 RabbitMQ 数据目录所在分区、消息堆积和其他进程占盘。只有实际资源回到安全侧并且告警清除后,发布连接才会恢复正常接收流量。