
消息队列 / 系统课时
失败重试与人工处理
失败重试与人工处理
本课把“消费失败后怎么办”落成一个可验收的闭环:可恢复错误进入分级自动重试,超过上限或不可恢复错误进入最终失败队列,同时留下异常记录,并通过受控入口完成人工补偿。
学习目标
- 设计不会无限回队的自动重试链路,并明确重试次数与等待时间。
- 建立最终失败队列与异常记录,确保失败消息可追踪、可审计。
- 设计人工补偿入口,使重新投递具备幂等保护和可验证结果。
先定失败处理闭环
消费失败不能直接统一使用 requeue=true。如果根因持续存在,消息会快速回到原队列并再次被同一批消费者拿到,形成高频重投、CPU 空转和日志洪泛。更稳妥的做法是把失败分成“可重试”和“不可重试”两类,并给可重试错误设置有限次数和递增等待时间。
一个最小闭环可以采用两级等待:第一次失败等待 10 秒,第二次失败等待 60 秒;再次失败则进入最终失败队列。应用使用自定义消息头 retry-count 记录主动重试次数,RabbitMQ 的 x-death 只作为死信历史参考,不把两者混成同一个业务计数器。
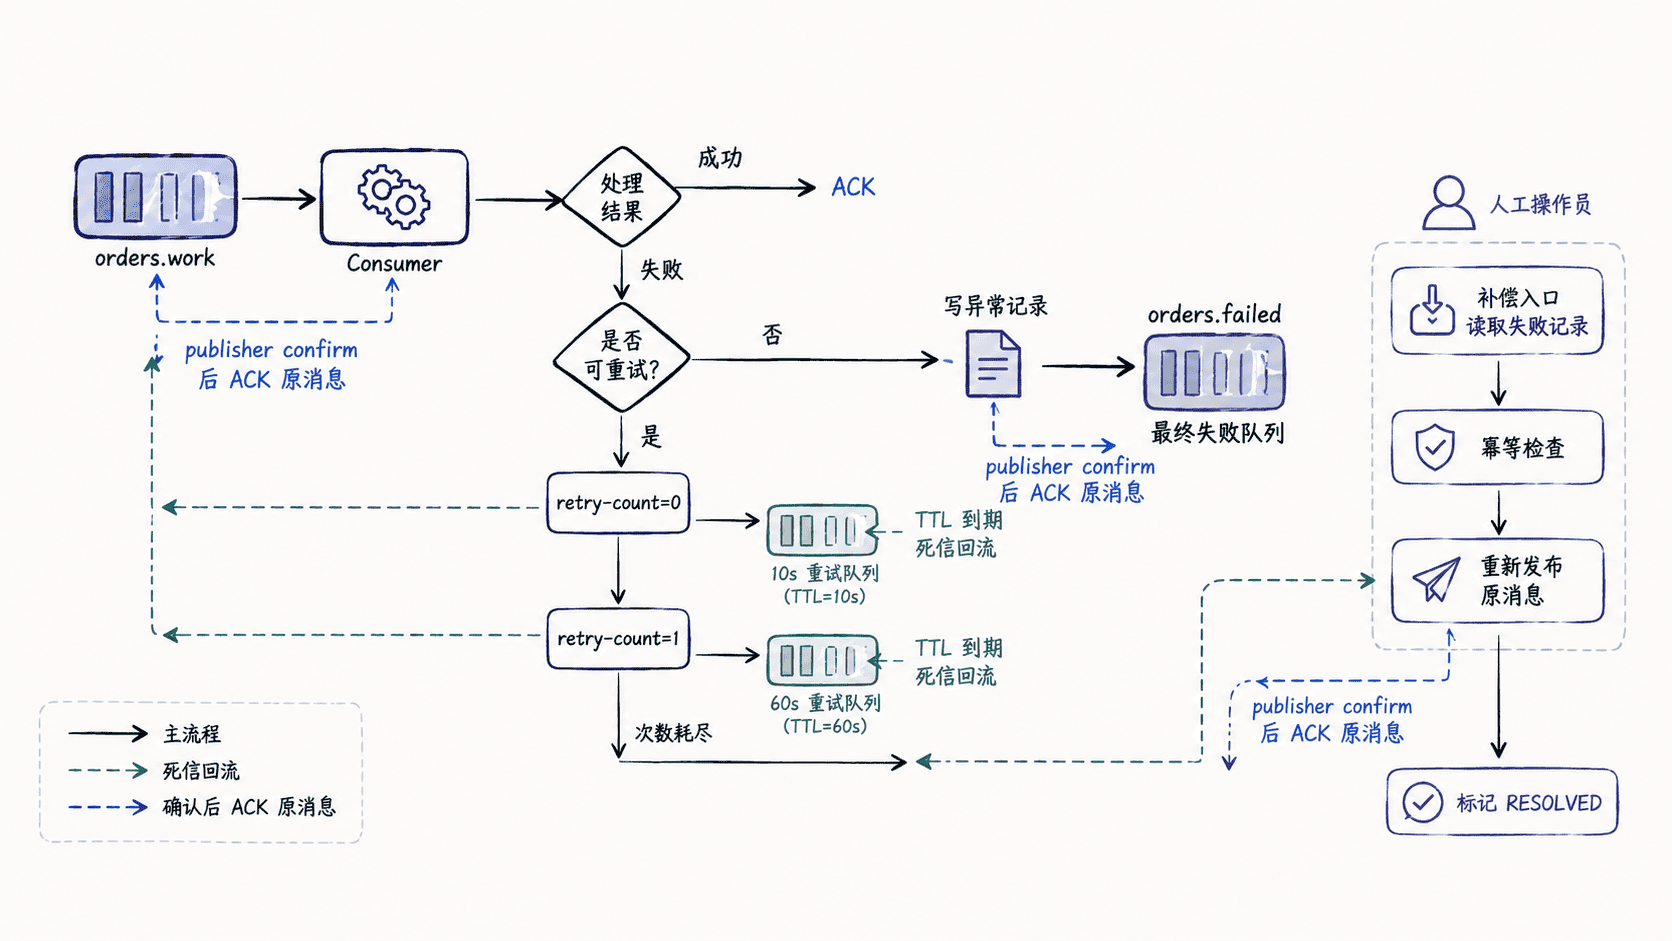
建立重试与最终失败拓扑
下面用 RabbitMQ definitions 描述最小拓扑。两个重试队列都没有业务消费者,而是依靠 TTL 到期后通过 dead-letter exchange 回到工作交换机。最终失败队列只接收已经停止自动重试的消息,供告警、审计和人工处理使用。
{
  "exchanges": [
    {"name": "orders.work.x", "vhost": "/", "type": "direct", "durable": true, "auto_delete": false, "internal": false, "arguments": {}},
    {"name": "orders.retry.x", "vhost": "/", "type": "direct", "durable": true, "auto_delete": false, "internal": false, "arguments": {}},
    {"name": "orders.failed.x", "vhost": "/", "type": "direct", "durable": true, "auto_delete": false, "internal": false, "arguments": {}}
  ],
  "queues": [
    {"name": "orders.work", "vhost": "/", "durable": true, "auto_delete": false, "arguments": {}},
    {"name": "orders.retry.10s", "vhost": "/", "durable": true, "auto_delete": false, "arguments": {"x-message-ttl": 10000, "x-dead-letter-exchange": "orders.work.x", "x-dead-letter-routing-key": "orders.work"}},
    {"name": "orders.retry.60s", "vhost": "/", "durable": true, "auto_delete": false, "arguments": {"x-message-ttl": 60000, "x-dead-letter-exchange": "orders.work.x", "x-dead-letter-routing-key": "orders.work"}},
    {"name": "orders.failed", "vhost": "/", "durable": true, "auto_delete": false, "arguments": {}}
  ],
  "bindings": [
    {"source": "orders.work.x", "vhost": "/", "destination": "orders.work", "destination_type": "queue", "routing_key": "orders.work", "arguments": {}},
    {"source": "orders.retry.x", "vhost": "/", "destination": "orders.retry.10s", "destination_type": "queue", "routing_key": "retry.10s", "arguments": {}},
    {"source": "orders.retry.x", "vhost": "/", "destination": "orders.retry.60s", "destination_type": "queue", "routing_key": "retry.60s", "arguments": {}},
    {"source": "orders.failed.x", "vhost": "/", "destination": "orders.failed", "destination_type": "queue", "routing_key": "orders.failed", "arguments": {}}
  ]
}
把文件保存为 <PATH>/retry-definitions.json 后导入。这里把命令自身的输出隐藏,只检查退出码,因此验证结果稳定。
rabbitmqctl import_definitions <PATH>/retry-definitions.json >/dev/null && echo import_ok预期输出
import_ok配置生效后,orders.retry.10s 和 orders.retry.60s 中的消息在各自 TTL 到期后会重新路由到 orders.work。生产环境更适合用 policy 管理可变参数;本例把参数写进 definitions,是为了把项目所需的最小拓扑一次展示完整。
消费失败时推进重试状态
消费者处理一条消息时,应先完成业务逻辑,再决定 ACK 还是转存。可重试错误例如下游临时超时、短暂连接失败;不可重试错误例如业务字段永久非法、目标实体不存在且不会补齐。分类规则要由业务定义,而不是只按异常类名机械判断。
处理顺序保持固定:
- 业务成功时直接 ACK。
- 业务失败且可重试时,读取
retry-count;值为 0 发布到retry.10s,值为 1 发布到retry.60s,并在新消息中把计数加一。 - 重试消息收到 publisher confirm 后,再 ACK 当前原消息;发布失败或 confirm 超时则不要 ACK,让当前消息仍有恢复机会。
- 不可重试或重试次数耗尽时,先落异常记录,再把消息发布到
orders.failed.x;确认成功后 ACK 原消息。
记录异常并提供人工补偿入口
异常记录至少保存 failure_id、原始 event_id、队列或业务类型、retry_count、错误分类、错误摘要、原消息引用、首次失败时间、最后失败时间和处理状态。原始 payload 如果包含敏感数据,不应直接复制进日志;可以保存受控存储中的引用和必要摘要。
人工入口建议采用类似 POST /ops/message-failures/{failureId}/retry 的受控操作,而不是允许操作员任意粘贴一份新消息。服务端根据 failure_id 读取原记录,检查业务幂等键和当前状态,重新发布原事件,并在 publisher confirm 成功后把记录从 WAIT_MANUAL 更新为 RESOLVED;失败则保留原状态和新的错误原因。
人工补偿前必须确认消费者是幂等的。重新投递时保留原 event_id,让消费端能够识别“同一业务事件再次到达”,不要通过生成一个全新业务事件 ID 来绕过去重。
验收失败闭环
验收时至少覆盖四条路径:正常消息一次成功;可重试错误在 10 秒或 60 秒后成功;持续失败最终进入 orders.failed;人工补偿后消息重新进入工作队列并把失败记录标记为已解决。还要故意模拟重试消息发布失败,确认原消息不会被提前 ACK。
可用下面的命令检查三类队列是否都存在,并观察消息数量变化。动态数量会因测试进度不同而变化。
rabbitmqctl list_queues -p / name messages_ready messages_unacknowledged consumers预期输出
name                 messages_ready  messages_unacknowledged  consumers
orders.work          <VALUE>         <VALUE>                  <VALUE>
orders.retry.10s     <VALUE>         <VALUE>                  0
orders.retry.60s     <VALUE>         <VALUE>                  0
orders.failed        <VALUE>         <VALUE>                  <VALUE>
重试队列通常没有消费者;最终失败队列是否配置专用告警消费者取决于项目设计。真正的完成标准不是“失败消息没了”,而是每次失败都有明确去向、有限重试、可追踪记录和可审计的人工作业入口。