
消息队列 / 系统课时
仲裁队列副本
仲裁队列副本
仲裁队列的高可用不是“副本越多越安全”。本课从多数派规则出发,规划每个队列的副本数、成员节点和 leader 分布,并用 RabbitMQ 4.3 的命令验证实际拓扑,避免容量浪费和 leader 热点。
学习目标
- 根据可容忍故障数选择 3、5 等奇数副本规模
- 区分队列成员分布与 leader 分布,理解两者要分别治理
- 使用
rabbitmq-queues检查副本状态并执行 leader 再均衡
先确定每个队列需要几个成员
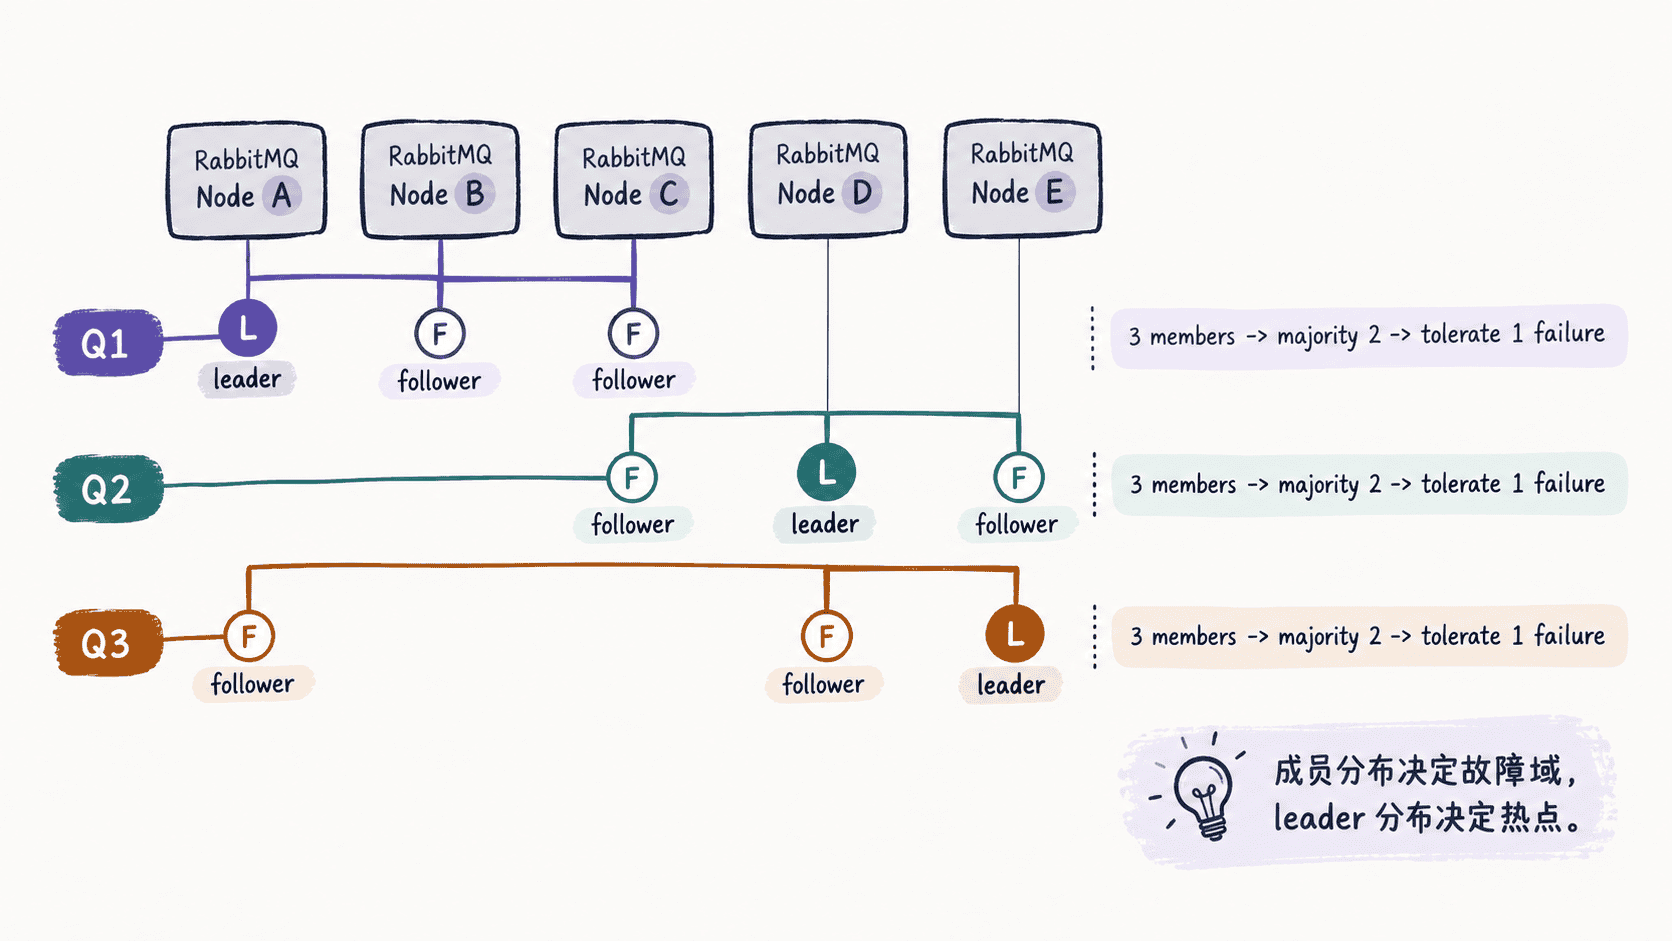
仲裁队列基于 Raft,每个队列由一个 leader 和若干 follower 组成,只有多数成员在线时才能继续工作。3 个成员需要至少 2 个在线,可容忍 1 个成员故障;5 个成员需要至少 3 个在线,可容忍 2 个成员故障。
| 副本数 | 维持多数派所需在线数 | 可容忍同时故障数 | 常见取舍 |
|---|---|---|---|
| 3 | 2 | 1 | 默认且最常用,成本与可用性平衡较好 |
| 5 | 3 | 2 | 需要容忍两个成员故障时使用,写放大和磁盘成本更高 |
| 7 | 4 | 3 | 只在明确需要时采用,不应把“节点多”直接等同于“队列副本多” |
RabbitMQ 默认的仲裁队列组大小是 3。更大的集群并不意味着每个队列都应该复制到全部节点;副本越多,每次写入需要协调的成员越多,也会增加磁盘、网络和 Raft 处理开销。
在声明时确定初始副本数
队列类型必须在声明时设为 quorum。需要覆盖默认组大小时,可以使用 x-quorum-initial-group-size。下面是片段示例:假设 Channel channel 已经建立,代码只展示本课相关的队列参数。
Map<String, Object> arguments = new HashMap<>();
arguments.put("x-queue-type", "quorum");
arguments.put("x-quorum-initial-group-size", 3);

channel.queueDeclare(
    "orders.q",
    true,
    false,
    false,
    arguments
);
该参数决定新队列最初尝试建立多少个成员,默认不会因为以后给 RabbitMQ 集群增加了新节点就自动把现有队列扩成更多副本。新增或退役节点时,应显式调整成员,或在明确理解行为后启用持续成员协调机制。
检查成员与 leader
rabbitmq-queues quorum_status 会列出指定仲裁队列的各个成员及其 Raft 状态。下面命令检查默认虚拟主机中的 orders.q。
rabbitmq-queues quorum_status --vhost / orders.q预期输出
Status of quorum queue orders.q on node <NODE> ...
Node Name        Raft State   Membership
rabbit@rmq-a     leader       voter
rabbit@rmq-b     follower     voter
rabbit@rmq-c     follower     voter
...实际输出还会包含日志索引、提交索引、任期等列,<NODE> 和索引值会随环境变化。验收时重点确认成员数量符合规划、只有一个 leader、其余成员为 follower,并且预期故障域中的节点都在线。
把 leader 热点与成员变更分开处理
成员分布回答“这个队列的数据副本放在哪些节点”,leader 分布回答“哪个节点承担该队列的主处理路径”。两者不是同一件事。大量队列都由同一入口节点创建时,默认的 client-local 策略可能让 leader 偏向少数节点。
新队列可以在 rabbitmq.conf 中使用平衡策略,让 leader 初始位置更分散:
queue_leader_locator = balanced这项配置影响新队列的 leader 位置选择;已有队列 leader 已经失衡时,可以执行再均衡:
rabbitmq-queues rebalance quorum >/dev/null && echo "rebalance exit code=0"预期输出
rebalance exit code=0再均衡只移动 leader,不会把一个 3 成员队列从 A/B/C 改成 C/D/E。若真正需要改变副本所在节点,应使用成员管理命令,并在节点下线前执行 rabbitmq-diagnostics check_if_node_is_quorum_critical 一类的安全检查。规划时把“副本数、成员故障域、leader 热点”分别验收,才能得到可预测的集群行为。