
消息队列 / 系统课时
RabbitMQ Streams
RabbitMQ Streams
RabbitMQ Streams 解决的是“消息需要长期保留并可反复读取”的场景。它把消息组织成追加写入的持久化日志,消费者通过偏移量决定从哪里开始读,因此既能实时消费,也能在保留窗口内回放历史消息。
学习目标
- 理解 Stream 的追加写入、非破坏性消费与普通队列的差异
- 配置按时间或容量保留数据,并选择合适的消费起点
- 判断什么时候应该使用 Stream,而不是 Classic Queue 或 Quorum Queue
Stream 更像可重复读取的日志
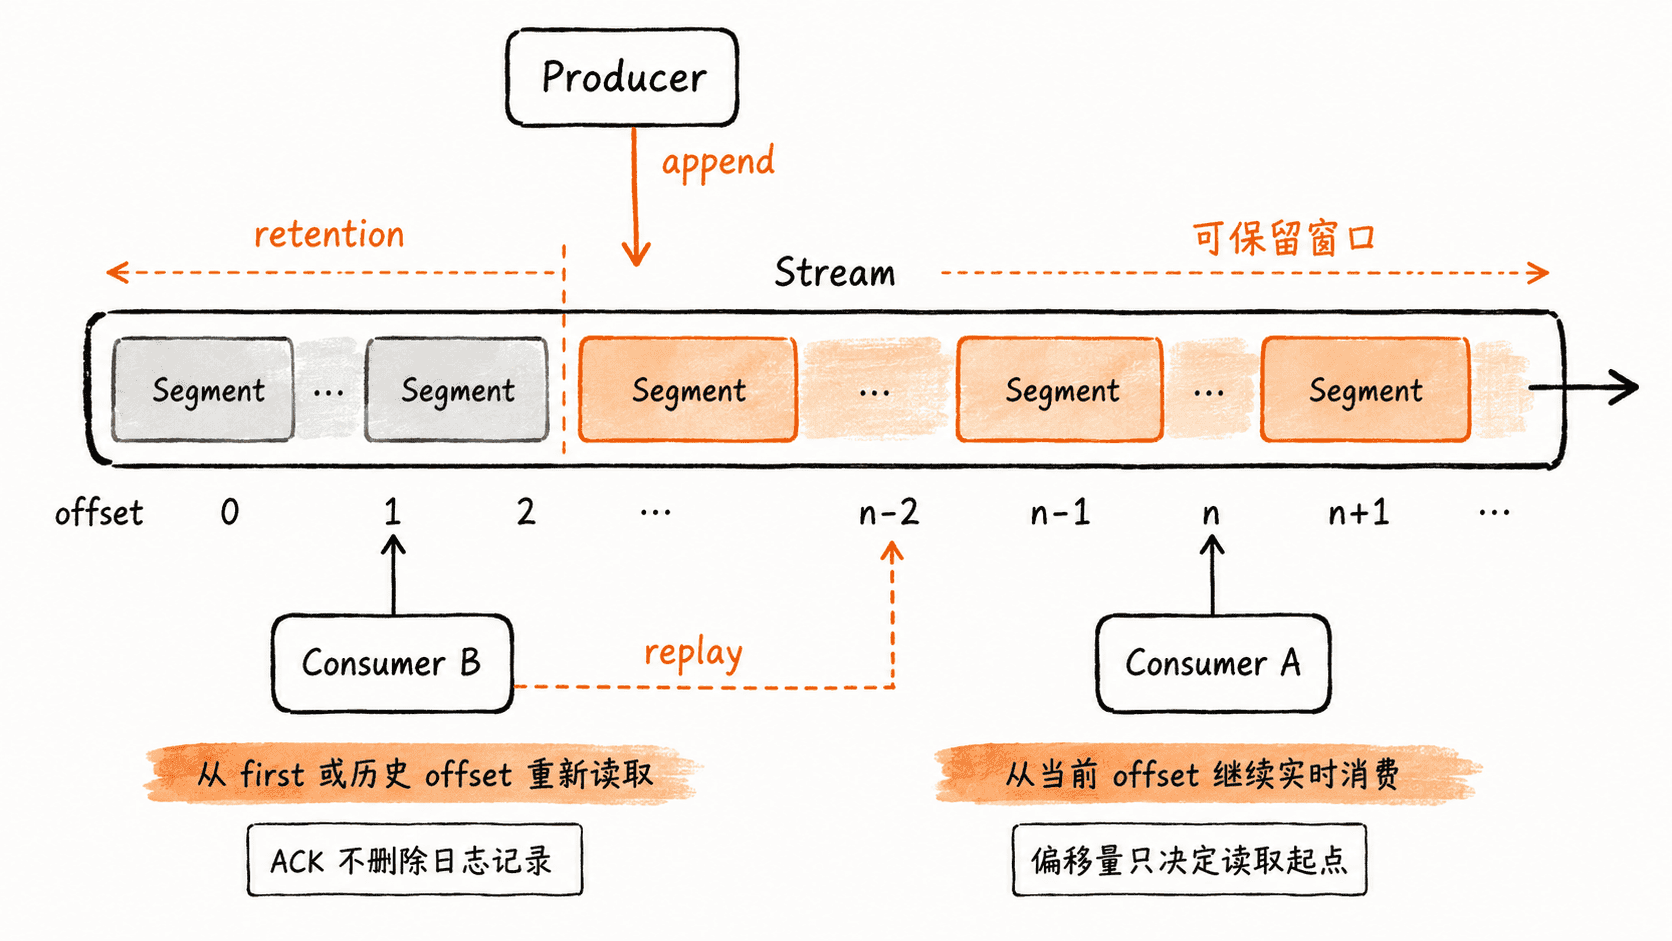
普通工作队列通常关注“消息被哪个消费者处理掉”,而 Stream 关注“消息按顺序追加后,在保留期内可被多个消费者反复读取”。消息确认不会把记录从 Stream 中删除;每个消费者从自己的起点继续读取,同一条消息可以被不同消费者或同一业务的不同批次再次消费。
Stream 始终是持久化、复制的数据结构,底层以磁盘上的不可变追加日志为核心。它仍可通过 AMQP 0-9-1 声明并绑定到 Exchange,但需要回放、偏移量跟踪或追求更高吞吐时,专用 Stream Protocol 客户端通常更合适。
保留策略决定还能回放多远
Stream 不会因为消费者 ACK 就删除消息,所以必须为磁盘增长设计保留策略。常用的两个限制是 x-max-age 与 x-max-length-bytes:前者按消息在 Stream 中的到达时间控制最长保留时间,后者限制总数据量,两者可以同时生效。
保留清理以 Segment 为单位,而不是逐条消息即时删除,因此磁盘占用不会精确停在某个字节值。若消费者指定的数值 offset 已落到已清理区域,RabbitMQ 会把读取位置收敛到当前仍可用的日志边界。设计容量时应把保留窗口、写入速率和可接受的回放跨度一起计算。
从偏移量开始消费并完成重放
AMQP 0-9-1 消费 Stream 时,可通过 x-stream-offset 指定起点。first 从当前最早可用消息开始,last 从最后一个已写入 chunk 附近开始,next 只接收订阅之后的新消息;还可以使用数值 offset、到达时间戳或相对时间区间。
下面示例假设本机 RabbitMQ 可通过默认 AMQP 端口访问,项目已引入 RabbitMQ Java Client。程序创建一个临时命名的 Stream,发布三条消息,然后让两个消费者都从 first 开始读取,借此验证“确认后仍可再次回放”。
import com.rabbitmq.client.Channel;
import com.rabbitmq.client.Connection;
import com.rabbitmq.client.ConnectionFactory;

import java.nio.charset.StandardCharsets;
import java.util.HashMap;
import java.util.Map;
import java.util.UUID;
import java.util.concurrent.CountDownLatch;
import java.util.concurrent.TimeUnit;

public class StreamReplayDemo {
    private static void replay(Channel channel, String stream, String name) throws Exception {
        CountDownLatch done = new CountDownLatch(3);
        channel.basicQos(10);

        String consumerTag = channel.basicConsume(
                stream,
                false,
                Map.of("x-stream-offset", "first"),
                (tag, delivery) -> {
                    String body = new String(delivery.getBody(), StandardCharsets.UTF_8);
                    System.out.println(name + ":" + body);
                    channel.basicAck(delivery.getEnvelope().getDeliveryTag(), false);
                    done.countDown();
                },
                tag -> { }
        );

        if (!done.await(5, TimeUnit.SECONDS)) {
            throw new IllegalStateException("Timed out while replaying stream");
        }
        channel.basicCancel(consumerTag);
    }

    public static void main(String[] args) throws Exception {
        ConnectionFactory factory = new ConnectionFactory();
        factory.setHost("localhost");

        try (Connection connection = factory.newConnection();
             Channel channel = connection.createChannel()) {
            String stream = "events-" + UUID.randomUUID();

            Map<String, Object> arguments = new HashMap<>();
            arguments.put("x-queue-type", "stream");
            arguments.put("x-max-age", "1h");
            arguments.put("x-max-length-bytes", 100_000_000L);

            channel.queueDeclare(stream, true, false, false, arguments);

            for (int i = 1; i <= 3; i++) {
                channel.basicPublish(
                        "",
                        stream,
                        null,
                        ("event-" + i).getBytes(StandardCharsets.UTF_8)
                );
            }

            replay(channel, stream, "A");
            replay(channel, stream, "B");
            channel.queueDelete(stream);
        }
    }
}
预期输出:
A:event-1
A:event-2
A:event-3
B:event-1
B:event-2
B:event-3
两组输出读取了同样的三条记录,说明第一次消费者的 ACK 只推进消费过程,并不会像传统队列那样把记录从 Stream 中破坏性移除。实际网络延迟和消费者标签等动态值可能不同,但消息内容与每组内部顺序应保持一致。
什么时候选择 Stream
当业务需要事件回放、审计历史、多个独立消费者读取同一日志,或单队列吞吐已成为瓶颈时,Stream 很合适。若目标只是“任务被一个消费者处理后即可删除”,Classic Queue 或 Quorum Queue 的语义更直接;如果还依赖消息优先级、死信交换器等传统队列能力,也应先确认 Stream 的功能边界。
Stream 的核心不是“永不删除”,而是在受控保留窗口内保存可重复读取的顺序日志。设计时先确定需要回放多久,再反推保留容量、磁盘性能和消费者 offset 管理方式,才能把可重放能力真正变成可运营的数据模型。