
消息队列 / 系统课时
可靠性问题分层
可靠性问题分层
消息可靠性不是一个开关,而是一条从生产者到消费者的责任链。本课把链路拆成生产、路由、存储和消费四层,分别判断消息会在哪里丢失、为什么会重复,以及积压应从哪一层开始定位。
学习目标
- 能按生产、路由、存储、消费四个阶段定位可靠性风险
- 能区分消息丢失、重复与积压背后的不同故障机制
- 能为每一层选择对应的确认、持久化、幂等和容量治理手段
把可靠性问题拆成四段
一条消息通常经历“生产者发布 → Exchange 路由 → Queue 存储 → Consumer 处理”。可靠性的关键不是只看 RabbitMQ 是否在线,而是判断每一次责任交接是否有证据、失败后由谁重试、重试是否会产生副作用。
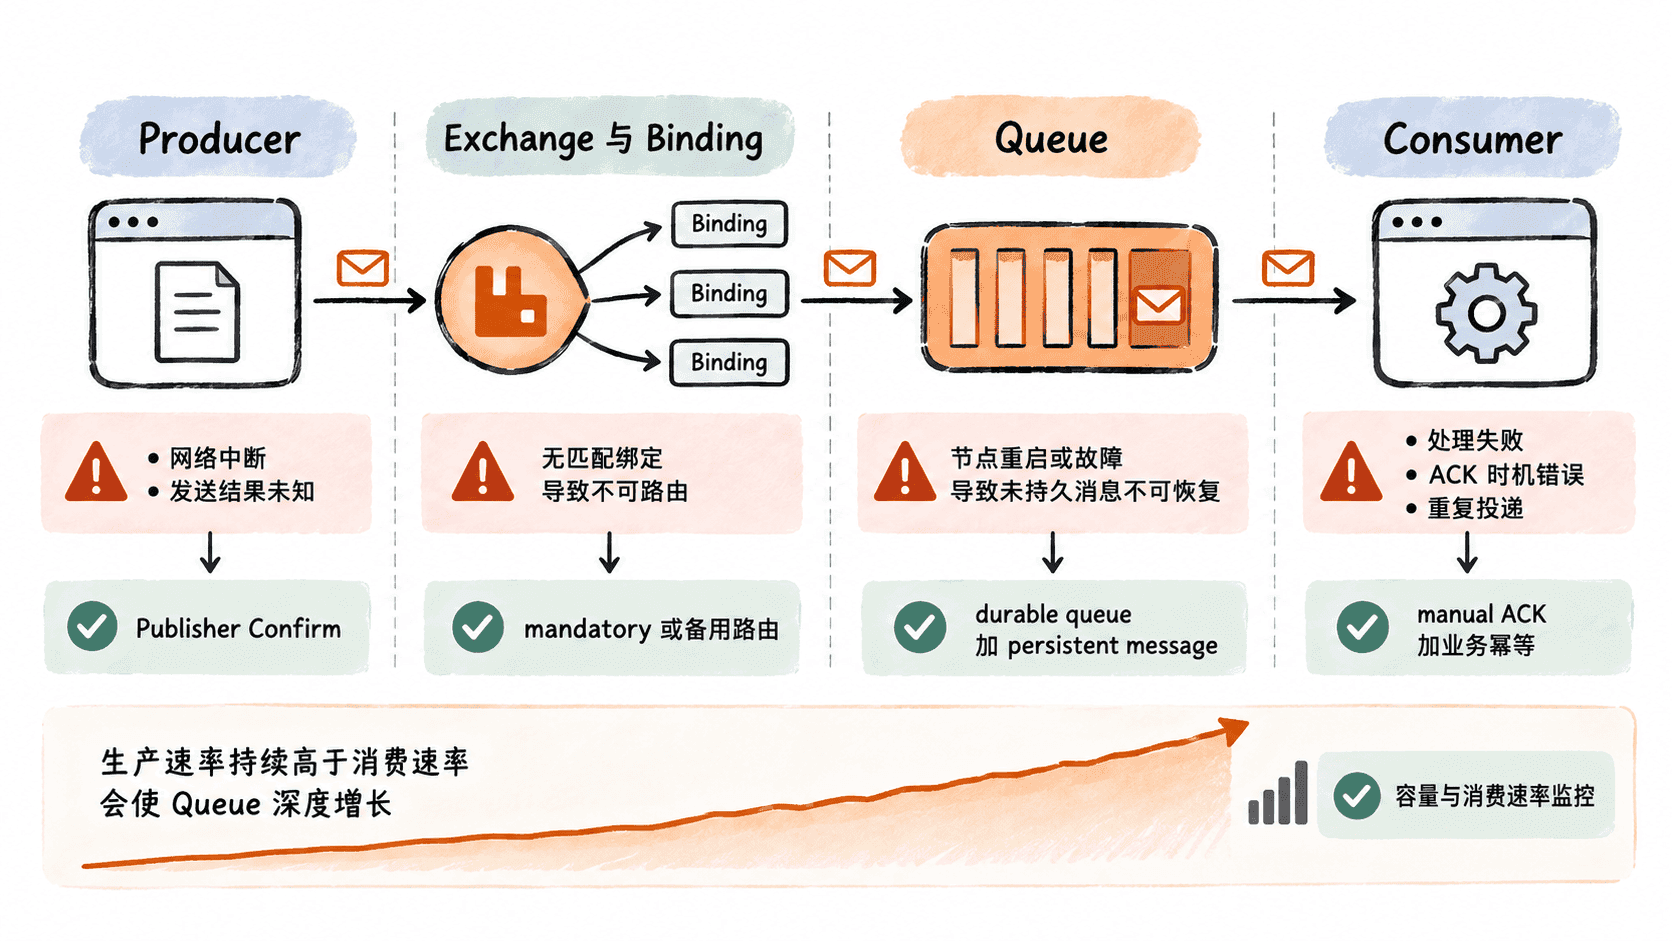
分层之后,排查顺序就很明确:先确认消息有没有被 Broker 接管,再确认是否路由到目标队列,然后确认是否满足恢复条件,最后检查消费者是否正确确认并具备重放能力。
生产与路由关注责任交接
生产者把数据写入 TCP 连接,并不等于 RabbitMQ 已经安全接管消息。连接可能在发送后、确认前中断,生产者只能看到“结果未知”。Publisher Confirm 的作用就是把“Broker 已接管”变成可判断的状态;超时或连接断开时,生产者通常需要按未确认消息重试。
消息被 Exchange 接收后,还可能因为没有匹配的 Binding 而无法进入任何队列。这属于路由失败,不是存储失败。需要严格保证消息进入某个目标队列时,应同时设计不可路由消息的检测或兜底策略,而不能只看到 Confirm 成功就认为业务链路已经完成。
| 阶段 | 典型风险 | 主要判断依据 | 常用控制手段 |
|---|---|---|---|
| 生产 | 发送结果未知、连接中断 | 是否收到发布确认 | Publisher Confirm、可重试发送 |
| 路由 | 无匹配绑定、路由键错误 | 是否真正进入目标队列 | mandatory、备用路由、路由监控 |
| 存储 | 重启后消息不可恢复 | 队列与消息是否满足持久化条件 | durable 队列、persistent 消息、合适的队列类型 |
| 消费 | 处理失败、重复执行 | ACK 是否晚于业务成功 | manual ACK、重试、业务幂等 |
存储层解决的是恢复能力
队列存在于内存还是具备重启恢复能力,与消息本身是否按持久消息发布是两个维度。只把 Queue 声明为 durable,并不能自动让所有消息都成为持久消息;反过来,把消息标记为 persistent 后发送到会在重启时消失的临时队列,也没有完整的恢复意义。
持久化主要解决 Broker 重启后的恢复问题,并不自动等于跨节点高可用。对于不能接受单节点故障造成长时间不可用或数据风险的业务,还要结合复制型队列、集群部署和发布确认设计完整的数据安全方案。
消费层必须接受重复的可能
消费者最危险的时序是“业务已经成功,但 ACK 还没到 Broker”。例如订单状态已经写入数据库,消费者此时崩溃,RabbitMQ 会把未确认消息重新投递。这样做避免了消息悄悄丢失,却会把问题转换成重复执行。
因此可靠消费通常采用 manual ACK,并且只在业务副作用真正完成后确认;同时以业务唯一键、去重记录或条件更新保证重复消息不会产生第二次副作用。可靠投递追求的是故障后可恢复,而不是假设网络和进程永远不会在临界点失败。
积压则是另一类问题:当持续生产速率大于可用消费速率,Queue 深度会不断增长。此时应观察 ready、unacked、消费者数量、处理耗时和下游依赖,而不是继续增加重试次数。把四层分别观测,才能判断问题究竟是“没有送到”“送了多次”还是“送得太快、处理不完”。