
消息队列 / 系统课时
容量与告警设计
容量与告警设计
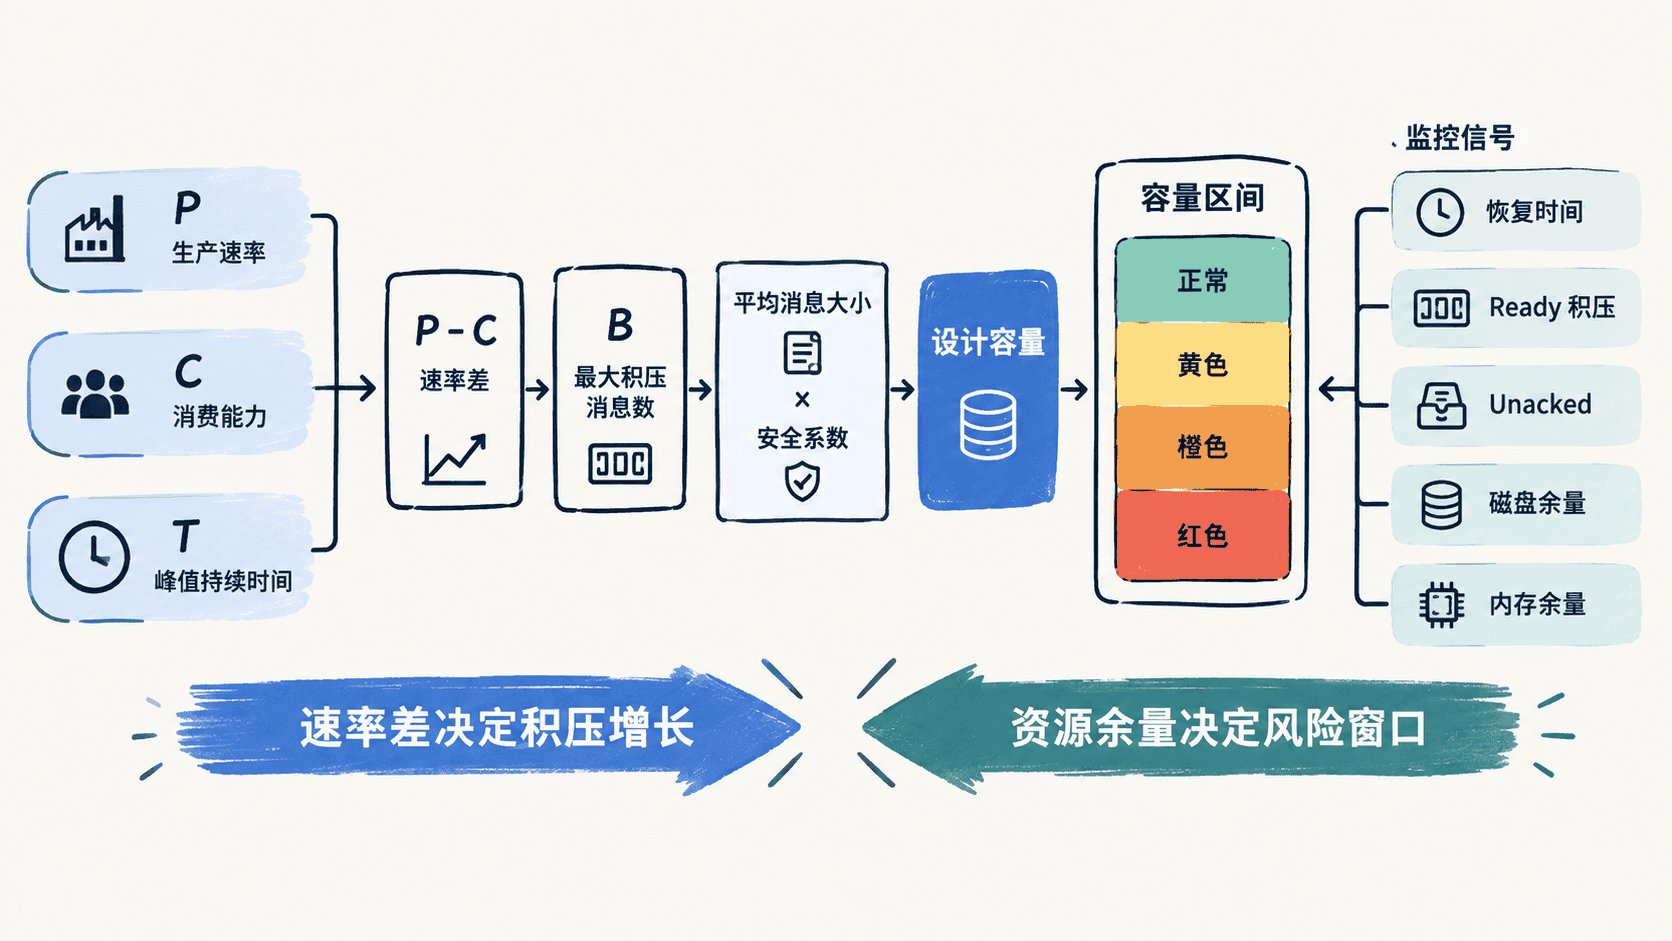
容量设计要回答两个问题:高峰期间最多会积压多少消息,以及系统能否在资源耗尽前发现并恢复。本文从生产速率、消费能力和峰值持续时间推导消息与磁盘容量,再把设计容量转换成可执行的分级告警。
学习目标
- 根据生产速率、消费能力和峰值持续时间估算最大积压
- 将消息数量换算为存储需求,并保留合理安全余量
- 用“趋势、容量占比、恢复时间”设计黄橙红三级告警
先把容量问题写成速率差
设峰值生产速率为 ,峰值消费能力为 ,峰值持续时间为 秒。当 时,理论新增积压为 ;当 时,这一段不会因为速率差继续增长。再用平均消息字节数乘以积压消息数,得到最小数据量估算。
这个结果只描述业务消息体的量级,不等于 RabbitMQ 节点的最终磁盘占用。真实部署还要考虑队列类型、复制、索引或日志结构、尚未回收的数据、磁盘水位以及异常恢复期间的额外空间,因此容量规划必须再乘安全系数并预留节点级余量。
用脚本计算峰值和恢复时间
下面示例假设峰值生产 12000 条/秒、消费 9000 条/秒,持续 20 分钟,平均消息体 1024 字节,并保留 1.5 倍安全系数。峰值结束后,正常生产降到 8000 条/秒,消费者可提升到 15000 条/秒。
publish_peak = 12_000
consume_peak = 9_000
peak_seconds = 20 * 60
avg_message_bytes = 1_024
safety_factor = 1.5

# 峰值阶段只计算生产超过消费的净新增积压
backlog = max(0, publish_peak - consume_peak) * peak_seconds
raw_gib = backlog * avg_message_bytes / (1024 ** 3)
planned_gib = raw_gib * safety_factor

normal_publish = 8_000
recovery_consume = 15_000
# 恢复时间取决于峰值结束后的净排空速率
drain_rate = max(1, recovery_consume - normal_publish)
recovery_minutes = backlog / drain_rate / 60

print(f"backlog_messages={backlog}")
print(f"raw_payload_gib={raw_gib:.2f}")
print(f"planned_payload_gib={planned_gib:.2f}")
print(f"recovery_minutes={recovery_minutes:.1f}")
预期输出
backlog_messages=3600000
raw_payload_gib=3.43
planned_payload_gib=5.15
recovery_minutes=8.6
这里的 5.15 GiB 只能作为“消息体容量基线”,不能直接拿来当磁盘规格。应使用真实压测或历史监控测出单位消息的实际节点存储放大,再叠加磁盘安全水位和故障恢复空间。
把设计容量转换成分级告警
告警最好围绕“距离设计边界还有多久”而不是一个固定消息条数。对每个重要队列至少同时观察 Ready、Unacked、生产与投递速率、消费者数量、节点磁盘与内存余量;如果业务有处理时效目标,再加入最老消息等待时间或等价的业务延迟指标。
可以把设计峰值积压记为 B_design,以容量占比和预计排空时间分级。黄色表示需要关注趋势,例如积压超过设计容量的 50% 且仍在增长;橙色表示应介入扩容或限流,例如超过 80% 或预计恢复时间已超过业务窗口;红色表示接近设计上限、资源告警已经触发,或生产者开始被 Broker 阻塞。百分比只是起始模板,应根据真实峰值和处置时间校准。
用演练验证阈值和处置链路
上线前主动做一次“消费能力下降”演练:固定生产速率,逐步减少消费者或降低消费速率,确认 Ready 按预期增长,黄色和橙色告警能在设计时间内触发;随后恢复消费者,验证排空速率与容量模型大致一致,并确认告警可以自动解除。
还要覆盖节点磁盘逼近安全水位、单个消费者卡住导致 Unacked 升高、某个队列突然出现异常大消息这三类情况。告警通知中应直接携带队列名、当前生产/消费速率、Ready/Unacked、预计排空时间和节点资源余量,让值班人员能立即判断是扩消费者、限流、拆分热点还是处理资源故障。
容量模型的价值不是给出一个永远不变的数字,而是把“能承受多长时间的生产消费失衡”变成可测量的风险窗口;每次业务峰值、消息大小或消费性能发生明显变化后,都应重新计算并回放告警阈值。