
消息队列 / 系统课时
集群架构与节点类型
集群架构与节点类型
这一课解决两个最容易混淆的问题:RabbitMQ 集群到底共享什么,以及消息实际存在哪些节点。学完后你能区分集群节点、元数据副本和队列副本,不再把“加入集群”误解为“所有消息自动复制到每台机器”。
学习目标
- 说明 RabbitMQ 4.3 集群中元数据与消息数据的复制边界
- 区分集群节点类型与队列 leader、follower 角色
- 根据队列类型判断消息实际位于哪些节点
元数据共享不等于消息全量复制
RabbitMQ 4.3 使用 Khepri 保存集群元数据。用户、虚拟主机、Exchange、Queue 定义、Binding、策略和运行时参数等信息会在集群节点之间复制,因此连接任意正常节点都能看到一致的拓扑定义。
消息内容属于队列或 Stream 自身的数据,不会因为节点加入同一集群就自动在所有节点保存一份。判断数据安全性时,必须继续看具体队列类型及其副本配置,而不能只看“集群有几台机器”。
节点类型和队列角色是两套概念
RabbitMQ 核心集群节点是对等成员,没有固定的“主 Broker”和“从 Broker”。CLI 中仍能看到 disc 与 ram 节点类型:默认是 disc,ram 节点的使用已不推荐。这个类型描述节点自身的持久化方式,不代表它承担固定的业务主从角色。
队列层面则存在 leader 与 follower。某个节点可以同时是队列 A 的 leader、队列 B 的 follower,也可以不承载队列 C 的任何副本,所以不能把“节点角色”和“某个队列的副本角色”混为一谈。
队列数据到底落在哪些节点
Classic Queue 只有一个 leader 副本,消息数据实际位于承载该队列的节点;其他集群节点虽然能访问它,但不会自动拥有消息副本。Quorum Queue 则由一个 leader 和若干 follower 组成,状态变更先由 leader 处理,再复制给该队列的其他成员。
当客户端连接到未承载目标队列 leader 的节点时,RabbitMQ 会在集群内部把相关操作路由到正确位置。对客户端来说队列仍然是集群级可访问资源,但数据位置依旧具体落在某些节点上。
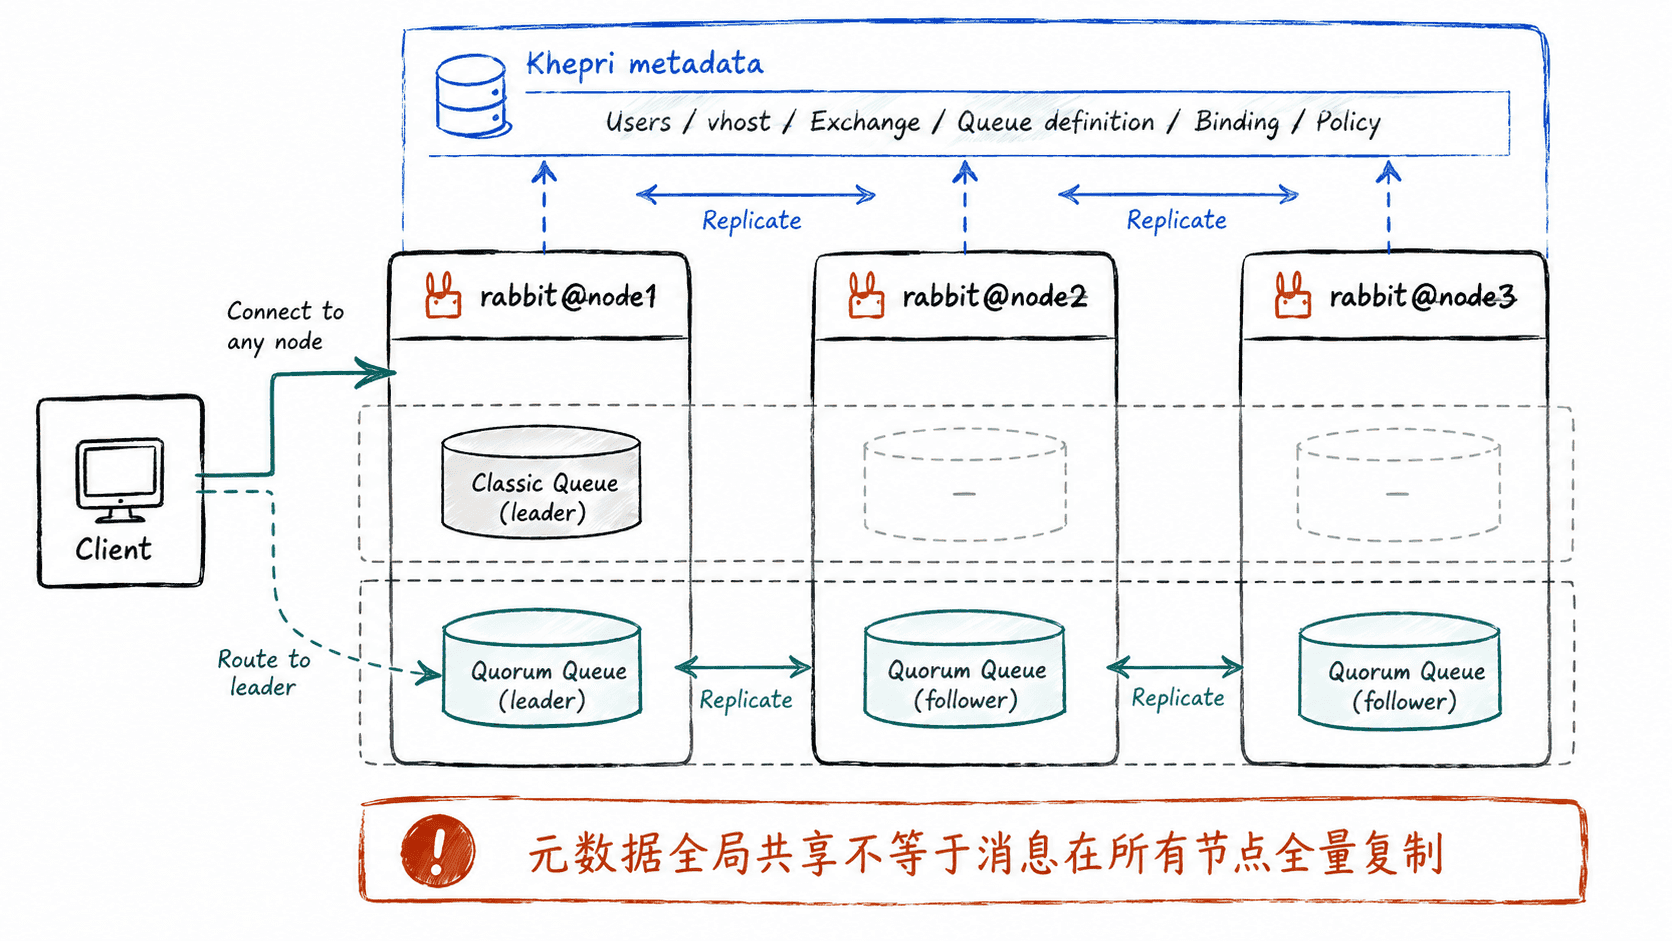
用集群状态核对节点
在任意正常节点执行 cluster_status,先确认集群成员与当前在线节点。下面只截取最关键的节点部分,实际输出还会包含版本、监听器等其他信息。
sudo -u rabbitmq rabbitmqctl cluster_status预期输出
Disk Nodes
rabbit@node1
rabbit@node2
rabbit@node3

Running Nodes
rabbit@node1
rabbit@node2
rabbit@node3
如果某个节点出现在成员列表却不在 Running Nodes 中,说明它属于集群但当前没有正常运行。若三个节点都在线,也仍不能据此认定所有队列都具备三副本;队列副本数要单独检查。
设计时抓住三个边界
生产环境通常优先使用持久化的磁盘节点,并采用 3、5 等奇数节点规模,以便依赖多数派的功能获得清晰的故障容忍边界。两节点集群在失去节点间连接时无法形成多数派,不适合作为高可用集群的常规选择。
最终要记住三个层次:集群成员决定谁共享元数据,队列类型决定消息是否复制,队列成员决定消息具体复制到哪些节点。 只把 Broker 数量堆上去,并不会自动得到消息级高可用。