
消息队列 / 系统课时
分级重试队列
分级重试队列
分级重试的目标不是“多试几次”,而是把短暂故障转换成可控等待,并在达到上限后明确退出。本文用 10 秒、1 分钟、5 分钟三级等待队列,配合 TTL、DLX 和业务重试计数,搭出不会无限回环的重试链路。
学习目标
- 设计具有不同等待时间的三级重试队列
- 用明确的重试计数限制最大尝试次数
- 配置 TTL 与死信回流,并识别重发过程中的可靠性边界
重试策略先确定退出条件
立即执行 basic.nack(..., requeue=true) 只会把消息迅速放回原队列,依赖服务仍不可用时会形成高频失败循环。分级重试应该先定义“每次失败等多久”和“最多再试几次”,再决定队列拓扑。
| 处理阶段 | x-retry-count |
等待时间 | 下一站 |
|---|---|---|---|
| 初次处理失败 | 0 → 1 | 10 秒 | orders.retry.10s |
| 第一次重试失败 | 1 → 2 | 1 分钟 | orders.retry.1m |
| 第二次重试失败 | 2 → 3 | 5 分钟 | orders.retry.5m |
| 第三次重试仍失败 | 3 | 不再等待 | orders.failed |
这里把“最大重试次数”定义为初次处理之外再尝试 3 次。x-retry-count 由应用维护,避免把业务次数判断绑死在 RabbitMQ 自动维护的死信历史上;永久性参数错误也不必走完三档,应直接进入最终失败队列。
消息在队列之间如何流转
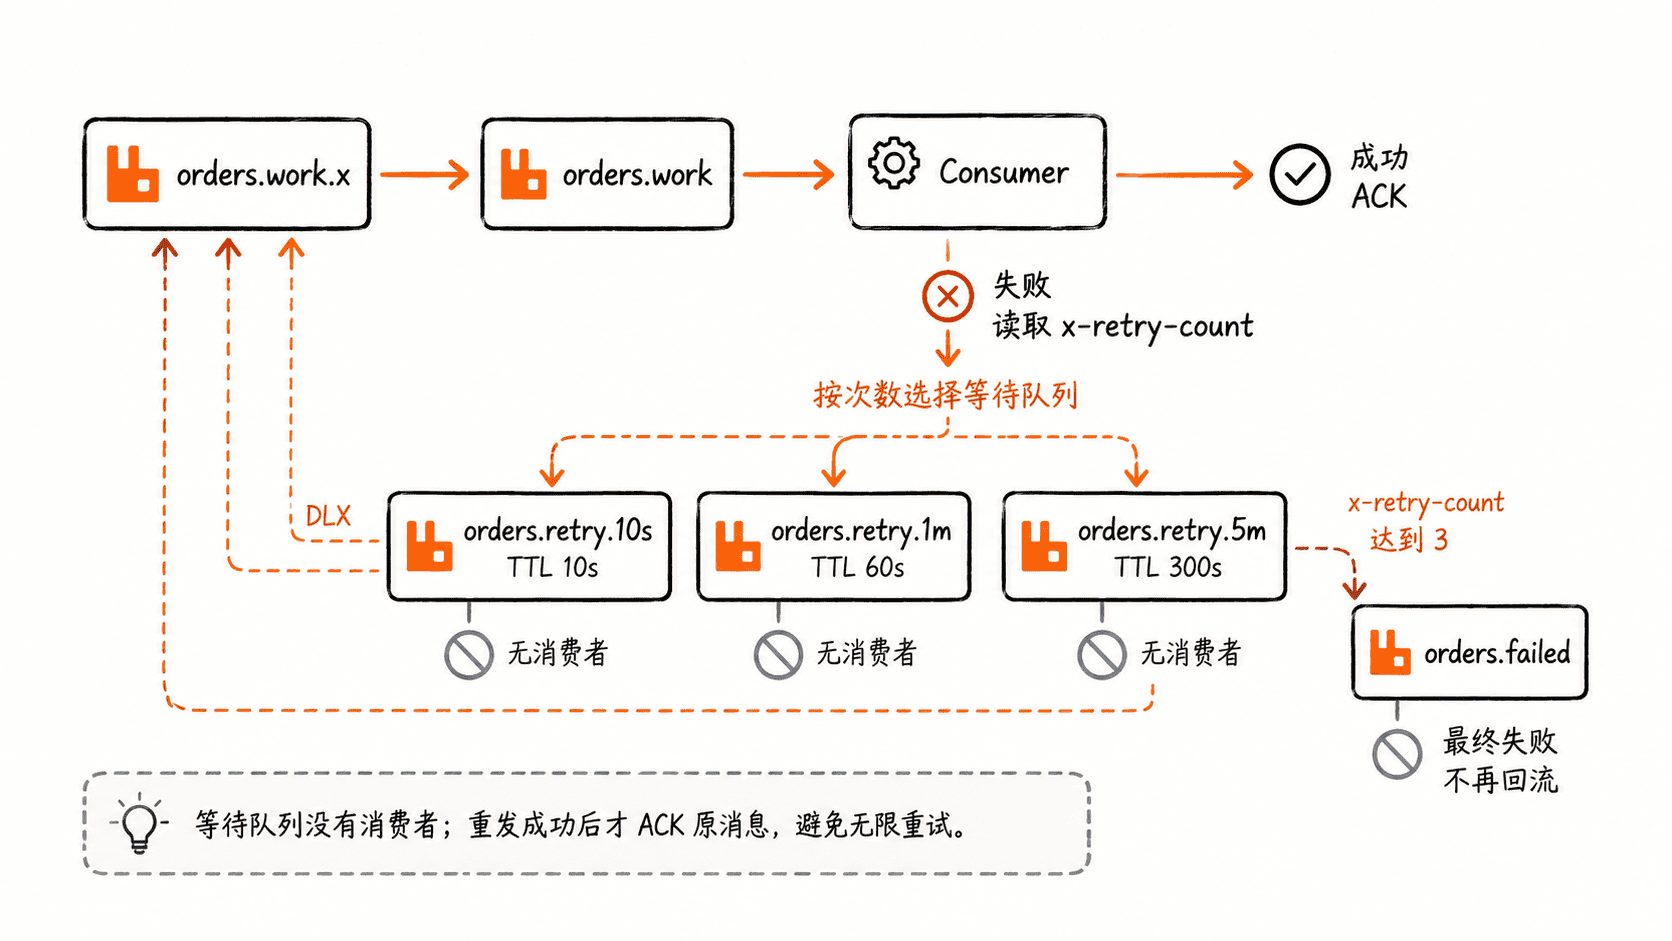
三个等待队列本身不启动消费者,只负责“存放一段时间”。消息在其中达到队列级 TTL 后成为死信,再由各自的 DLX 路由回工作交换机。消费者下一次收到的仍是同一业务任务,但业务头里的重试次数已经增加。
消费失败时不要先 ACK 再重发。更稳妥的顺序是:发布到目标重试队列或失败队列,等待 publisher confirm 成功,再 ACK 原消息。网络故障仍可能造成重复,因此业务处理还要以订单号、任务 ID 等幂等键兜底。
建立三层等待拓扑
下面假设 RabbitMQ 4.3 已运行,rabbitmqadmin v2 能访问默认虚拟主机 /,并且本机可以执行 rabbitmqctl。示例用 classic queue 展示固定档位的 TTL + DLX 方案。
rabbitmqadmin --vhost "/" exchanges declare --name "orders.work.x" --type "direct" --durable true >/dev/null
rabbitmqadmin --vhost "/" exchanges declare --name "orders.retry.x" --type "direct" --durable true >/dev/null
rabbitmqadmin --vhost "/" exchanges declare --name "orders.failed.x" --type "direct" --durable true >/dev/null

rabbitmqadmin --vhost "/" queues declare --name "orders.work" --type "classic" --durable true --auto-delete false >/dev/null
rabbitmqadmin --vhost "/" queues declare --name "orders.retry.10s" --type "classic" --durable true --auto-delete false >/dev/null
rabbitmqadmin --vhost "/" queues declare --name "orders.retry.1m" --type "classic" --durable true --auto-delete false >/dev/null
rabbitmqadmin --vhost "/" queues declare --name "orders.retry.5m" --type "classic" --durable true --auto-delete false >/dev/null
rabbitmqadmin --vhost "/" queues declare --name "orders.failed" --type "classic" --durable true --auto-delete false >/dev/null

rabbitmqadmin --vhost "/" bindings declare --source "orders.work.x" --destination-type "queue" --destination "orders.work" --routing-key "orders" >/dev/null
rabbitmqadmin --vhost "/" bindings declare --source "orders.retry.x" --destination-type "queue" --destination "orders.retry.10s" --routing-key "10s" >/dev/null
rabbitmqadmin --vhost "/" bindings declare --source "orders.retry.x" --destination-type "queue" --destination "orders.retry.1m" --routing-key "1m" >/dev/null
rabbitmqadmin --vhost "/" bindings declare --source "orders.retry.x" --destination-type "queue" --destination "orders.retry.5m" --routing-key "5m" >/dev/null
rabbitmqadmin --vhost "/" bindings declare --source "orders.failed.x" --destination-type "queue" --destination "orders.failed" --routing-key "failed" >/dev/null

rabbitmqctl set_policy --apply-to queues retry-10s '^orders\.retry\.10s$' '{"message-ttl":10000,"dead-letter-exchange":"orders.work.x","dead-letter-routing-key":"orders"}' >/dev/null
rabbitmqctl set_policy --apply-to queues retry-1m '^orders\.retry\.1m$' '{"message-ttl":60000,"dead-letter-exchange":"orders.work.x","dead-letter-routing-key":"orders"}' >/dev/null
rabbitmqctl set_policy --apply-to queues retry-5m '^orders\.retry\.5m$' '{"message-ttl":300000,"dead-letter-exchange":"orders.work.x","dead-letter-routing-key":"orders"}' >/dev/null

rabbitmqctl -q list_queues name | grep '^orders\.' | sort
预期输出
orders.failed
orders.retry.10s
orders.retry.1m
orders.retry.5m
orders.work
TTL 与 DLX 放在 policy 中而不是硬编码到队列声明里,后续调整等待时间时无需修改应用声明代码。三条 policy 的正则只匹配各自等待队列,避免把工作队列或最终失败队列也套上 TTL。
在消费端选择下一档
消费者只需要根据当前计数决定下一次发布目标。下面的可运行示例把“初次失败后 10 秒、再失败 1 分钟、再失败 5 分钟、之后失败队列”的规则固化成一个纯函数;真正消费时,将返回的交换机与 routing key 用于重发,并把新计数写回消息头。
RETRY_ROUTES = ("10s", "1m", "5m")

def next_destination(retry_count: int) -> tuple[str, str, int]:
    if retry_count < len(RETRY_ROUTES):
        return "orders.retry.x", RETRY_ROUTES[retry_count], retry_count + 1
    return "orders.failed.x", "failed", retry_count

for count in range(4):
    exchange, routing_key, next_count = next_destination(count)
    print(count, "->", exchange, routing_key, next_count)
预期输出
0 -> orders.retry.x 10s 1
1 -> orders.retry.x 1m 2
2 -> orders.retry.x 5m 3
3 -> orders.failed.x failed 3
验收时重点看什么
先人为制造一个可恢复故障,确认消息按 10 秒、1 分钟、5 分钟顺序回到 orders.work;再让故障持续存在,确认第四次失败进入 orders.failed 且不再回流。等待队列不应存在业务消费者,否则 TTL 尚未到期的消息会被提前取走。
TTL 表示消息在队列中的最长期限策略,不应把这种链路当作毫秒级定时器。最终失败队列还应配套告警、人工补偿或离线重放流程;否则“停止重试”只是把无限循环变成了无人处理的积压。