
消息队列 / 系统课时
订单事件系统设计
订单事件系统设计
订单事件系统的关键不是把所有步骤塞进一条消息,而是让订单、支付、库存和通知各自拥有清晰职责,并用稳定事件连接起来。本篇以“支付成功后扣减库存并发送通知”为主链路,完成事件拆分、失败处理和验收设计。
学习目标
- 将订单创建、支付、库存和通知拆分为边界清晰的领域事件
- 设计正常链路、业务失败、重复投递和技术故障的处理方式
- 定义可以独立演进并用于排障的事件契约
拆分事件与服务职责
不要让一条 order.process 消息同时要求多个服务完成支付、扣库存和通知。这样的消息把流程控制权集中在生产者,任何一步变化都可能迫使整个系统一起修改。
本例采用事件协作方式:订单服务保存订单后发布 order.created;支付服务完成支付后发布 payment.succeeded;库存服务成功扣减后发布 inventory.deducted;通知服务完成发送后发布 notification.sent。每个事件描述已经发生的事实,而不是命令下游必须执行某个内部动作。
每个需要独立处理同一事件的服务应拥有自己的队列。例如风控和分析都关心 order.created 时,应分别绑定自己的队列,而不是共享一条队列竞争消费,否则一条事件只会被其中一个消费者获得。
串起主流程与失败分支
下面的主链路采用“先支付成功,再扣减库存”的示例策略。业务若要求预占库存,应调整事件顺序,但仍应保持每一步只对自己的状态负责。
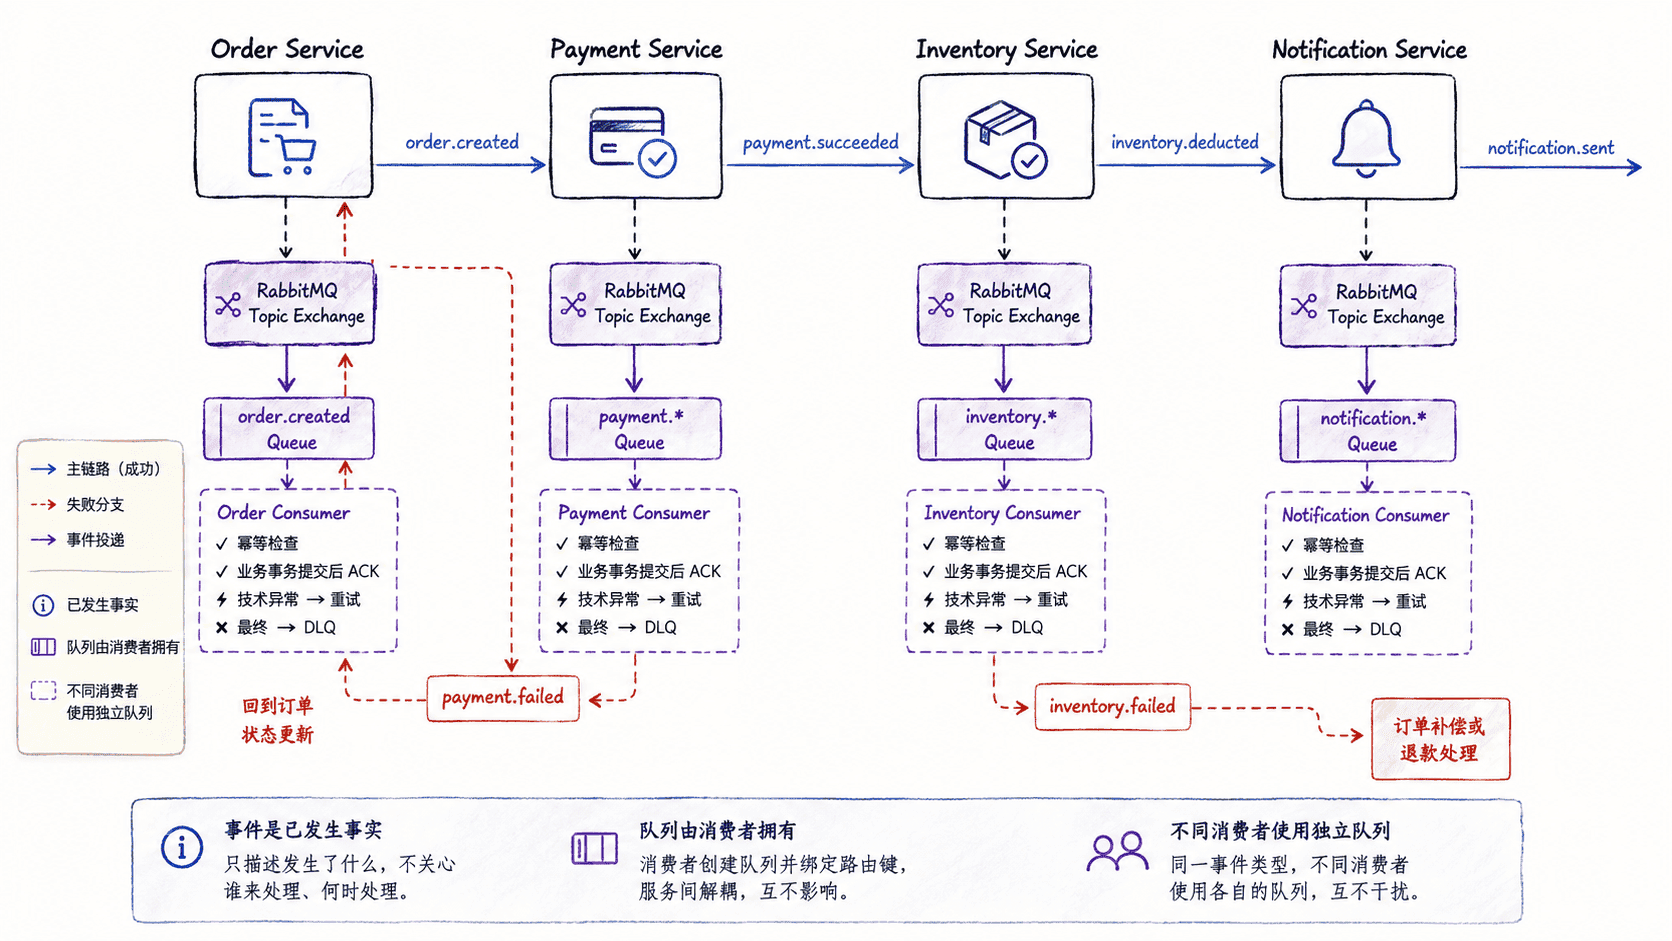
支付拒绝、库存不足属于业务结果,应发布明确的失败事件,例如 payment.failed、inventory.failed,由订单服务据此推进状态机或触发退款。网络超时、数据库瞬时故障等技术错误则不应伪装成业务失败,而应进入有限次数重试,超过阈值后送入死信队列等待人工或补偿任务处理。
定义可追踪的事件契约
业务事件至少应包含事件标识、事件类型、契约版本、发生时间和业务数据。eventId 用于消费者去重,schemaVersion 用于契约演进,业务对象标识则用于把不同事件串回同一订单。
{
  "eventId": "<ID>",
  "eventType": "payment.succeeded",
  "schemaVersion": 1,
  "occurredAt": "<TIME>",
  "data": {
    "orderId": "ORDER-1001",
    "paymentId": "PAY-2001",
    "amount": 19900,
    "currency": "CNY"
  }
}
这是事件数据结构示例,不是 RabbitMQ 专有格式。实际系统可以使用 JSON、Protobuf 等序列化方式,但应保证同一事件类型的字段语义稳定。金额示例使用最小货币单位整数,避免浮点数计算误差;<ID> 与 <TIME> 在真实运行时由应用生成。
控制重复、乱序与确认时机
RabbitMQ 的可靠投递通常意味着消费者必须接受重复消息的可能性。消费者处理 payment.succeeded 时,应先使用 eventId 或业务唯一键做幂等判断,再在本地事务内更新业务状态;事务成功提交后才发送 ACK。这样即使连接在提交后、ACK 前中断,消息重新投递也不会重复扣库存。
跨队列的事件也不能假设绝对顺序。库存服务收到事件时应检查订单或库存状态是否允许当前转换,而不是因为“理论上前一个事件应该先到”就直接覆盖状态。对明显不满足前置条件的事件,可以短暂重试;长期无法满足时应进入异常处理队列,并保留 orderId、eventId 和失败原因便于追踪。
用业务轨迹验收设计
验收时不要只检查“RabbitMQ 里有消息”,而应从一个订单开始核对完整业务轨迹。正常场景应依次观察到订单创建、支付成功、库存扣减和通知发送,并且每个服务的数据库状态与对应事件一致。
随后至少验证三类异常:重复投递同一个 eventId 不产生第二次业务副作用;库存不足能够产生明确失败事件并进入补偿路径;人为制造消费者异常后消息只进行有限重试,最终能够在死信队列中定位。只要事件、状态和失败路径都能通过同一个业务标识串联,这套协作链路才真正具备可运行和可排查性。