
消息队列 / 系统课时
适用场景与设计边界
适用场景与设计边界
RabbitMQ 最适合解决“业务动作可以异步完成,但消息不能随意丢失”的服务协作问题。本节从同步性、可靠性、路由、积压与回放需求判断是否该引入 RabbitMQ,并区分普通队列、Streams 与其他系统的边界。
学习目标
- 识别异步解耦、削峰和可靠任务等典型适用场景。
- 用少量关键问题判断 RabbitMQ 是否适合当前需求。
- 区分强同步调用、数据库事务与大规模日志流的设计边界。
RabbitMQ 擅长解决什么
RabbitMQ 的价值不只是“把消息放进队列”,而是把生产者与消费者在时间和部署上解耦,并提供路由、确认、重试、限流等机制。它特别适合订单后置处理、邮件或通知发送、后台任务、跨服务事件分发,以及突发流量需要缓冲的场景。
当消费者暂时变慢时,队列可以吸收短期峰值;当某个任务失败时,可以结合确认、重投递、死信或延迟策略处理;当同一事件要投递给不同业务时,Exchange 与 Binding 可以把路由规则留在消息系统侧,而不是写死在生产者中。
用决策问题快速判断
判断是否引入 RabbitMQ 时,先问“调用方能不能先结束当前请求”。如果业务必须立即拿到下游计算结果,主链路仍应优先使用同步调用;如果业务允许稍后完成,再继续判断是否需要可靠投递、削峰、重试、复杂路由或消费者解耦。
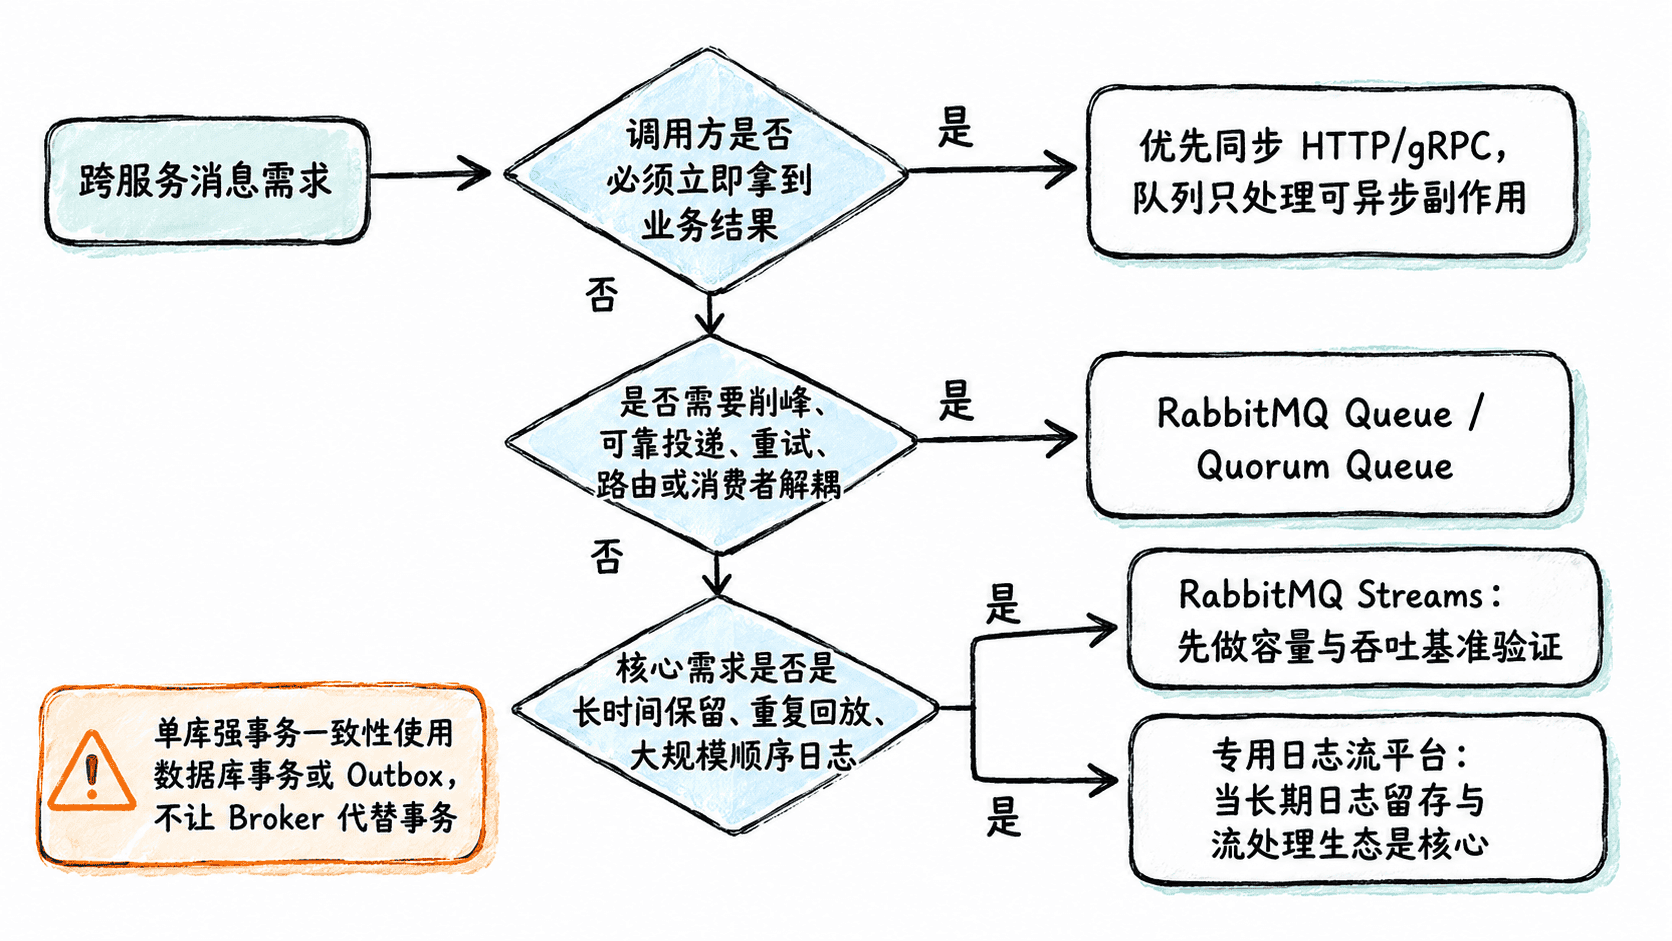
这里的关键是先确定交互契约,再决定中间件。队列只能改变“什么时候处理”和“由谁处理”,不能把一个必须同步成功的业务约束自动变成异步约束。
不适合直接交给 RabbitMQ 的问题
强同步主链路是第一类边界。例如支付授权结果必须在当前请求内返回,不能仅通过“消息已入队”视为业务成功;RabbitMQ 可以异步处理通知、审计等副作用,但不应替代真正需要同步确认的调用。
数据库原子性是第二类边界。一个本地事务中的多表一致性仍应由数据库事务保证;跨数据库或跨服务的一致性通常还需要 Outbox、幂等、补偿等设计,不能因为用了消息确认就假设获得了全局事务。
大规模日志流需要进一步拆分需求。普通 Queue 更偏向“消费后逐步清空”的工作队列;RabbitMQ Streams 支持保留、回放和较大积压。如果系统的核心却是超长时间事件日志、海量顺序写入、反复回放和完整流处理生态,应把 Streams 与专用日志流平台一起基准测试,而不是默认选择普通队列。
设计前先写下五个答案
在技术选型评审中,至少明确:生产者是否允许立即返回、可接受的消息丢失与重复语义、峰值积压量、是否要求严格顺序、消息需要保留和回放多久。只要这些答案仍然模糊,直接讨论 Exchange 类型或队列参数通常都过早。
RabbitMQ 是否合适,最终取决于它能否以可接受的复杂度满足这些交付语义,而不是“团队是否已经会用 RabbitMQ”。