
PostgreSQL / 系统课时
交付锁与死锁治理方案
交付锁与死锁治理方案
锁治理的交付物不能停留在“知道如何查阻塞”。本节把事务规范、分层超时、DDL 门禁、监控告警与 Runbook 组合成一套可验收的生产方案,并用数据库查询验证关键控制是否真正落地。
学习目标
- 把锁与死锁风险转成有负责人、有阈值、有证据的生产控制项。
- 为事务、超时和 DDL 变更建立可执行的工程门禁。
- 用监控与 Runbook 完成从发现、处置到复盘回灌的治理闭环。
先定义治理验收边界
治理目标不是消灭所有锁等待。正常事务本来就会持锁,真正需要控制的是不可预测的长等待、无边界事务、危险 DDL 和重复死锁。因此交付前先约定哪些现象允许出现、超过什么条件必须告警、由谁处置,以及处置后用什么证据证明恢复。
| 风险 | 控制目标 | 验收证据 |
|---|---|---|
| 长事务或空闲事务 | 事务边界明确,超出策略阈值可发现并处置 | pg_stat_activity、事务年龄告警 |
| 锁等待扩散 | 等待达到阈值时能定位等待者与阻塞者 | pg_blocking_pids()、锁等待看板 |
| DDL 阻塞业务 | 高风险 DDL 先检查、可快速失败、可回退 | 发布流水线记录、变更演练 |
| 死锁 | 能检测增量、保留日志并定位参与 SQL | pg_stat_database.deadlocks、数据库日志 |
| 人工处置失控 | 取消或终止会话前有明确授权与判断条件 | Runbook、事件记录 |
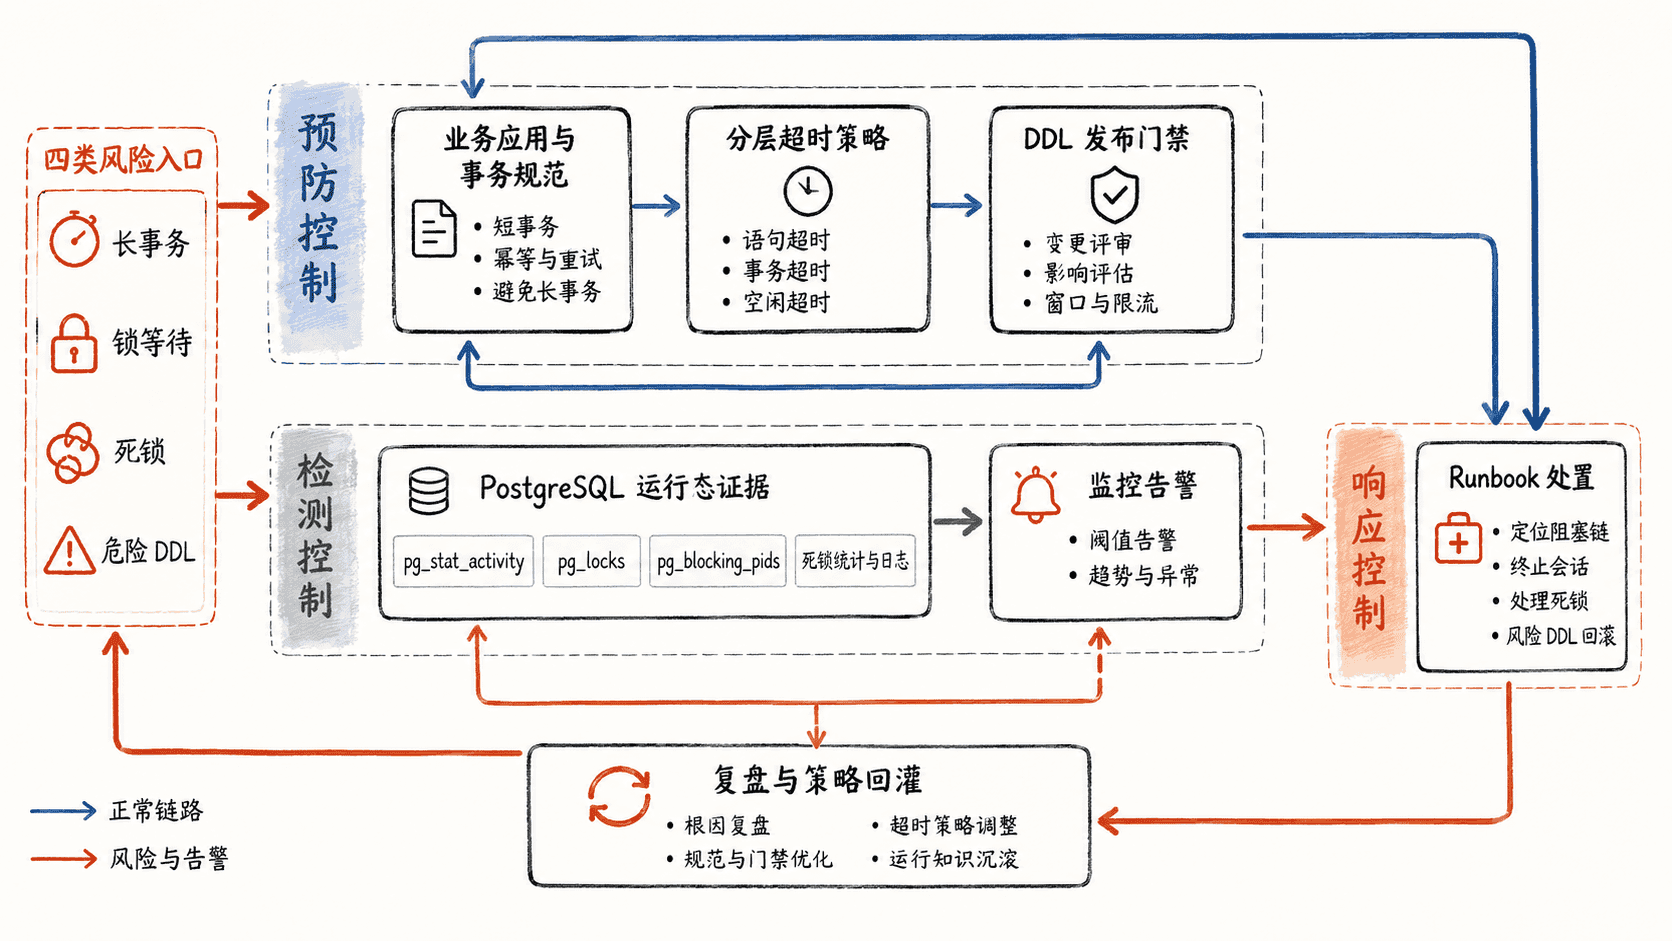
这张图的关键不是工具数量,而是反馈方向:监控发现的问题必须回到事务代码、超时参数或发布流程中修正,否则 Runbook 只是在重复救火。
固化五道生产控制线
事务规范。 事务只覆盖必须保持原子性的数据库操作,不把远程 RPC、人工等待、长时间计算放在事务内部;所有异常路径都必须明确提交或回滚。连接池归还连接前还要确保事务已经结束,避免形成长期 idle in transaction。
超时策略。 lock_timeout 只限制等待锁的时间,statement_timeout 控制整条语句的执行时间,idle_in_transaction_session_timeout 用来终止长时间空闲但仍打开的事务。阈值应按在线请求、批处理、运维任务和迁移会话分层设置;同时启用前两者时,通常应让锁等待更早失败,而不是等到整条语句超时。
DDL 门禁。 生产变更在执行前检查长事务、锁等待和业务高峰,迁移会话设置较短的 lock_timeout 以避免无限等待。高风险 DDL 先在接近生产的数据规模上演练,发布平台限制并发迁移,并为失败后的重试、回退和人工升级预留路径。
监控告警。 至少持续观察阻塞会话数量与持续时间、最老事务年龄、idle in transaction 年龄、死锁计数增量,以及数据库日志中的长锁等待。启用 log_lock_waits 时,日志阈值与 deadlock_timeout 有关,因此两者应与告警策略一起评审,而不是孤立修改。
Runbook。 告警必须直接指向处置步骤:先保留等待链和 SQL 证据,再判断阻塞者是在正常执行、异常长跑还是已经空闲泄漏;只有确认影响范围和会话归属后,才进入取消语句、终止会话、停止流量或回滚变更等动作。
用数据库证据做上线验收
下面的 SQL 可直接在一次演练会话中执行。执行账号应具备读取其他会话统计信息的权限,否则等待链中的 SQL 等字段可能不可见。2s 和 10min 只是展示 DDL/运维会话“锁等待先失败、整条语句后失败”的分层方式,不是所有生产系统的统一推荐值;SET 只影响当前会话。
SET lock_timeout = '2s';
SET statement_timeout = '10min';

SELECT current_setting('lock_timeout') AS lock_timeout,
       current_setting('statement_timeout') AS statement_timeout,
       current_setting('idle_in_transaction_session_timeout') AS idle_tx_timeout,
       current_setting('log_lock_waits') AS log_lock_waits,
       current_setting('deadlock_timeout') AS deadlock_timeout;

SELECT pid AS waiting_pid,
       pg_blocking_pids(pid) AS blocking_pids,
       now() - query_start AS query_age,
       left(query, 80) AS waiting_sql
FROM pg_stat_activity
WHERE cardinality(pg_blocking_pids(pid)) > 0
ORDER BY query_age DESC;
预期结果
SET
SET
 lock_timeout | statement_timeout | idle_tx_timeout | log_lock_waits | deadlock_timeout
--------------+-------------------+-----------------+----------------+-----------------
 2s           | 10min             | <VALUE>         | <VALUE>        | <VALUE>
(1 row)

 waiting_pid | blocking_pids | query_age | waiting_sql
-------------+---------------+-----------+------------
(0 rows)
实际参数值会随环境不同;干净的演练窗口中第二个查询可以是 0 rows。上线验收时不能只看“没有阻塞”,还要核对读取到的超时与日志参数是否符合批准的策略,并在故意制造锁等待的演练中确认查询能返回等待者和阻塞者 PID。
让告警触发可执行 Runbook
Runbook 应把“看到告警后怎么办”写成确定顺序,而不是临场依赖个人经验。
- 先记录时间、数据库、等待 PID、阻塞 PID、
application_name、事务开始时间、等待事件和 SQL,避免处置后证据消失。 - 判断阻塞者是否仍在正常执行,以及它的事务是否符合业务预期。短事务优先等待自然释放,异常长跑语句再考虑
pg_cancel_backend()。 - 只有在确认会话归属、业务影响和回滚方式后,才考虑
pg_terminate_backend();若根因来自发布任务,优先停止继续产生冲突的新任务。 - 恢复后再次检查阻塞链、长事务和错误率,并把根因归入代码事务边界、索引或 SQL、DDL 流程、超时策略或容量问题,安排永久修复。
告警也不能只报“数据库有锁”。通知中至少应包含数据库、等待持续时间、等待者与阻塞者 PID、应用标识和 Runbook 链接;死锁类告警还应结合死锁计数增量与对应日志,避免只看到累计值就重复报警。
交付包通过什么才算完成
最终交付至少要让开发、DBA/SRE 和发布平台对同一套规则达成一致,并留下可复验的证据:
- 事务规范已经进入开发约束,明确禁止长时间持锁和未结束事务。
- 超时策略按工作负载分层,参数值、作用范围、例外和负责人都有记录。
- DDL 流水线具备预检查、锁等待快速失败、并发限制和失败回退机制。
- 看板能看到阻塞、长事务、空闲事务和死锁趋势,告警都有明确接收人与升级路径。
- 数据库日志能够支撑长锁等待与死锁分析,并有与事故调查匹配的保留周期。
- Runbook 明确证据采集、等待、取消、终止、回滚和升级条件,并完成过演练。
- 至少完成一次锁等待和一次死锁演练,证明告警、定位、处置、恢复与复盘链路都能闭环。
锁治理真正完成的标志不是生产环境从此“没有等待”,而是等待有边界、死锁可发现、DDL 能安全失败、事故能按标准动作恢复,并且每次事件都会反向改进事务代码、参数或发布门禁。