
PostgreSQL / 系统课时
评估索引变更的锁行为
评估索引变更的锁行为
索引变更的风险不只取决于表有多大,更取决于命令申请什么锁、会不会等待旧事务,以及等待期间是否阻塞新的业务请求。本节用可重复实验比较普通建索引与并发建索引,并把 REINDEX、DROP INDEX 一起放进生产变更视角评估。
学习目标
- 判断
CREATE INDEX与CREATE INDEX CONCURRENTLY对读写并发的差异 - 用锁超时实验验证普通建索引为什么会被写事务挡住
- 识别并发索引维护的额外等待、失败残留与资源成本
先看锁模式,而不是只看执行时间
普通 CREATE INDEX 会在目标表上取得 SHARE 锁。这个锁不与普通 SELECT 使用的 ACCESS SHARE 冲突,所以读取可以继续;但它与 INSERT、UPDATE、DELETE 使用的 ROW EXCLUSIVE 冲突,因此建索引期间会挡住写入。
CREATE INDEX CONCURRENTLY 使用更弱的 SHARE UPDATE EXCLUSIVE 表级锁,它与业务写入的 ROW EXCLUSIVE 兼容,所以不会因为索引构建本身长期锁死写流量。但“并发”不等于“没有等待”:它需要多阶段扫描,并等待可能影响构建结果的旧事务或旧快照结束,整体通常更慢,也会消耗额外 CPU、I/O 和临时空间。
| 操作 | 主要并发影响 | 生产侧关注点 |
|---|---|---|
CREATE INDEX |
读可继续,写被阻塞 | 大表上容易形成长时间写等待 |
CREATE INDEX CONCURRENTLY |
普通读写可继续 | 构建更慢,会等待旧事务,失败可能留下无效索引 |
REINDEX |
父表写被阻塞;被重建索引还会取得强锁 | 查询也可能因索引锁等待 |
REINDEX CONCURRENTLY |
尽量保持普通读写 | 工作量更大,仍需等待相关事务 |
DROP INDEX |
需要短暂取得父表强锁 | 高并发时“短操作”也可能长时间等锁 |
DROP INDEX CONCURRENTLY |
避免把普通读写锁在外面 | 不能放进事务块,且有对象类型与依赖限制 |
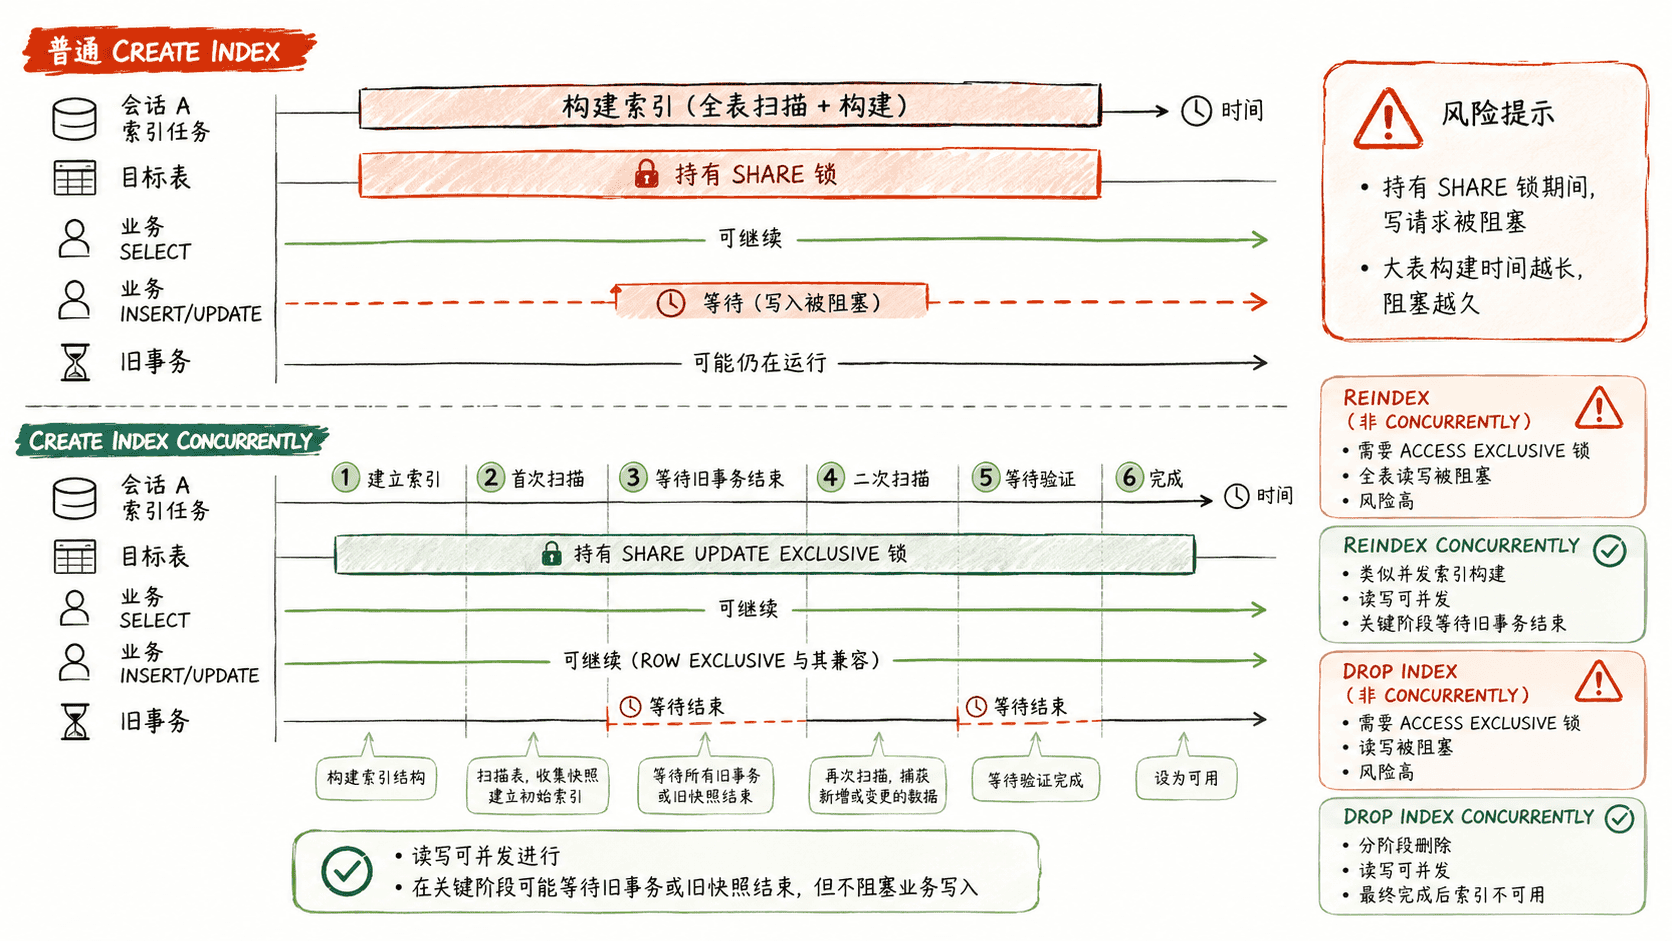
用锁超时复现普通建索引被写事务挡住
先在测试库创建一张实验表。下面的规模只用于演示锁行为,不代表生产索引构建耗时。
CREATE TABLE index_lock_lab (
    id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    tenant_id integer NOT NULL,
    payload text NOT NULL
);

INSERT INTO index_lock_lab (tenant_id, payload)
SELECT g % 1000, repeat(md5(g::text), 4)
FROM generate_series(1, 200000) AS g;
预期输出:
CREATE TABLE
INSERT 0 200000
会话 A 开启事务并更新一行,但暂不提交。写操作会让事务在目标表上持有 ROW EXCLUSIVE 表级锁。
BEGIN;
UPDATE index_lock_lab
SET payload = payload
WHERE id = 1;
预期输出:
BEGIN
UPDATE 1
保持会话 A 不动,在会话 B 执行普通建索引,并把锁等待上限压到 1 秒。由于 SHARE 与已有的 ROW EXCLUSIVE 冲突,索引语句会快速失败,而不是无限排队。
SET lock_timeout = '1s';
CREATE INDEX idx_index_lock_lab_tenant
ON index_lock_lab (tenant_id);
预期输出:
SET
ERROR:  canceling statement due to lock timeout
回到会话 A 释放事务。
ROLLBACK;预期输出:
ROLLBACK此时再使用并发构建。它不能放在显式事务块中,因此直接作为独立语句执行。
SET lock_timeout = '5s';
CREATE INDEX CONCURRENTLY idx_index_lock_lab_tenant
ON index_lock_lab (tenant_id);
预期输出:
SET
CREATE INDEX
最后检查索引是否已经进入可维护、可使用状态。
SELECT indexrelid::regclass AS index_name,
       indisready,
       indisvalid
FROM pg_index
WHERE indexrelid = 'idx_index_lock_lab_tenant'::regclass;
预期结果:
          index_name          | indisready | indisvalid
------------------------------+------------+-----------
 idx_index_lock_lab_tenant    | t          | t
实际列宽可能不同,但成功构建后 indisready 与 indisvalid 都应为 t。
并发构建仍有三个容易误判的边界
第一,CREATE INDEX CONCURRENTLY 不是“立即开始扫描”。如果已有长事务修改过目标表,或者存在需要等待的旧快照,它可能长时间停在等待阶段;此时业务写入通常仍能继续,但变更窗口会被拖长。
第二,并发构建失败后要检查 pg_index.indisvalid。死锁、唯一性冲突等错误可能留下同名的无效索引,它不会用于正常查询,却仍可能增加后续写入维护成本。不要看到命令失败就直接重复执行同名 CREATE INDEX CONCURRENTLY。
第三,同一张表一次只能进行一个并发索引构建。即使锁冲突较少,同时在多个大表上跑并发构建也可能把瓶颈从“锁”转成 CPU、I/O、WAL 或存储容量。
选择操作时同时看锁和恢复路径
如果业务能接受短暂写暂停,普通 CREATE INDEX 通常更快、流程也更简单;如果是持续写入的大表,优先评估 CREATE INDEX CONCURRENTLY。索引重建同理,生产高流量表通常应先考虑 REINDEX CONCURRENTLY,而不是把普通 REINDEX 当作无感维护。
真正可控的索引变更,应在执行前明确四件事:允许阻塞哪些请求、最多等锁多久、失败后会留下什么对象、如何验证索引最终有效。只比较命令耗时而忽略这四点,很容易把一次“性能优化”变成新的锁事故。