
PostgreSQL / 系统课时
编写锁故障排查 Runbook
编写锁故障排查 Runbook
锁故障最怕边查边猜、先杀会话后补证据。本篇把生产处置固化为可执行 Runbook:先发现等待,再还原阻塞关系,按风险选择动作,最后验证恢复并保留可复盘证据。
学习目标
- 用
pg_stat_activity与pg_blocking_pids()快速确认锁等待和疑似根阻塞。 - 按“取证 → 定位 → 处置 → 验证”顺序选择等待、取消、回滚或终止会话。
- 为一次锁故障留下足够证据,并把临时处置转成长期治理项。
先确认是不是锁故障
告警可能来自连接数上涨、接口超时或 SQL 变慢,但这些现象不等于锁阻塞。第一步只做只读采样:找 wait_event_type = 'Lock' 的等待者,同时把 idle in transaction 的长事务纳入视野,因为它们常常没有正在执行的 SQL,却仍可能持锁。
SELECT
    a.pid,
    a.application_name,
    a.usename,
    a.state,
    a.wait_event_type,
    a.wait_event,
    clock_timestamp() - a.xact_start AS xact_age,
    pg_blocking_pids(a.pid) AS blocking_pids,
    left(a.query, 120) AS query_sample
FROM pg_stat_activity AS a
WHERE a.datname = current_database()
  AND (
      a.wait_event_type = 'Lock'
      OR a.state = 'idle in transaction'
  )
ORDER BY a.xact_start NULLS LAST, a.pid;
预期输出:实际 PID、等待时长和 SQL 会不同;至少应能区分等待者与仍处于事务中的会话。
 pid     | application_name | state               | wait_event_type | wait_event    | xact_age | blocking_pids | query_sample
---------+------------------+---------------------+-----------------+---------------+----------+---------------+-----------------------------
 <PID_A> | api              | idle in transaction | <TYPE>          | <EVENT>       | 00:01:12 | {}            | UPDATE orders SET ...
<PID_B> | api | active | Lock | transactionid | 00:00:09 | {<PID_A>} | UPDATE orders SET ...不要只按“事务最老”直接认定根因。等待者可能被多个会话阻塞,队列中也可能存在软阻塞;pg_blocking_pids() 比手工把 pg_locks 自连接更适合先回答“谁挡住了谁”。
还原阻塞边再找根节点
把每个等待 PID 展开成“等待者 → 阻塞者”边,能快速看出一对一、一对多以及链式阻塞。生产上应同时记录应用名、用户、事务年龄和 SQL 摘要,避免只拿一个 PID 做处置依据。
WITH edges AS (
    SELECT
        a.pid AS waiter_pid,
        b.blocker_pid
    FROM pg_stat_activity AS a
    CROSS JOIN LATERAL unnest(pg_blocking_pids(a.pid)) AS b(blocker_pid)
)
SELECT
    e.waiter_pid,
    wa.application_name AS waiter_app,
    e.blocker_pid,
    ba.application_name AS blocker_app,
    ba.state AS blocker_state,
    clock_timestamp() - ba.xact_start AS blocker_xact_age,
    left(ba.query, 100) AS blocker_query
FROM edges AS e
LEFT JOIN pg_stat_activity AS wa
    ON wa.pid = e.waiter_pid
LEFT JOIN pg_stat_activity AS ba
    ON ba.pid = e.blocker_pid
ORDER BY e.blocker_pid, e.waiter_pid;
预期输出:同一个 blocker_pid 被多行引用时,说明它同时影响多个等待者;若阻塞者本身也出现在 waiter_pid 中,则还要继续向上追。
 waiter_pid | waiter_app | blocker_pid | blocker_app | blocker_state       | blocker_xact_age | blocker_query
------------+------------+-------------+-------------+---------------------+------------------+-----------------------------
 <PID_B>    | api        | <PID_A>     | api         | idle in transaction | 00:01:21         | UPDATE orders SET ...
 <PID_C>    | worker     | <PID_A>     | api         | idle in transaction | 00:01:21         | UPDATE orders SET ...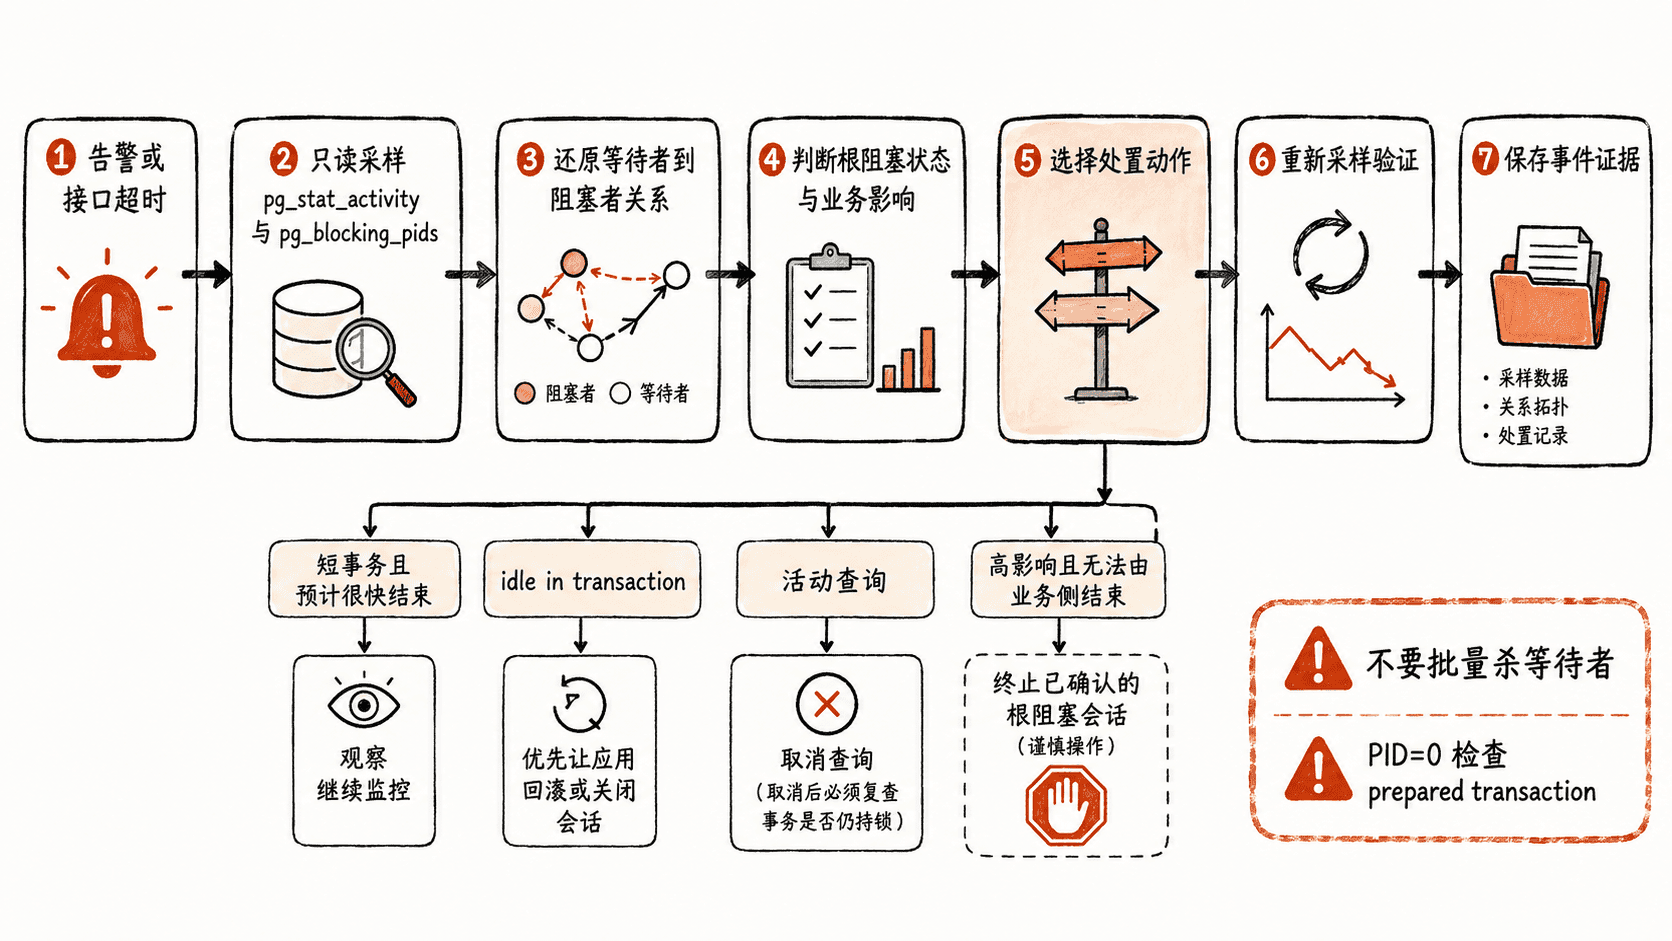
处置前先做风险判断
处置目标是结束造成阻塞的事务,不是让监控图暂时变绿。先停止或限流会继续制造等待的新请求,再确认根阻塞的应用、业务动作、事务年龄和负责人。能由业务侧正常提交或回滚时,优先让业务完成事务。
pg_cancel_backend() 只取消目标后台当前正在执行的查询;在显式事务里,取消查询并不等价于会话已经结束,也不能把“函数返回 true”当成锁已释放。pg_terminate_backend() 会终止会话,通常用于业务无法自行结束事务且影响持续扩大的场景。
下面是处置模板,执行前必须把 <PID> 替换为刚刚复核过的根阻塞 PID,并确认权限与业务影响。
SELECT pg_cancel_backend(<PID>);
SELECT pg_terminate_backend(<PID>);
预期输出:权限足够且目标 PID 仍存在时,函数通常返回 t;这只说明信号发送成功,是否真正恢复仍要用后续查询验证。
 pg_cancel_backend
-------------------
 t

 pg_terminate_backend
----------------------
t用退出条件判断是否恢复
根阻塞消失后,不能只看一条 SQL 成功就宣布结束。重新采样当前数据库的锁等待数量,并观察应用侧连接池、超时率和吞吐是否回落;若等待者只是换了一个新的 blocker,Runbook 仍未完成。
SELECT
    count(*) FILTER (WHERE wait_event_type = 'Lock') AS lock_waiters,
    COALESCE(
        (max(clock_timestamp() - query_start)
            FILTER (WHERE wait_event_type = 'Lock'))::text,
        'none'
    ) AS oldest_lock_wait
FROM pg_stat_activity
WHERE datname = current_database();
预期输出:没有剩余锁等待时应为 0 和 none。
 lock_waiters | oldest_lock_wait
--------------+-----------------
 0            | none
生产退出条件至少包括:根阻塞事务已经结束、等待队列持续下降且不再生成同类等待、关键接口恢复、连接池不再逼近上限。若仍有异常,重新从阻塞边开始追,不要继续沿用旧 PID 推断。
保留证据并转成治理项
事件记录应保存采样时间、数据库、等待者和阻塞者 PID、application_name、用户、事务年龄、SQL 摘要、处置人、处置动作及恢复时间,并关联同时间段的 PostgreSQL 日志和应用请求标识。PID 会被复用,因此事件中必须带时间上下文。
复盘时重点追“为什么事务活了这么久”:是否把远程调用放进事务、异常路径漏掉回滚、连接池把会话长期留在 idle in transaction,或缺少合适的锁等待保护。idle_in_transaction_session_timeout、按角色或应用设置的 lock_timeout、锁等待日志和事务时长监控都可以成为护栏,但它们不能替代正确的事务边界。Runbook 的价值不是教人快速杀连接,而是让每次处置都有证据、有停止条件,也能留下下一次不再发生的改进项。