
PostgreSQL / 系统课时
设计并发任务领取模式
设计并发任务领取模式
多个 Worker 从同一张任务表取活时,直接 SELECT 再 UPDATE 容易重复领取,而普通 FOR UPDATE 又可能让 Worker 排队阻塞。本课用 FOR UPDATE SKIP LOCKED 构造短事务领取流程,并把吞吐、公平性和宕机后的任务恢复边界一起设计清楚。
学习目标
- 使用锁定读取与
SKIP LOCKED让多个 Worker 并发领取不同任务 - 把“领取”与“执行”拆开,避免长事务持续持有行锁
- 理解
SKIP LOCKED的非严格公平性,并为 Worker 宕机设计超时恢复与幂等处理
为什么要跳过已锁定任务
任务队列表通常希望“谁先抢到谁处理”。如果多个 Worker 同时执行普通 SELECT ... FOR UPDATE,后到的事务会等待前一个事务释放目标行;当队列里还有大量可处理任务时,这种等待会浪费并行度。
SKIP LOCKED 会让锁定读取跳过当前无法立即加锁的候选行,继续寻找后面的可用行。因此它很适合队列式消费,但它返回的是一个刻意忽略被锁行的视图,不适合作为要求完整一致结果的普通业务查询。
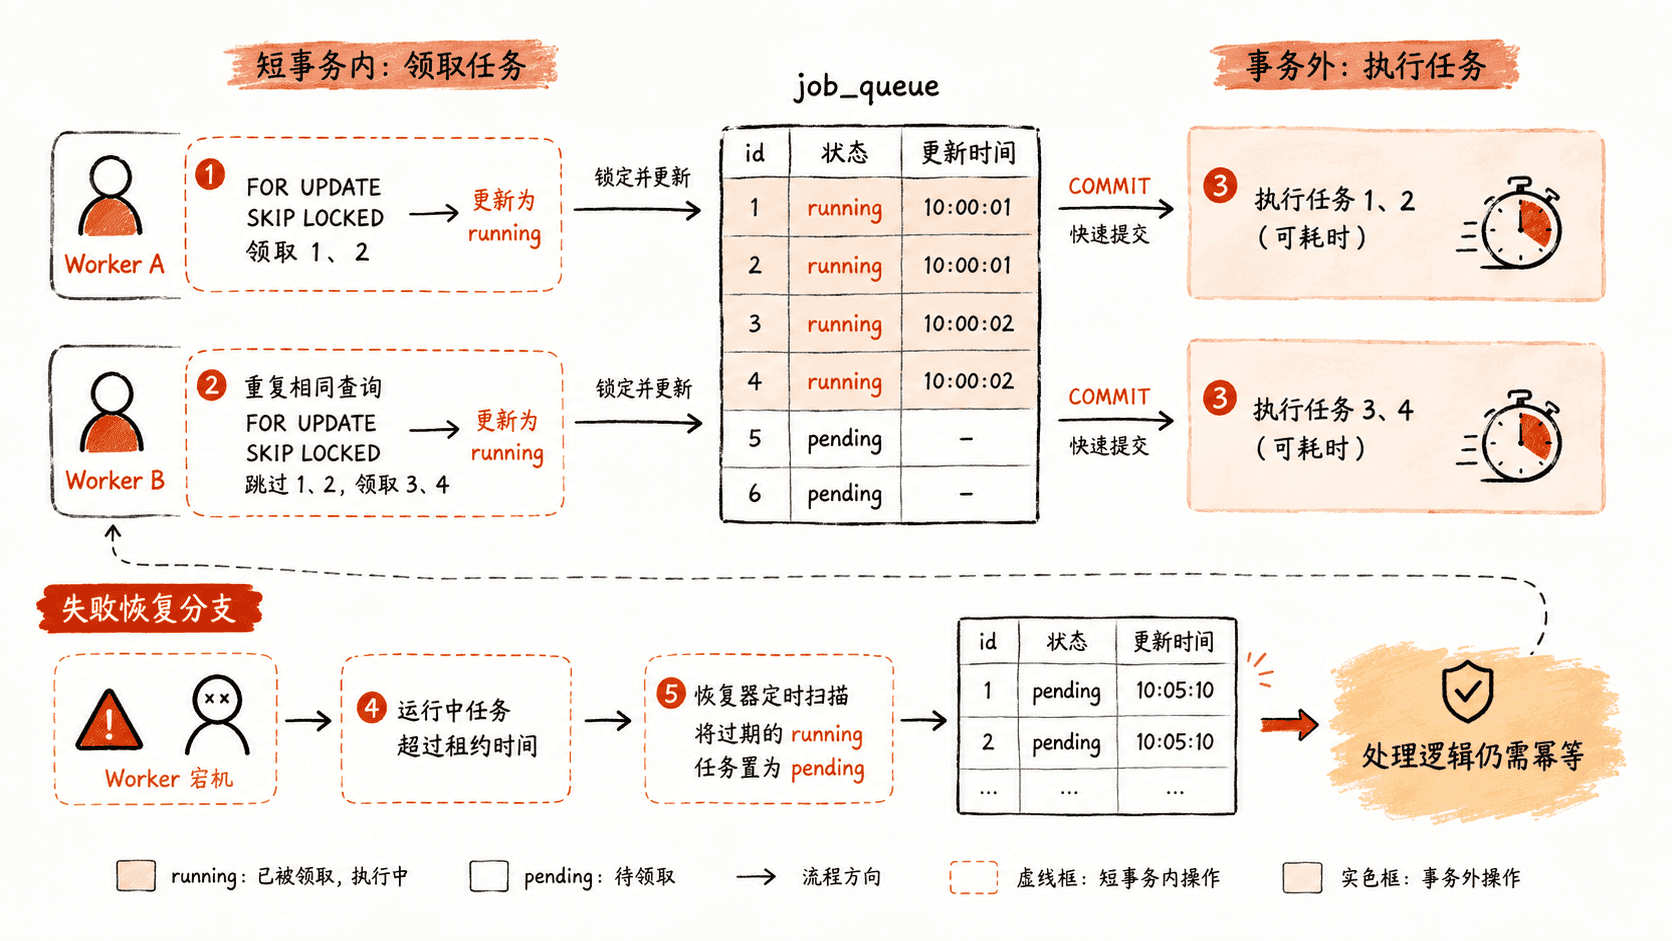
用一个原子语句完成领取
核心做法是把“选择待处理任务”和“把它标成已领取”放在同一个短事务中。下面是片段示例:CTE 先锁住最多两条 pending 任务,再在同一语句中更新为 running。ORDER BY available_at, id 提供稳定的候选顺序,SKIP LOCKED 则允许其他 Worker 跳过当前已经被锁的行。
WITH picked AS (
    SELECT id
    FROM job_queue
    WHERE status = 'pending'
      AND available_at <= now()
    ORDER BY available_at, id
    FOR UPDATE SKIP LOCKED
    LIMIT 2
)
UPDATE job_queue AS j
SET status = 'running',
    locked_by = $1,
    locked_at = clock_timestamp()
FROM picked
WHERE j.id = picked.id
RETURNING j.id, j.status, j.locked_by;
这是供应用程序参数化执行的 SQL 片段,$1 需要由 PostgreSQL 客户端绑定为当前 Worker 的唯一实例标识。语句返回的行就是本次成功领取的任务;事务提交后,应尽快离开数据库事务,再执行真正耗时的业务逻辑。
验证两个 Worker 不会互相排队
下面的 Python 程序依赖 psycopg 3,并通过 POSTGRES_DSN 连接测试数据库。Worker A 领取任务后故意保持事务一秒;Worker B 在 A 仍持锁时开始领取。由于使用 SKIP LOCKED,B 不等待 A 的任务,而是直接得到后面的任务。
import os
import threading
import time

import psycopg

DSN = os.environ["POSTGRES_DSN"]

CLAIM_SQL = """
WITH picked AS (
    SELECT id
    FROM job_queue
    WHERE status = 'pending'
      AND available_at <= now()
    ORDER BY available_at, id
    FOR UPDATE SKIP LOCKED
    LIMIT 2
)
UPDATE job_queue AS j
SET status = 'running',
    locked_by = %s,
    locked_at = clock_timestamp()
FROM picked
WHERE j.id = picked.id
RETURNING j.id
"""

def setup():
    with psycopg.connect(DSN) as conn:
        conn.execute("DROP TABLE IF EXISTS job_queue")
        conn.execute(
            "CREATE TABLE job_queue ("
            "id bigserial PRIMARY KEY, "
            "status text NOT NULL, "
            "available_at timestamptz NOT NULL, "
            "locked_by text, locked_at timestamptz)"
        )
        conn.execute(
            "INSERT INTO job_queue(status, available_at) "
            "SELECT 'pending', now() FROM generate_series(1, 5)"
        )
        conn.execute(
            "CREATE INDEX job_queue_pending_order_idx "
            "ON job_queue (available_at, id) WHERE status = 'pending'"
        )

def claim(worker, hold_seconds=0, locked_event=None):
    with psycopg.connect(DSN) as conn:
        with conn.transaction():
            rows = conn.execute(CLAIM_SQL, (worker,)).fetchall()
            ids = sorted(row[0] for row in rows)
            print(f"{worker}: {ids}")

            # 通知另一个线程:本事务已经锁定并更新了这些任务。
            if locked_event is not None:
                locked_event.set()
            if hold_seconds:
                time.sleep(hold_seconds)

def main():
    setup()
    a_locked = threading.Event()

    worker_a = threading.Thread(target=claim, args=("worker-a", 1, a_locked))
    worker_a.start()
    a_locked.wait(timeout=5)

    worker_b = threading.Thread(target=claim, args=("worker-b",))
    worker_b.start()

    worker_a.join()
    worker_b.join()

if __name__ == "__main__":
    main()
预期输出:
worker-a: [1, 2]
worker-b: [3, 4]
如果去掉 SKIP LOCKED,Worker B 会在 A 持锁期间等待,而不是立即领取 3、4。生产代码仍应让领取事务尽量短:领取并提交后再处理任务,否则单个慢任务会把数据库锁的持有时间扩展到整个业务执行阶段。
处理公平性与失败恢复
ORDER BY available_at, id 只能保证每个 Worker 在当前可锁定集合中优先选择更早到期、再选择较小 ID;已经被别的事务锁住的老任务会被跳过,所以这不是严格 FIFO。队列吞吐通常因此提高,但如果业务要求强公平、全局顺序或同一键严格串行,就需要分区队列、单消费者或额外协调机制,而不能只靠 SKIP LOCKED。
领取事务一旦提交,数据库行锁就释放了,因此任务是否“仍归某个 Worker 所有”必须由持久化字段表示,例如 status、locked_by 和 locked_at。如果 Worker 在提交领取后宕机,任务会停留在 running,恢复器可以把超过租约时间的任务重新放回队列。
UPDATE job_queue
SET status = 'pending',
    locked_by = NULL,
    locked_at = NULL
WHERE status = 'running'
  AND locked_at < clock_timestamp() - interval '5 minutes';
预期结果:
UPDATE <VALUE>实际恢复行数取决于当前过期任务数量。租约过短会让仍在执行的任务被重复领取,因此长任务通常需要续租心跳;即使有租约,也应把任务处理设计成幂等,因为 Worker 可能在外部副作用已经发生、但“标记 done”之前崩溃。SKIP LOCKED 解决的是并发领取时的锁等待,不是端到端的 exactly-once 保证。