
PostgreSQL / 系统课时
设计阻塞与死锁告警
设计阻塞与死锁告警
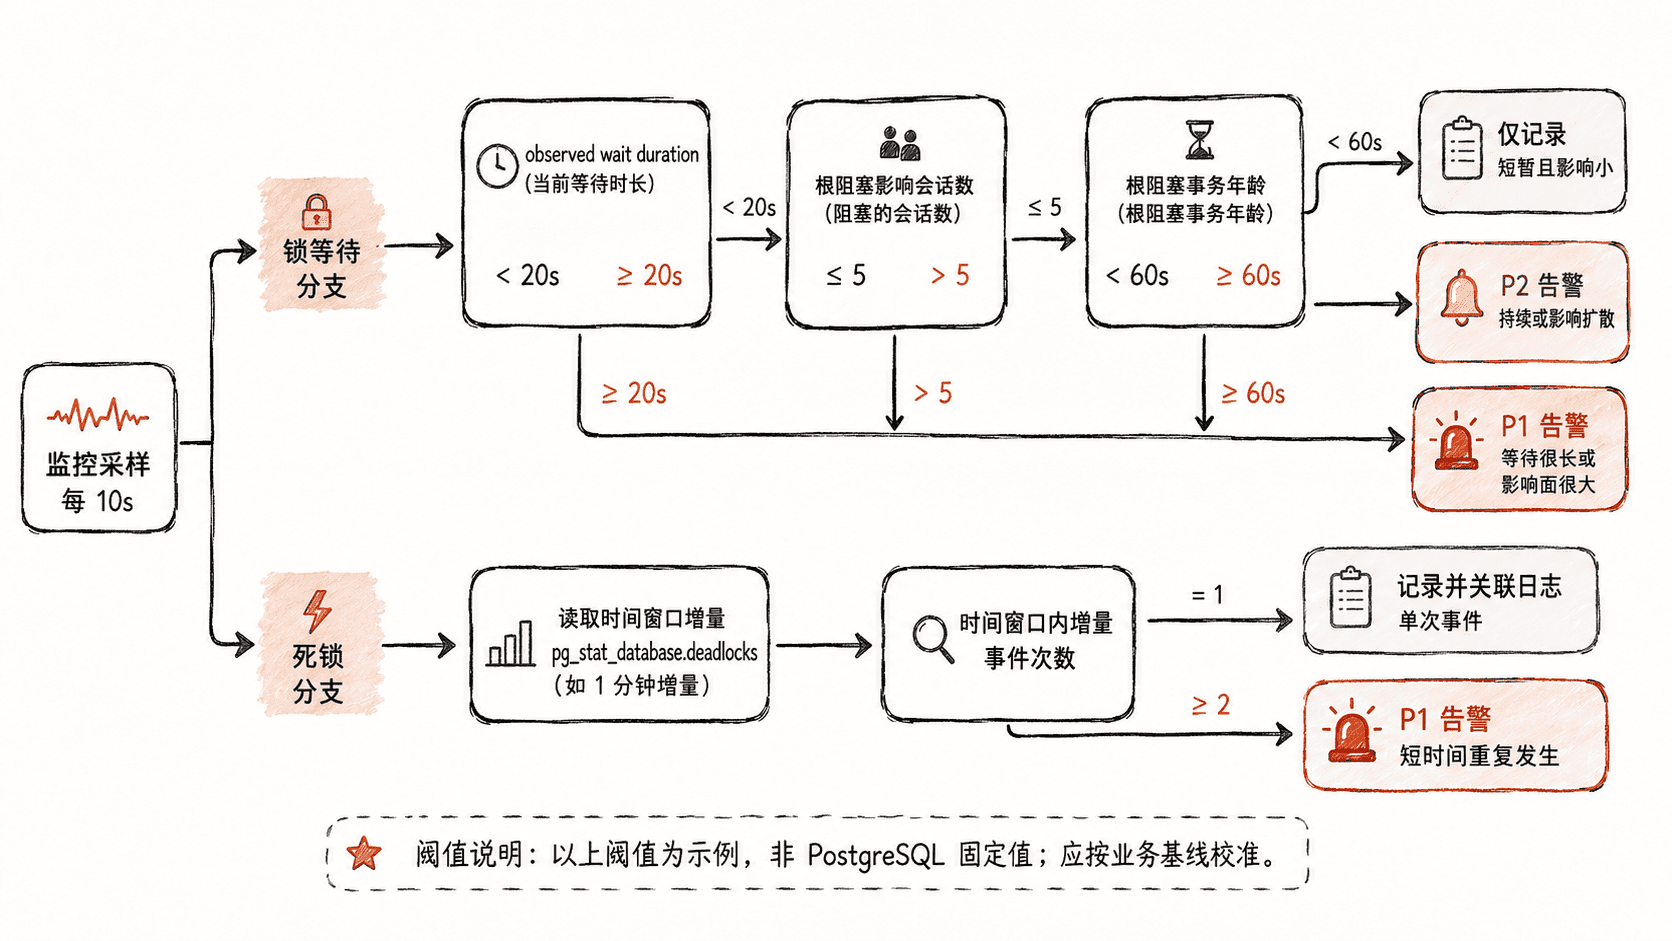
生产锁告警的目标不是“看到一次等待就报警”,而是尽早发现会持续放大业务影响的竞争。本课把等待持续时间、受影响会话数、根阻塞事务年龄和死锁增量组合起来,形成可分级、可降噪、能直接进入处置流程的告警模型。
学习目标
- 区分锁等待快照、根阻塞影响范围与死锁计数各自回答的问题
- 用 PostgreSQL 系统视图采集可用于告警的阻塞上下文
- 设计分级阈值、持续时间和告警上下文,降低瞬时竞争噪声
把四类信号放到同一告警模型
单看“存在锁等待”通常噪声很大。短事务并发时,等待可能只持续几十毫秒;真正值得升级的是等待持续变长、受影响会话扩散,或根阻塞事务长时间不结束。死锁又不同:PostgreSQL 会检测并中止其中一个事务,因此它更适合按时间窗口统计增量,而不是把累计值直接当阈值。
| 信号 | 建议含义 | 主要用途 |
|---|---|---|
| 等待持续时间 | 监控端首次观察到 wait_event_type = 'Lock' 后持续多久 |
过滤瞬时竞争 |
| 受影响会话数 | 一个根阻塞者直接或间接阻塞多少会话 | 衡量爆炸半径 |
| 根阻塞事务年龄 | clock_timestamp() - xact_start |
识别长事务、空闲事务 |
| 死锁增量 | 一段时间内 pg_stat_database.deadlocks 的增长量 |
识别重复死锁模式 |
不要把 query_start 直接等同于“开始等锁的时间”。系统视图没有提供通用的锁等待起始时间;采集器应在第一次观察到 Lock 等待时记录 first-seen 时间,后续采样才能得到更可靠的等待持续时间。
采集根阻塞与死锁计数
下面的查询把当前数据库中的等待关系展开成边,再找出“不再被别人阻塞”的根阻塞会话,并统计其直接或间接影响范围。max_blocked_query_age 只是等待查询年龄的近似上界;真正的告警等待时长仍应由监控端按 first-seen 计算。
WITH RECURSIVE edges AS (
    SELECT
        a.pid AS blocked_pid,
        b.blocker_pid
    FROM pg_stat_activity AS a
    CROSS JOIN LATERAL unnest(pg_blocking_pids(a.pid)) AS b(blocker_pid)
    WHERE a.datname = current_database()
),
roots AS (
    SELECT DISTINCT e.blocker_pid AS root_pid
    FROM edges AS e
    WHERE e.blocker_pid <> 0
      AND NOT EXISTS (
          SELECT 1
          FROM edges AS parent
          WHERE parent.blocked_pid = e.blocker_pid
      )
),
impact(root_pid, blocked_pid) AS (
    SELECT r.root_pid, e.blocked_pid
    FROM roots AS r
    JOIN edges AS e ON e.blocker_pid = r.root_pid

    UNION

    SELECT i.root_pid, e.blocked_pid
    FROM impact AS i
    JOIN edges AS e ON e.blocker_pid = i.blocked_pid
)
SELECT
    i.root_pid,
    count(DISTINCT i.blocked_pid) AS affected_sessions,
    max(clock_timestamp() - w.query_start) AS max_blocked_query_age,
    clock_timestamp() - root.xact_start AS root_xact_age,
    root.usename,
    root.application_name,
    root.state
FROM impact AS i
JOIN pg_stat_activity AS w ON w.pid = i.blocked_pid
JOIN pg_stat_activity AS root ON root.pid = i.root_pid
GROUP BY
    i.root_pid,
    root.xact_start,
    root.usename,
    root.application_name,
    root.state
ORDER BY affected_sessions DESC;

SELECT datname, deadlocks
FROM pg_stat_database
WHERE datname = current_database();
预期输出
 root_pid | affected_sessions | max_blocked_query_age | root_xact_age | usename | application_name | state
 <PID>    | <VALUE>           | <INTERVAL>            | <INTERVAL>    | <USER>  | <APP>            | <STATE>

 datname  | deadlocks
 <DB_NAME>| <VALUE>
实际 PID、时间间隔、应用名和累计死锁数会随环境变化。如果第一条查询没有返回行,说明采样时没有可识别的根阻塞链;如果 pg_blocking_pids() 返回 0,要另外检查 prepared transaction,而不是把 0 当成普通后端 PID。
用分级阈值过滤瞬时竞争
阈值必须从业务延迟目标和历史基线反推,不能把某组数字当成 PostgreSQL 的“标准答案”。可以先用一组保守模板上线观察:等待超过 1 秒只记事件;等待超过 5 秒且影响至少 3 个会话,或根阻塞事务超过 60 秒时进入 P2;等待超过 30 秒、影响会话数达到较大规模,或关键链路已经出现错误时进入 P1。
死锁建议每次都记录事件,但分页告警看“窗口增量”。例如 10 分钟内连续出现多次死锁再升级,比对累计 deadlocks 是否大于某个固定数字更可靠。监控系统还要处理统计重置导致的计数回落,避免把重置误判为异常。
让告警直接支持处置
告警消息至少应包含数据库、根阻塞 PID、数据库用户、application_name、客户端来源、根事务年龄、受影响会话数和触发阈值。SQL 文本可以截断或指纹化,避免把敏感参数直接发送到聊天工具。
上线前用受控并发实验制造一次短等待和一次持续等待,确认短等待只留下事件、持续等待按预期升级,同时检查死锁告警使用的是时间窗口增量。这样告警才真正回答“是否需要介入、介入哪一个根阻塞者”,而不是只告诉值班人员“数据库里有锁”。