
PostgreSQL / 系统课时
设计死锁后的安全重试
设计死锁后的安全重试
死锁并不意味着数据库损坏,而是 PostgreSQL 为打破循环等待主动中止其中一个事务。本课把死锁当作可识别的事务级失败:整笔回滚、有限次数重试、加入随机退避,并用幂等键保证“重放事务”不会重复产生业务效果。
学习目标
- 识别 PostgreSQL 死锁错误并按整笔事务而不是单条 SQL 重试
- 设计有上限的指数退避与抖动,避免大量请求同步再次碰撞
- 用幂等键和提交边界控制重试后的重复扣款、重复发消息等风险
把死锁视为事务级失败
PostgreSQL 检测到等待环后,会选择一个事务中止,并返回 SQLSTATE 40P01(deadlock_detected)。此时该事务已经失败,后续语句不能靠“再执行一次刚才的 UPDATE”继续完成;应用必须让当前事务回滚,再从事务入口重新执行业务步骤。
安全路径因此是:捕获 40P01 → 回滚整笔事务 → 判断是否还有重试预算 → 退避 → 用同一个业务请求标识重新开始事务。连接本身通常可以继续使用,但任何连接池封装都应确认失败事务已经完成回滚后再归还连接。
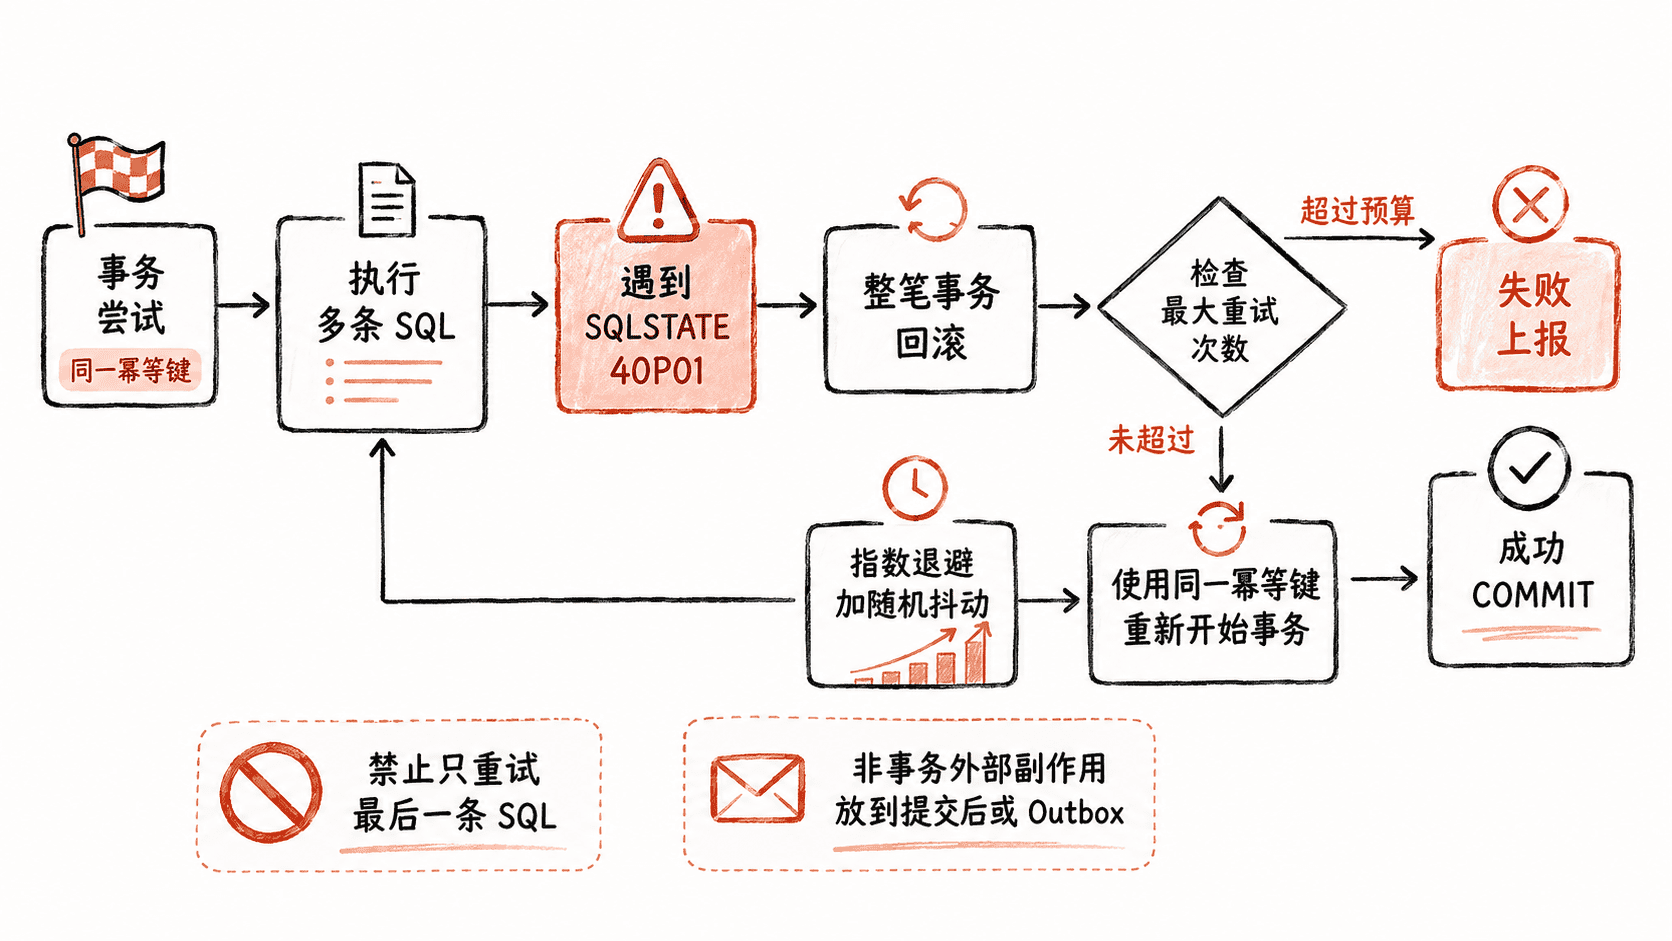
让重试有界并可幂等
重试次数必须有限。常用做法是第 次失败后,把等待上限按指数增长,再加入随机抖动,例如在 内随机等待。抖动的目的不是让单个请求更快,而是打散一批同时失败的事务,避免它们在固定间隔后再次同时抢锁。
幂等要覆盖整个业务效果。把请求唯一标识写入与业务修改相同的数据库事务,并用唯一约束拒绝重复请求;如果事务因死锁回滚,这条幂等记录也会回滚,下一次可以安全重试。如果事务已经提交但客户端未收到成功响应,同一个请求标识再次进入时则能识别“已经完成”。
用完整事务边界实现重试
下面的 Python 程序依赖 psycopg 3,并通过环境变量 POSTGRES_DSN 连接测试数据库。它同时启动两个方向相反的转账事务,第一次尝试故意按相反顺序锁定两行,从而形成死锁;被 PostgreSQL 中止的一方捕获 DeadlockDetected 后回滚、随机退避并重放整笔事务。每个请求都有唯一 request_id,因此即使发生“提交成功但客户端不知道”的场景,再次执行也不会重复转账。
import os
import random
import threading
import time
import uuid

import psycopg
from psycopg.errors import DeadlockDetected

DSN = os.environ["POSTGRES_DSN"]
MAX_ATTEMPTS = 3
BASE_DELAY = 0.05
CAP_DELAY = 0.5

def setup():
    with psycopg.connect(DSN) as conn:
        conn.execute("DROP TABLE IF EXISTS transfer_request")
        conn.execute("DROP TABLE IF EXISTS account")
        conn.execute(
            "CREATE TABLE account (id integer PRIMARY KEY, balance integer NOT NULL)"
        )
        conn.execute(
            "CREATE TABLE transfer_request ("
            "request_id uuid PRIMARY KEY, "
            "from_id integer NOT NULL, to_id integer NOT NULL, amount integer NOT NULL)"
        )
        conn.execute("INSERT INTO account VALUES (1, 100), (2, 100)")

def transfer(name, request_id, from_id, to_id, amount, first_attempt_barrier):
    for attempt in range(1, MAX_ATTEMPTS + 1):
        try:
            with psycopg.connect(DSN) as conn:
                with conn.transaction():
                    cur = conn.cursor()

                    # 幂等记录与余额修改处在同一事务,回滚和提交保持一致。
                    cur.execute(
                        "INSERT INTO transfer_request VALUES (%s, %s, %s, %s) "
                        "ON CONFLICT (request_id) DO NOTHING RETURNING request_id",
                        (request_id, from_id, to_id, amount),
                    )
                    if cur.fetchone() is None:
                        print(f"{name}: request already committed")
                        return

                    cur.execute("SELECT id FROM account WHERE id = %s FOR UPDATE", (from_id,))
                    cur.fetchone()

                    # 仅第一次同步两个线程,稳定制造“各持一把锁再等另一把”的死锁。
                    if attempt == 1:
                        first_attempt_barrier.wait(timeout=5)

                    cur.execute("SELECT id FROM account WHERE id = %s FOR UPDATE", (to_id,))
                    cur.fetchone()
                    cur.execute(
                        "UPDATE account SET balance = balance - %s WHERE id = %s",
                        (amount, from_id),
                    )
                    cur.execute(
                        "UPDATE account SET balance = balance + %s WHERE id = %s",
                        (amount, to_id),
                    )

            print(f"{name}: committed on attempt {attempt}")
            return
        except DeadlockDetected:
            if attempt == MAX_ATTEMPTS:
                raise
            limit = min(CAP_DELAY, BASE_DELAY * (2 ** (attempt - 1)))
            delay = random.uniform(0, limit)
            print(f"{name}: deadlock on attempt {attempt}, retry after {delay:.3f}s")
            time.sleep(delay)

def main():
    setup()
    barrier = threading.Barrier(2)
    jobs = [
        threading.Thread(
            target=transfer,
            args=("A", uuid.uuid4(), 1, 2, 10, barrier),
        ),
        threading.Thread(
            target=transfer,
            args=("B", uuid.uuid4(), 2, 1, 10, barrier),
        ),
    ]

    for job in jobs:
        job.start()
    for job in jobs:
        job.join()

    with psycopg.connect(DSN) as conn:
        rows = conn.execute("SELECT id, balance FROM account ORDER BY id").fetchall()
        print(rows)

if __name__ == "__main__":
    main()
预期输出之一如下。哪一个事务被选为死锁牺牲者不固定,退避时间也会变化,但应当只出现一个请求进入重试,最终两个请求都只提交一次。
<VALUE>: deadlock on attempt 1, retry after <TIME>s
<VALUE>: committed on attempt 1
<VALUE>: committed on attempt 2
[(1, 100), (2, 100)]
确定哪些错误值得重试
40P01 是典型的可重试并发错误,但“可重试”不等于“无限重试”。连接失败、语法错误、约束违反或业务校验失败都有不同语义,不能全部塞进同一个重试器。若使用 SERIALIZABLE 隔离级别,SQLSTATE 40001(serialization_failure)也通常要求重放整笔事务,但它与死锁的触发原因不同,应分别记录指标。
重试耗尽后要把失败返回给上层,并至少记录 SQLSTATE、尝试次数、事务对应的业务请求标识和可关联的链路信息。若死锁频繁出现,重试只能削弱瞬时影响,真正的治理仍应回到固定加锁顺序、缩短事务、减少热点更新等根因修复。