
PostgreSQL / 系统课时
安全处置根阻塞事务
安全处置根阻塞事务
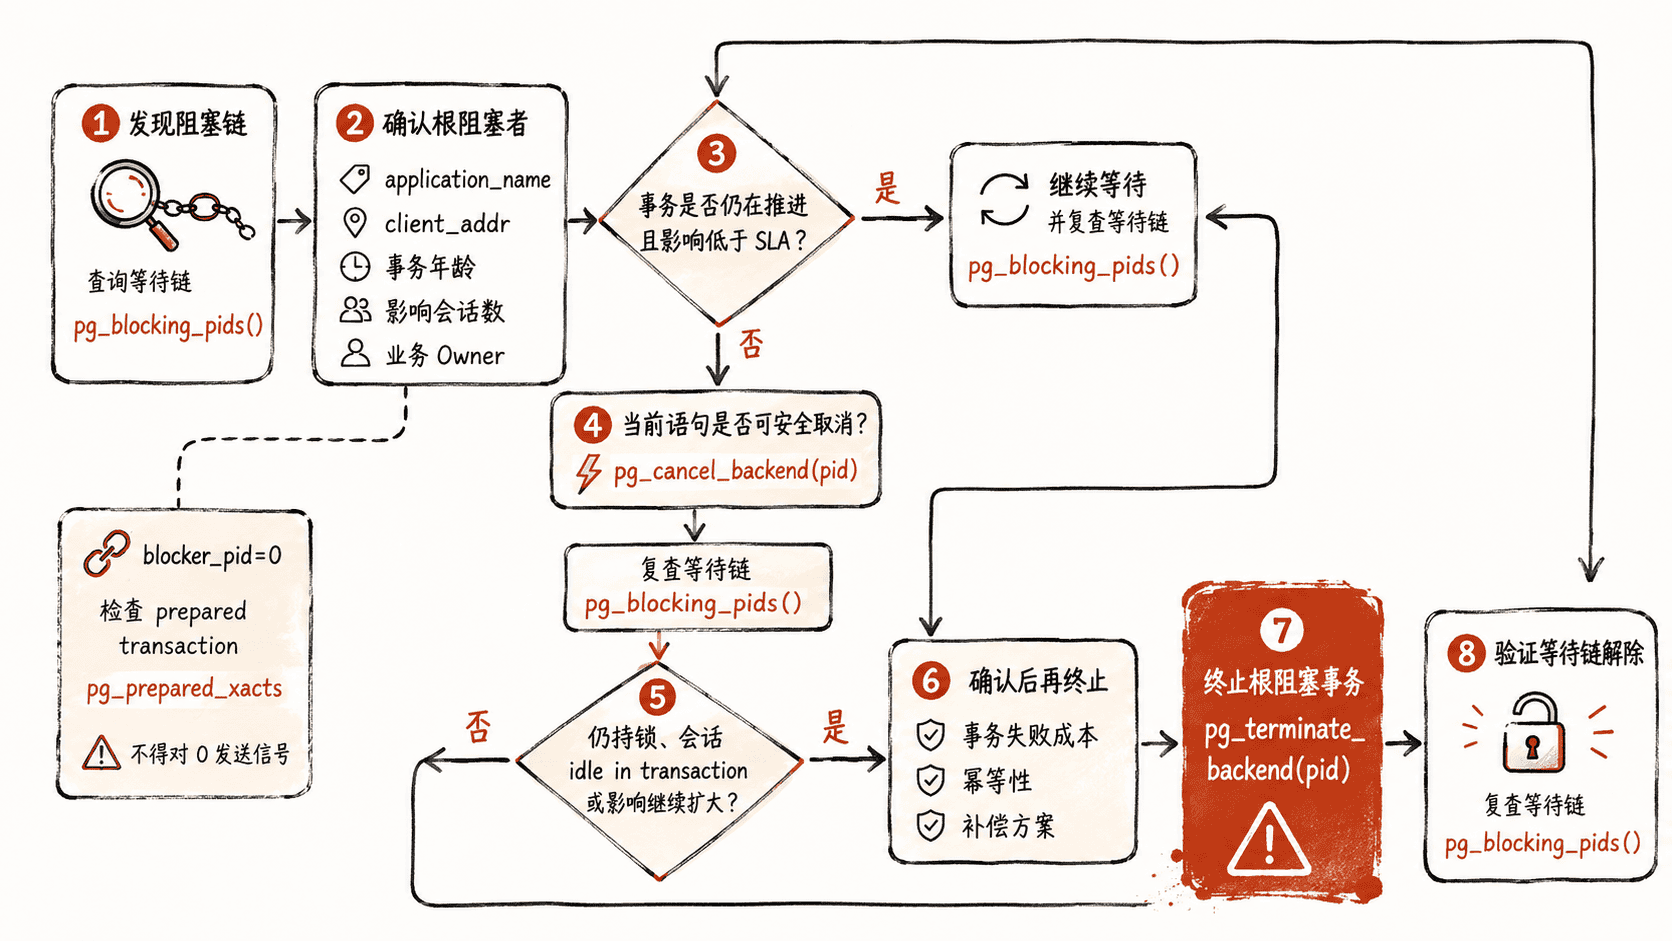
处理阻塞最危险的做法是看到一个旧事务就直接杀掉。正确路径是先确认它确实位于等待链根部,再核对业务来源、事务状态和终止影响,最后按照“等待 → 取消当前语句 → 终止会话”的最小破坏原则升级,并在每一步后重新验证阻塞链。
学习目标
- 找出真正的根阻塞会话,而不是误杀等待者或中间节点
- 判断等待、
pg_cancel_backend与pg_terminate_backend的使用边界 - 在终止会话前核对事务影响、业务来源和失败后的恢复路径
先确认根阻塞者和影响范围
根阻塞者是“正在阻塞别人,但自己不再等待另一个后端”的会话。下面的查询会计算每个根阻塞会话直接或间接影响的会话数,并带出事务年龄、连接来源和当前 SQL,便于在处置前联系业务 Owner。
WITH RECURSIVE edges AS (
    SELECT
        a.pid AS blocked_pid,
        b.blocker_pid
    FROM pg_stat_activity AS a
    CROSS JOIN LATERAL unnest(pg_blocking_pids(a.pid)) AS b(blocker_pid)
    WHERE a.datname = current_database()
),
roots AS (
    SELECT DISTINCT e.blocker_pid AS root_pid
    FROM edges AS e
    WHERE e.blocker_pid <> 0
      AND NOT EXISTS (
          SELECT 1
          FROM edges AS parent
          WHERE parent.blocked_pid = e.blocker_pid
      )
),
impact(root_pid, blocked_pid) AS (
    SELECT r.root_pid, e.blocked_pid
    FROM roots AS r
    JOIN edges AS e ON e.blocker_pid = r.root_pid

    UNION

    SELECT i.root_pid, e.blocked_pid
    FROM impact AS i
    JOIN edges AS e ON e.blocker_pid = i.blocked_pid
)
SELECT
    root.pid AS root_pid,
    count(DISTINCT i.blocked_pid) AS affected_sessions,
    root.usename,
    root.application_name,
    root.client_addr,
    root.state,
    clock_timestamp() - root.xact_start AS xact_age,
    left(root.query, 160) AS current_query
FROM impact AS i
JOIN pg_stat_activity AS root ON root.pid = i.root_pid
GROUP BY
    root.pid,
    root.usename,
    root.application_name,
    root.client_addr,
    root.state,
    root.xact_start,
    root.query
ORDER BY affected_sessions DESC;
预期输出
 root_pid | affected_sessions | usename | application_name | client_addr | state   | xact_age  | current_query
 <PID>    | <VALUE>           | <USER>  | <APP>            | <IP>        | <STATE> | <INTERVAL>| <SQL>
如果结果没有根节点但现场仍报告死锁,可能处于环形等待且数据库已经在执行死锁检测;如果阻塞者 PID 为 0,应检查 prepared transaction,不要对 PID 0 执行取消或终止函数。
先算清处置成本
“继续等”适合根事务仍在正常推进、预计能在业务 SLA 内结束的场景。pg_cancel_backend 只取消目标会话当前正在执行的语句,连接仍然存在;如果目标已经是 idle in transaction,取消语句通常不能结束这个事务,已持有的事务级锁也不会因此自动释放。
pg_terminate_backend 会终止会话并让其当前事务中止,破坏面明显更大。处置前要确认这是不是批处理、迁移、结算等不能随意重试的业务,还要评估应用是否具备幂等和重连能力。PostgreSQL 的事务中止并不是把每一行修改逐条物理“撤销”,但已经完成的业务工作、外部副作用和客户端重试仍可能带来显著成本。
| 选择 | 适合场景 | 主要风险 |
|---|---|---|
| 继续等待 | 根事务在推进,影响可控且未越过 SLA | 阻塞继续扩散 |
| 取消当前语句 | 当前 SQL 可安全失败并由应用处理 | 会话可能仍处于事务中并继续持锁 |
| 终止会话 | 影响已不可接受,且已确认业务与恢复方案 | 整个事务失败、连接断开、应用需要重试或补偿 |
按最小破坏原则升级
先尝试取消当前语句。下面是片段示例,需要把 <BLOCKER_PID> 替换为上一节确认过的根阻塞 PID;执行账号必须具备对目标后端发送信号的权限。
SELECT pg_cancel_backend(<BLOCKER_PID>);预期结果
 pg_cancel_backend
-------------------
 t
(1 row)
返回 t 表示取消信号已成功发送,不等于阻塞一定已经解除。立即重新查询等待链;如果目标会话仍在事务中持锁,或者它本来就是 idle in transaction,不要重复无意义地发送取消信号。
只有在影响已经不可接受、业务来源与失败后果都确认清楚后,才升级为终止会话。下面同样是需要替换 PID 的片段示例。
SELECT pg_terminate_backend(<BLOCKER_PID>);预期结果
 pg_terminate_backend
----------------------
 t
(1 row)
终止后,客户端会收到连接断开或事务失败,应用是否自动重试取决于自身实现。不要把这条命令放进“事务年龄超过阈值就自动执行”的无人值守脚本。
验证阻塞链真的解除
处置完成后,不要以函数返回 t 作为结束条件。重新检查是否还有会话把原根阻塞 PID 列为 blocker,同时观察业务错误率、连接池和重试量是否恢复。
下面的片段示例仍需替换同一个 <BLOCKER_PID>。
SELECT
    pid AS blocked_pid,
    pg_blocking_pids(pid) AS blocker_pids
FROM pg_stat_activity
WHERE <BLOCKER_PID> = ANY (pg_blocking_pids(pid))
ORDER BY pid;
预期结果
 blocked_pid | blocker_pids
-------------+--------------
(0 rows)
如果仍有结果,说明阻塞尚未解除或新的事务又形成了同样的等待关系,应重新定位而不是继续盲目终止会话。一次安全处置的验收标准是等待链消失、业务指标恢复,并且能解释被终止事务来自哪里、为什么允许它失败以及如何防止同类长事务再次成为根阻塞者。