
PostgreSQL / 系统课时
识别 DDL 的强锁风险
识别 DDL 的强锁风险
DDL 风险往往不在语句执行多久,而在它要先拿到什么表级锁。一个等待中的强锁请求还可能把后续本可并发的查询挡在队列后面。本课通过三个会话复现这种放大效应,并给出上线前的锁检查与超时策略。
学习目标
- 判断
ALTER TABLE、DROP TABLE、TRUNCATE等 DDL 的表级锁风险 - 复现等待中的
AccessExclusiveLock如何放大后续查询阻塞 - 使用
pg_locks、pg_blocking_pids()与lock_timeout控制变更风险
先看锁模式再看执行时间
普通 SELECT 会在目标表上取得 AccessShareLock,写入通常取得 RowExclusiveLock。AccessExclusiveLock 与所有表级锁模式冲突,因此它一旦获得,就连普通 SELECT 也不能并发访问同一张表。
DROP TABLE 和 TRUNCATE 会取得 AccessExclusiveLock。ALTER TABLE 则必须看具体子命令:很多形式使用 AccessExclusiveLock,并且没有特别说明更低锁级别时应按强锁评估。即使某个 ALTER TABLE 只是快速修改元数据,等锁时间仍可能远长于真正执行时间。
| 操作 | 典型表级锁风险 | 评估重点 |
|---|---|---|
TRUNCATE |
AccessExclusiveLock |
会阻塞同表普通读写 |
DROP TABLE |
AccessExclusiveLock |
需要排空同表并发访问 |
ALTER TABLE ... ADD COLUMN |
通常为 AccessExclusiveLock |
元数据操作可能很快,但拿锁前可能长时间等待 |
其他 ALTER TABLE 子命令 |
依具体子命令而定 | 必须按目标 PostgreSQL 版本核对具体锁级别 |
复现等待队列放大
先准备一张实验表。
DROP TABLE IF EXISTS ddl_lab;
CREATE TABLE ddl_lab (
    id bigint PRIMARY KEY,
    payload text NOT NULL
);
INSERT INTO ddl_lab (id, payload)
VALUES (1, 'ready');
预期输出:
DROP TABLE
CREATE TABLE
INSERT 0 1若表首次不存在,DROP TABLE IF EXISTS 可能额外打印 NOTICE。接下来使用三个独立会话。会话 A 开启事务并更新一行,持续持有目标表的 RowExclusiveLock。
SET application_name = 'ddl-holder';
BEGIN;
UPDATE ddl_lab
SET payload = 'held'
WHERE id = 1;
预期输出:
SET
BEGIN
UPDATE 1
不要提交 A。会话 B 请求一个需要强锁的 DDL,并设置 15 秒锁等待上限。
SET application_name = 'ddl-ddl';
SET lock_timeout = '15s';
ALTER TABLE ddl_lab ADD COLUMN note text;
A 的 RowExclusiveLock 与 B 请求的 AccessExclusiveLock 冲突,所以 B 会先等待;如果 15 秒内 A 一直不结束,预期最终输出为:
SET
SET
ERROR:  canceling statement due to lock timeout
在 B 仍处于等待的 15 秒窗口内,用观察会话检查目标表锁。pg_blocking_pids() 会直接告诉你等待者被哪些后端阻塞,不必自己猜锁冲突矩阵。
SELECT a.application_name,
       l.mode,
       l.granted,
       pg_blocking_pids(a.pid) AS blockers
FROM pg_stat_activity AS a
JOIN pg_locks AS l
  ON l.pid = a.pid
WHERE l.locktype = 'relation'
  AND l.relation = 'ddl_lab'::regclass
  AND a.application_name IN ('ddl-holder', 'ddl-ddl')
ORDER BY a.application_name, l.granted DESC;
预期能看到持锁者已授予、DDL 请求未授予;PID 会因环境而异:
 application_name |        mode         | granted | blockers
------------------+---------------------+---------+-----------
 ddl-ddl          | AccessExclusiveLock | f       | {<PID>}
 ddl-holder       | RowExclusiveLock    | t       | {}
现在趁 B 仍在等待,从会话 C 发起一个普通查询,并把锁等待限制为 2 秒。
SET application_name = 'ddl-reader';
SET lock_timeout = '2s';
SELECT count(*) FROM ddl_lab;
预期结果不是立即返回,而是超时:
SET
SET
ERROR:  canceling statement due to lock timeout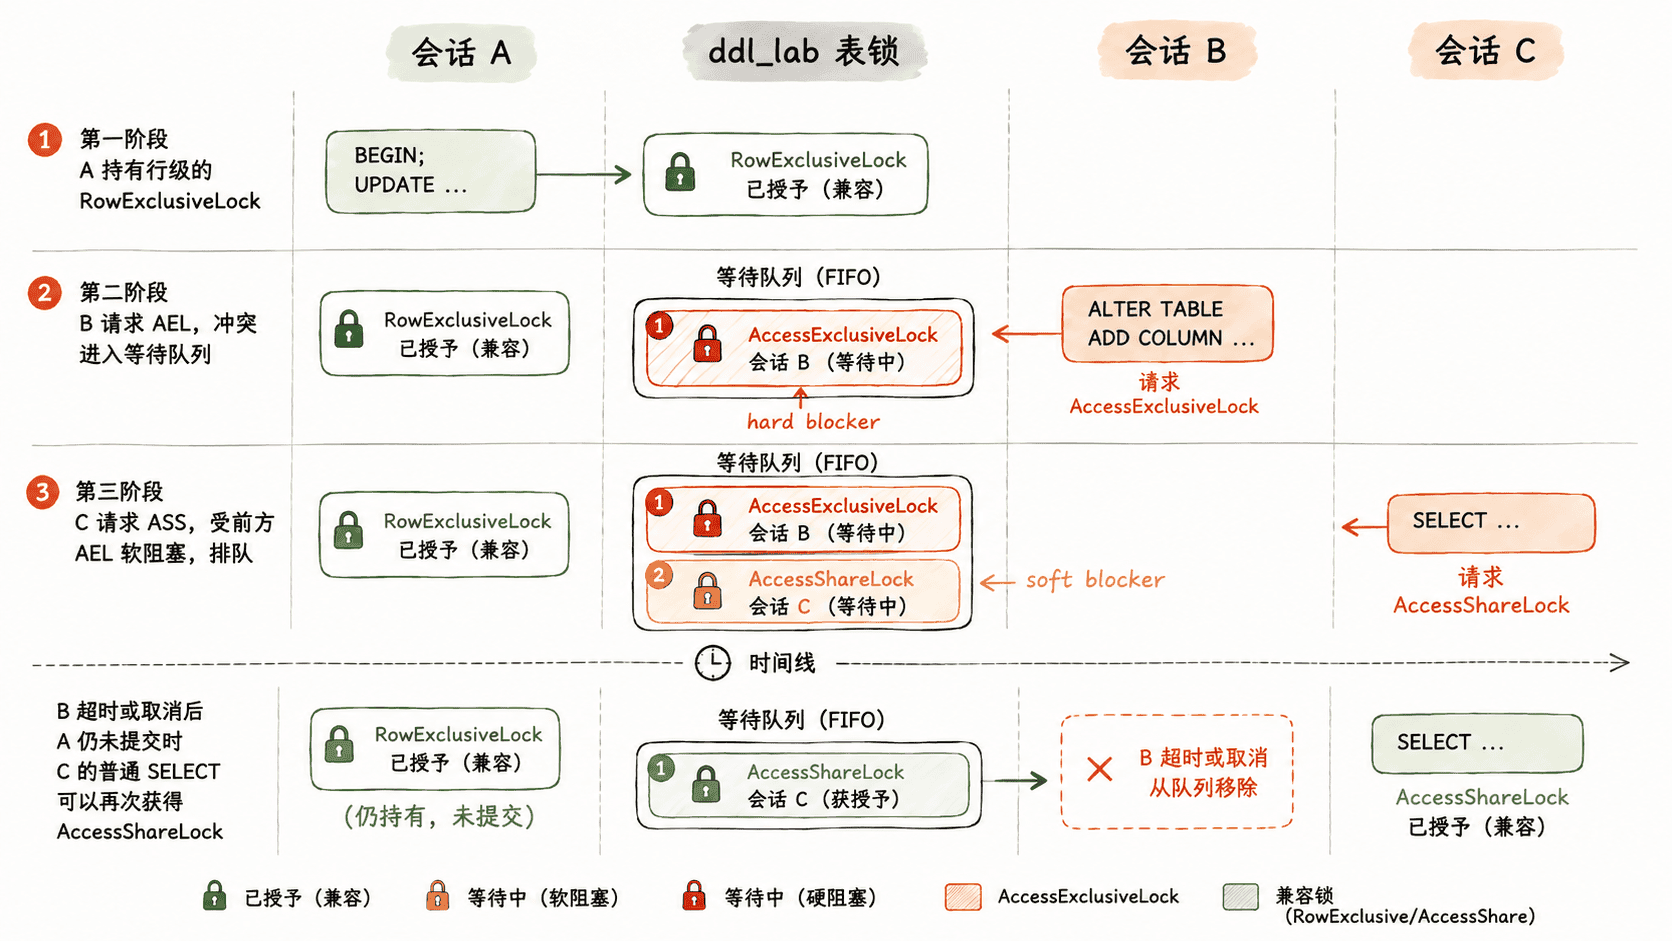
为什么后来的 SELECT 也会被挡住
关键不是 C 与 A 是否冲突,而是 B 已经在锁等待队列中排在 C 前面。PostgreSQL 会把“持有冲突锁的会话”视为 hard blocker,也会把“正在等待、且位于当前请求之前并与当前请求冲突的会话”视为 soft blocker。
因此,A 的 RowExclusiveLock 本来允许 C 的 AccessShareLock 并发存在,但如果系统绕过等待中的 B 持续放行新查询,B 的强锁可能长期饥饿。等待队列让 B 成为 C 的软阻塞者,于是一次 DDL 等锁会表现成越来越多新查询一起堆积。
等 B 因 lock_timeout 退出后,在 A 仍保持事务打开的前提下,再从 C 执行普通查询即可验证这一点。
SET lock_timeout = '2s';
SELECT count(*) FROM ddl_lab;
预期输出:
SET
 count
-------
     1
(1 row)
这次能立即返回,说明真正放大读阻塞的是排在队列前面的强锁请求,而不是 A 的普通写锁本身。实验结束后在 A 执行回滚释放锁。
ROLLBACK;预期输出:
ROLLBACK把 DDL 等锁变成可控失败
生产变更不要只估计“DDL 本身几秒能跑完”,而要先检查当前长事务、同表活跃写入和已有等待者。对必须在线执行的强锁 DDL,优先在会话级设置较短 lock_timeout:拿不到锁就退出本次尝试,避免一个等待中的 AccessExclusiveLock 长时间卡住后续业务请求。
变更期间若出现堆积,先用 pg_stat_activity 确认等待会话,再用 pg_blocking_pids(pid) 找直接阻塞者,并结合 pg_locks 核对目标 relation、请求模式与 granted=false。不要仅按“最老 SQL”猜根因,因为真正把大量查询挡住的可能正是一个排在队列中的 DDL。
最后还要控制事务边界:表级锁通常会持有到事务结束,所以不要把 DDL 放进包含大量无关操作、人工确认或长时间业务逻辑的事务。对于 ALTER TABLE,也不要把所有子命令一概认定为同一种锁;上线前应按具体子命令与目标 PostgreSQL 版本核对锁级别,再决定维护窗口、超时和替代方案。