
PostgreSQL / 系统课时
设计低风险数据库变更
设计低风险数据库变更
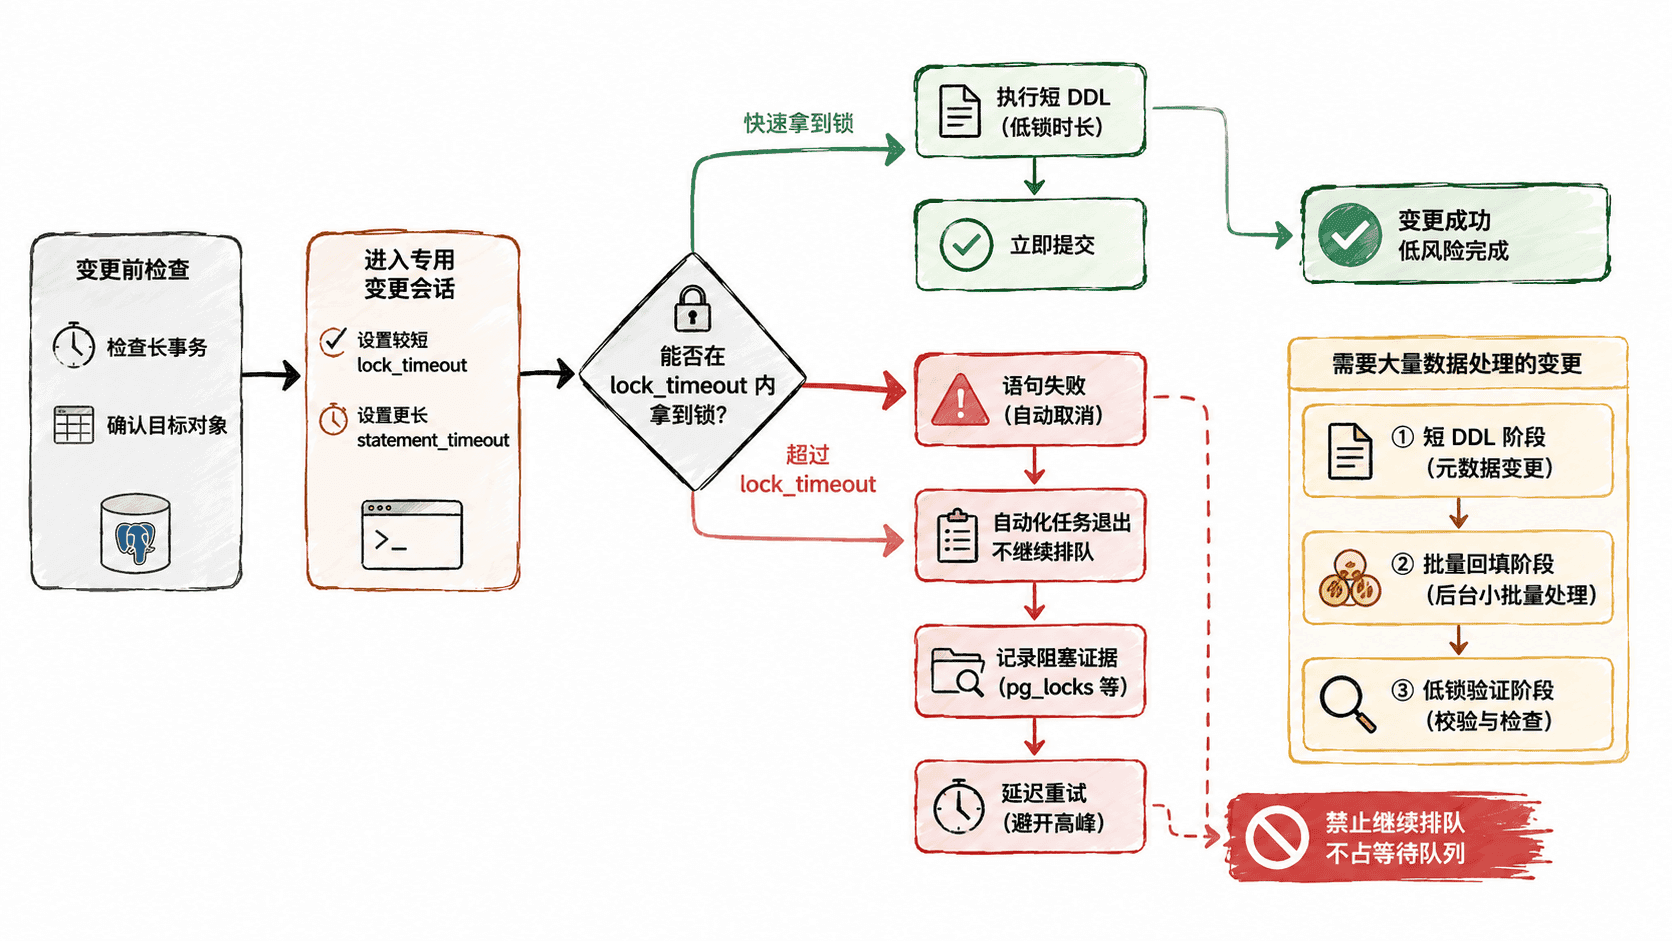
低风险数据库变更的关键不是寻找“绝不加锁”的 DDL,而是把强锁持有时间压短、把等待时间设上限,并让失败能够立即退出。本节给出一套可落地的发布方法:先加超时护栏,再拆分高风险步骤,最后用自动化脚本保证错误不会悄悄继续。
学习目标
- 区分
lock_timeout与statement_timeout分别控制什么风险 - 把一次大 DDL 拆成短锁步骤、后台处理和低锁验证
- 让变更在拿不到锁时快速失败,并留下可重试、可审计的状态
先限制等待,再考虑执行多久
很多 DDL 需要 ACCESS EXCLUSIVE 或其他较强锁。真正危险的场景往往不是 DDL 本身只执行几十毫秒,而是它先在繁忙表上等锁几十分钟。等待中的强锁请求还会放大后续请求的排队风险,所以生产变更不应使用无限等待作为默认策略。
lock_timeout 只计算“等待锁”的时间,而且对每次锁获取分别生效;statement_timeout 控制整条语句从开始到结束的总时间。通常应让 lock_timeout 明显小于 statement_timeout:前者负责拿不到锁就退出,后者负责拿到锁后也不能无限执行。
SET lock_timeout = '2s';
SET statement_timeout = '30s';

SHOW lock_timeout;
SHOW statement_timeout;
预期输出:
SET
SET
 lock_timeout
--------------
 2s

 statement_timeout
-------------------
 30s
实际表格宽度可能不同。这里的 2 秒与 30 秒只是变更会话示例,生产值应根据业务延迟预算和 DDL 类型单独设定,不建议把这类激进值直接改成全局默认。
让发布脚本在锁超时后直接失败
数据库已经能返回超时错误,还要保证发布工具不会忽略错误继续执行。下面的 Bash 脚本使用 psql 的 ON_ERROR_STOP 配合 Shell 的失败退出语义,对一次短元数据变更加护栏。
#!/usr/bin/env bash
set -euo pipefail

: "${DATABASE_URL:?DATABASE_URL is required}"

psql "$DATABASE_URL" -X -v ON_ERROR_STOP=1 <<'SQL'
SET application_name = 'ddl-orders-add-note';
SET lock_timeout = '2s';
SET statement_timeout = '30s';

ALTER TABLE public.orders
ADD COLUMN note text;
SQL
当能够及时取得所需锁时,预期输出为:
SET
SET
SET
ALTER TABLE
如果目标表被冲突锁长期占用,关键输出会变成:
SET
SET
SET
ERROR:  canceling statement due to lock timeout
此时 psql 返回非零状态,set -e 会让脚本停止。正确策略是记录失败、释放当前连接并稍后重试,而不是在同一发布任务里无限循环抢锁。重试应有次数上限和退避间隔,超过阈值就转人工判断。
把需要长时间工作的变更拆开
短超时只能限制等待,不能把一个本来要扫描数亿行的动作变短。对于“增加约束并验证历史数据”这类任务,应把“建立规则”和“扫描历史数据”拆成不同阶段。
下面以检查约束为例。第一阶段先添加 NOT VALID 约束,使新写入开始受约束,但暂不扫描全部历史行;第二阶段再单独验证。VALIDATE CONSTRAINT 使用较弱的 SHARE UPDATE EXCLUSIVE 锁,因此验证历史数据时不需要一直持有最强的表锁。
SET lock_timeout = '2s';
SET statement_timeout = '30s';

ALTER TABLE public.orders
ADD CONSTRAINT orders_amount_nonnegative
CHECK (amount >= 0) NOT VALID;
预期输出:
SET
SET
ALTER TABLE
历史数据确认或修复完成后,再在独立变更步骤中执行验证,并给扫描留出更长的执行预算。
SET lock_timeout = '2s';
SET statement_timeout = '20min';

ALTER TABLE public.orders
VALIDATE CONSTRAINT orders_amount_nonnegative;
预期输出:
SET
SET
ALTER TABLE
这里的分阶段思路可以推广到其他变更:索引先用 CREATE INDEX CONCURRENTLY 构建,再做必要的短元数据切换;大批量回填用小事务分批执行;高成本验证与强锁元数据操作不要绑在一个长事务里。
失败退出后要留下可判断的证据
变更失败后最忌讳只看到“timeout”就盲目重跑。至少应记录变更会话、目标表、等待事件和阻塞会话,再决定是等待业务事务自然结束、终止异常事务,还是改到更合适的窗口。
SELECT a.pid,
       a.application_name,
       a.state,
       a.wait_event_type,
       a.wait_event,
       pg_blocking_pids(a.pid) AS blocking_pids
FROM pg_stat_activity AS a
WHERE a.application_name = 'ddl-orders-add-note';
预期结果示例:
 pid  |   application_name    | state  | wait_event_type | wait_event | blocking_pids
------+-----------------------+--------+-----------------+------------+---------------
 <PID> | ddl-orders-add-note  | active | Lock            | <VALUE>    | {<PID>}
如果超时已经让连接退出,这条查询可能返回 0 行;因此生产自动化最好在失败日志里同步记录 PostgreSQL 错误和当时的阻塞关系,而不是事后只依赖活动会话视图。
把变更拆成可中止的阶段
一套稳定的低风险流程可以归纳为:变更前确认长事务和容量,短锁步骤使用较小 lock_timeout,长执行步骤再由 statement_timeout 限制总时长;需要扫描或回填的数据工作拆到独立阶段;任何阶段失败都停止向后推进,并在重试前重新检查现场。
这样设计后,数据库变更的目标就从“这次一定要做完”变成“每一步都能在风险超标时安全停下”。对在线系统而言,可预测的失败通常比不可预测的长时间锁等待更容易治理。