
PostgreSQL / 系统课时
还原多层阻塞链
还原多层阻塞链
单个等待会话只能告诉你“我被谁挡住”,但生产事故常见的是 A 挡住 B,B 又挡住 C、D,最终大量请求堆积。本课把这些直接关系组织成一棵阻塞树,用递归 SQL 找到根阻塞事务,并区分根因与中间被动阻塞者。
学习目标
- 把多个
pg_blocking_pids结果组织成可遍历的阻塞关系 - 用递归 CTE 从根阻塞者向下还原多层等待链
- 根据层级、扇出和事务状态识别真正造成堆积的根阻塞事务
把阻塞关系看成有向边
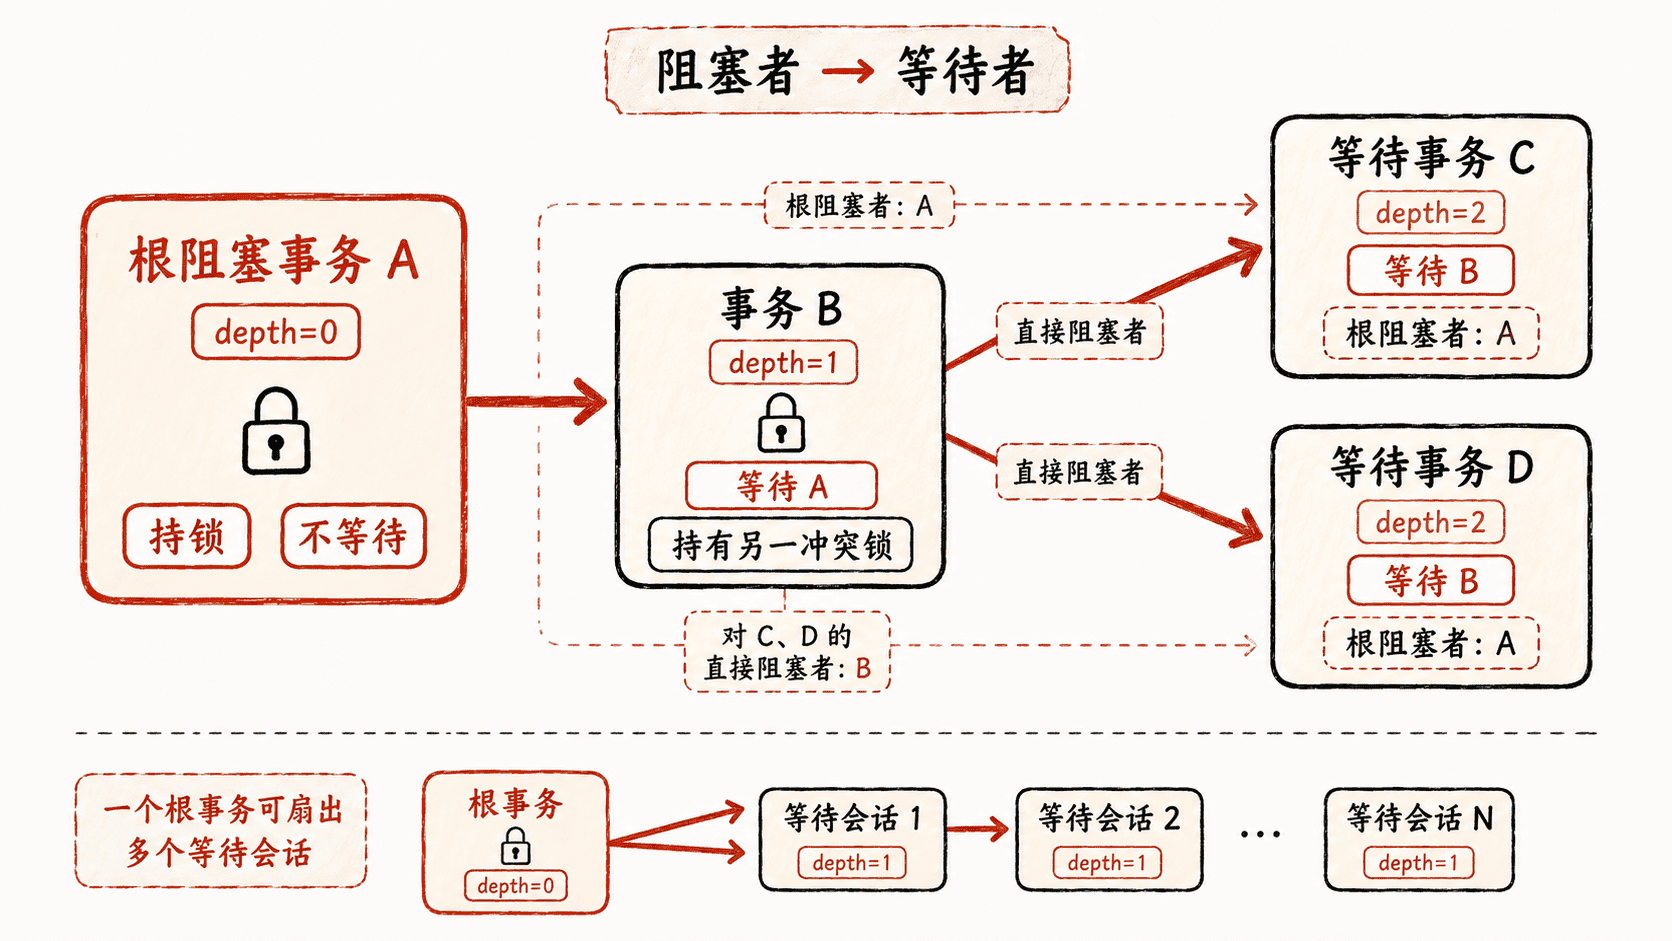
可以把每个直接关系记成“阻塞者 → 等待者”。例如 A 持锁导致 B 等待,而 B 已经持有另一把锁导致 C 等待,那么边就是 A → B → C。B 虽然直接阻塞 C,但它自己也在等待,因此通常不是根阻塞者。
根阻塞者的判定很简单:它出现在某条边的“阻塞者”位置,却没有出现在任何边的“等待者”位置。以根为起点向下遍历,就能同时看到链深度和分支规模。
用递归 CTE 还原整条链
下面先生成所有直接阻塞边,再找出没有上游等待关系的根 PID,最后从根向下递归。path 用来记录已经访问过的 PID,防止异常快照或循环关系让递归重复访问节点。
WITH RECURSIVE lock_edges AS (
    SELECT DISTINCT
        w.pid AS waiting_pid,
        b.blocker_pid
    FROM pg_stat_activity AS w
    CROSS JOIN LATERAL unnest(pg_blocking_pids(w.pid)) AS b(blocker_pid)
),
roots AS (
    SELECT DISTINCT e.blocker_pid AS root_pid
    FROM lock_edges AS e
    WHERE e.blocker_pid <> 0
      AND NOT EXISTS (
          SELECT 1
          FROM lock_edges AS upstream
          WHERE upstream.waiting_pid = e.blocker_pid
      )
),
chains AS (
    SELECT
        r.root_pid,
        r.root_pid AS pid,
        0 AS depth,
        ARRAY[r.root_pid] AS path
    FROM roots AS r

    UNION ALL

    SELECT
        c.root_pid,
        e.waiting_pid AS pid,
        c.depth + 1,
        c.path || e.waiting_pid
    FROM chains AS c
    JOIN lock_edges AS e
      ON e.blocker_pid = c.pid
    WHERE NOT e.waiting_pid = ANY(c.path)
)
SELECT
    c.root_pid,
    c.depth,
    c.pid,
    a.state,
    a.wait_event_type,
    a.wait_event,
    now() - a.xact_start AS xact_age,
    left(a.query, 100) AS query
FROM chains AS c
LEFT JOIN pg_stat_activity AS a
       ON a.pid = c.pid
ORDER BY c.root_pid, c.depth, c.pid;
预期输出如下;实际 PID、时间和 SQL 会不同:
 root_pid | depth |   pid   |        state        | wait_event_type |  wait_event   | xact_age | query
----------+-------+---------+---------------------+-----------------+---------------+----------+-------------------------
 <PID_A>  | 0     | <PID_A> | idle in transaction |                 |               | <TIME>   | UPDATE accounts SET ...
 <PID_A>  | 1     | <PID_B> | active              | Lock            | transactionid | <TIME>   | UPDATE orders SET ...
 <PID_A>  | 2     | <PID_C> | active              | Lock            | transactionid | <TIME>   | UPDATE orders SET ...
 <PID_A>  | 2     | <PID_D> | active              | Lock            | transactionid | <TIME>   | DELETE FROM orders ...
depth = 0 是根阻塞者;更大的 depth 表示离根更远。示例中 B 是 C、D 的直接阻塞者,但 A 才是整棵树的根。如果只处理 B,B 自己仍在等待 A,阻塞链通常不会真正消失。查询中的 e.blocker_pid <> 0 会排除 prepared transaction 根节点,因为 PID 0 在 pg_stat_activity 中没有对应会话;遇到这种情况要单独检查预备事务。
从链路中判断影响面
根节点优先级不能只看“是不是 depth 0”,还要看它下面挂了多少等待者、事务已经持续多久,以及状态是否异常。一个持续很久的 idle in transaction 根节点,同时扇出几十个等待会话,通常比只有单个短等待的根节点更值得优先调查。
链中间的会话也可能持有其他锁,因此会形成级联阻塞。它既是受害者也是阻塞者:上游问题解除后,它能否快速继续执行,取决于自身 SQL、锁请求和事务逻辑。排障记录应保留整条链,而不是只截取根 PID。
识别分支、软阻塞与死锁窗口
pg_blocking_pids 不只返回已经持有冲突锁的会话,也会包含等待队列中排在前面的软阻塞者,所以链条反映的是“谁阻止谁继续获得当前锁”,不等价于“谁已经持有目标锁”。这正是直接使用该函数比手工拼接 pg_locks 更适合还原等待链的原因。
真正形成死锁环时,每个参与者都可能有上游,因此短暂快照里可能找不到满足 roots 条件的根节点。PostgreSQL 会执行死锁检测并中止其中一个事务;如果查询突然从有环变成无结果,应结合数据库日志中的 deadlock 报告确认,而不是把“没有根”理解为没有问题。
用同一查询做解除后的验收
修复或结束根阻塞事务后,重新执行同一条递归查询。对应根 PID 的整棵链应消失,原先等待的会话要么继续执行,要么因业务超时自行退出。若仍存在新的 depth 0 根节点,说明现场不止一条阻塞链,需要分别处理。
这套方法的重点不是画出漂亮的树,而是把“直接阻塞者”和“根阻塞事务”分开:直接阻塞者解释当前一跳等待,根阻塞者解释为什么等待会成片扩散。生产处置应围绕根节点建立证据,再决定取消语句、结束事务还是修复应用事务边界。