
PostgreSQL / 系统课时
演练事务堆积故障
演练事务堆积故障
这次演练用一个故意不结束的事务制造根阻塞,再让多个请求争用同一行。你会看到等待会话如何占住连接、如何定位根阻塞,并通过结束根事务让队列恢复,最后复盘真正的事务边界问题。
学习目标
- 在隔离环境复现“根事务未结束 → 多个请求持续等待”的堆积链路。
- 从
pg_stat_activity和pg_blocking_pids()识别等待者、根阻塞和事务状态。 - 完成安全处置、恢复验证和根因复盘,而不是只把等待会话清掉。
准备一张可重复实验的表
只在本地或专用测试数据库执行本演练,不要在生产表上制造锁等待。打开四个独立 psql 终端:会话 A 作为根阻塞,会话 B、C 作为业务请求,观察会话 O 专门查询活动状态。
先在任意终端创建实验表并放入一行数据。
DROP TABLE IF EXISTS lock_pileup_lab;
CREATE TABLE lock_pileup_lab (
    id bigint PRIMARY KEY,
    balance integer NOT NULL
);
INSERT INTO lock_pileup_lab (id, balance) VALUES (1, 100);预期输出:如果表原本不存在,DROP TABLE IF EXISTS 还可能额外打印一条 NOTICE;命令标签应如下。
DROP TABLE
CREATE TABLE
INSERT 0 1
制造一个不结束的根事务
在会话 A 中设置容易识别的应用名,开启事务并更新 id = 1。UPDATE 完成后故意不要执行 COMMIT 或 ROLLBACK,这样该事务仍然持有与这次修改相关的锁。
SET application_name = 'lock-pileup-a';
BEGIN;
SELECT pg_backend_pid() AS root_pid;
UPDATE lock_pileup_lab
SET balance = balance + 1
WHERE id = 1;
预期输出:记下实际的 <PID_A>。此时终端已经回到提示符,但事务仍打开。
SET
BEGIN
 root_pid
----------
 <PID_A>

UPDATE 1
接着在会话 B 执行单条自动提交更新,并设置 60 秒锁等待上限,防止忘记清理实验。
SET application_name = 'lock-pileup-b';
SET lock_timeout = '60s';
UPDATE lock_pileup_lab
SET balance = balance + 10
WHERE id = 1;
预期结果:两个 SET 会先返回 SET,随后 UPDATE 暂时不返回 UPDATE 1,终端保持等待;如果 60 秒内不解除阻塞,它会因 lock_timeout 报错。
在会话 C 重复同类请求,让等待者数量从一个变成多个。
SET application_name = 'lock-pileup-c';
SET lock_timeout = '60s';
UPDATE lock_pileup_lab
SET balance = balance + 100
WHERE id = 1;
预期结果:会话 C 同样停在 UPDATE 上等待。此时如果应用连接池容量有限,类似请求会持续占用数据库会话,更多业务请求只能在连接池或数据库侧排队。
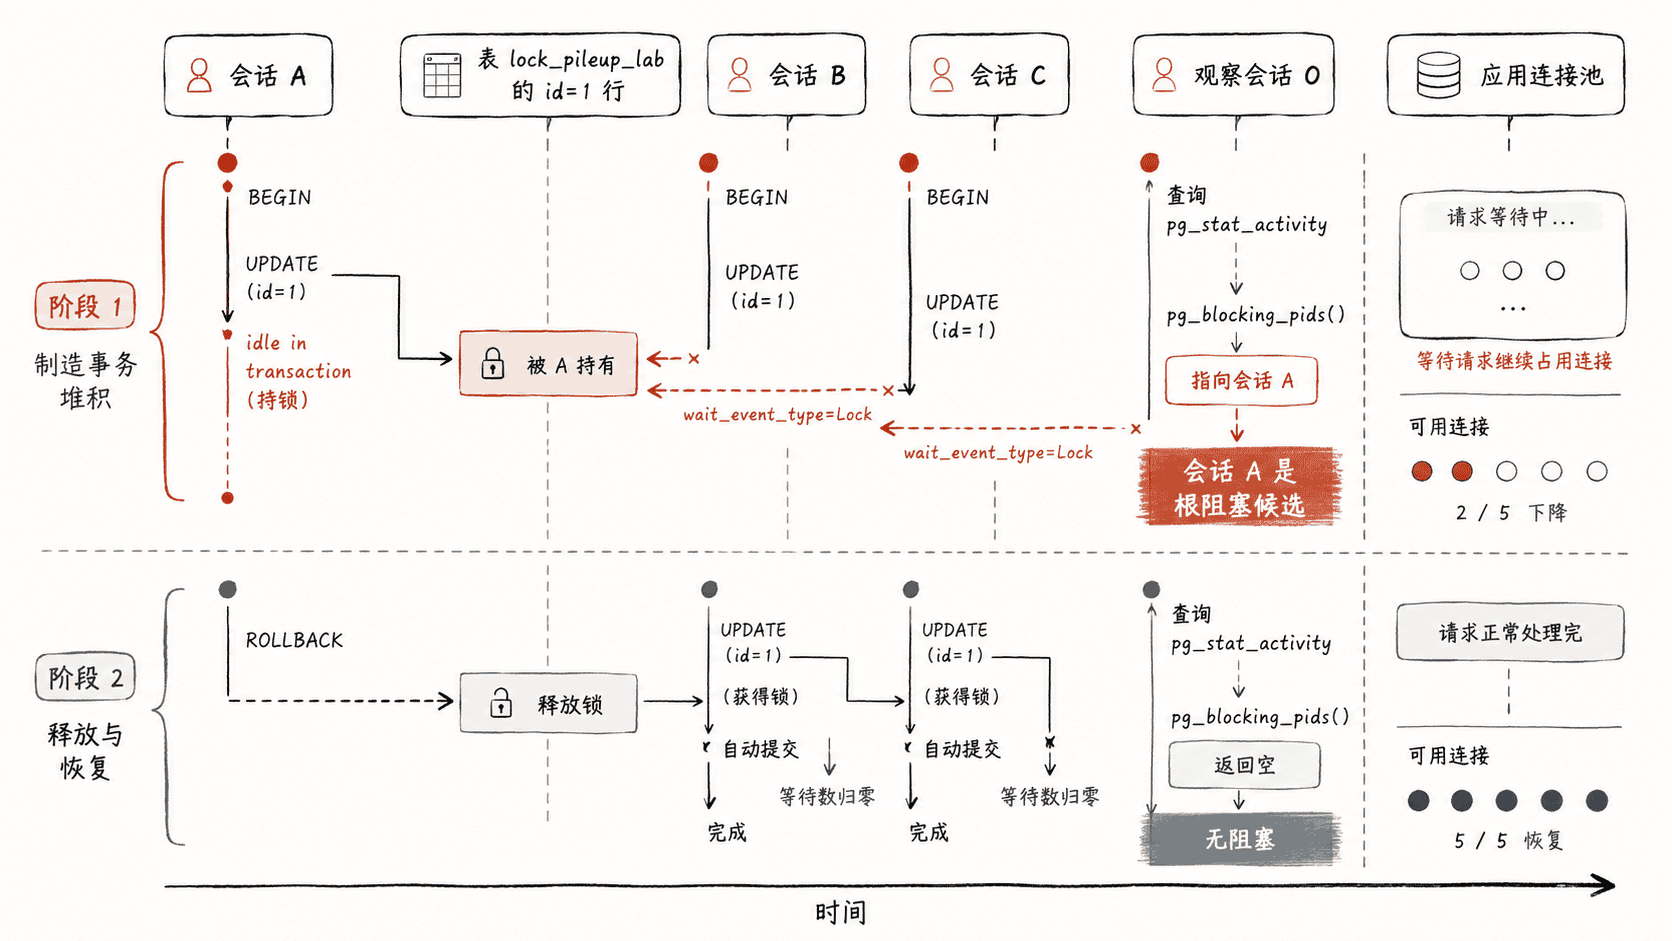
从观察会话定位根阻塞
在会话 O 查询这三类会话。A 没有正在执行语句时通常表现为 idle in transaction;B、C 的查询仍在执行,因此会是 active,并且 wait_event_type 为 Lock。
SELECT
    pid,
    application_name,
    state,
    wait_event_type,
    wait_event,
    clock_timestamp() - xact_start AS xact_age,
    pg_blocking_pids(pid) AS blocking_pids,
    left(query, 80) AS query_sample
FROM pg_stat_activity
WHERE application_name LIKE 'lock-pileup-%'
ORDER BY application_name;
预期输出:PID、时长和 C 的阻塞数组以实测为准。B 至少能把等待关系追到 A;C 还可能受到排在它前面的等待者影响。
 pid     | application_name | state               | wait_event_type | wait_event    | xact_age | blocking_pids    | query_sample
---------+------------------+---------------------+-----------------+---------------+----------+------------------+-----------------------------
 <PID_A> | lock-pileup-a    | idle in transaction | Client          | ClientRead    | 00:00:20 | {}               | UPDATE lock_pileup_lab ...
 <PID_B> | lock-pileup-b    | active              | Lock            | transactionid | 00:00:08 | {<PID_A>}        | UPDATE lock_pileup_lab ...
 <PID_C> | lock-pileup-c    | active              | Lock            | transactionid | 00:00:05 | {<BLOCKER_PIDS>} | UPDATE lock_pileup_lab ...
这里最重要的判断不是“B、C 很慢”,而是 A 的事务已经没有活动 SQL,却没有结束。只终止 B、C 会暂时减少等待数,但 A 仍能继续挡住后续请求,连接堆积很快会再次出现。
结束根事务并观察队列排空
本次演练能直接控制根会话,所以优先在 A 中正常结束事务,而不是从观察会话强杀 PID。执行回滚后,A 对实验行的修改被撤销,等待者将有机会继续执行。
ROLLBACK;预期输出:
ROLLBACK随后观察会话 B、C。由于它们的 UPDATE 都是在自动提交模式下执行,解除阻塞后会依次完成并各自结束事务。
预期结果:
UPDATE 1在会话 O 再检查等待数和未结束事务数。
SELECT
    count(*) FILTER (WHERE wait_event_type = 'Lock') AS lock_waiters,
    count(*) FILTER (WHERE state = 'idle in transaction') AS idle_in_tx
FROM pg_stat_activity
WHERE application_name LIKE 'lock-pileup-%';

SELECT balance
FROM lock_pileup_lab
WHERE id = 1;
预期输出:B、C 都已完成且 A 已回滚时,等待和空闲事务都应归零;A 的 +1 被回滚,只保留 B 的 +10 与 C 的 +100,因此余额为 210。
 lock_waiters | idle_in_tx
--------------+------------
 0            | 0

 balance
---------
 210
复盘真正的故障原因
这次故障并不是 UPDATE 本身执行慢,而是会话 A 把事务边界留在了业务空档里。事务仍打开时,数据库必须保留相关锁;后续请求等待这些锁,又继续占住后台连接,于是数据库层的一个根阻塞会被放大成连接池耗尽、接口排队和超时。
生产修复应优先缩短事务边界:不要在持锁事务中等待远程 RPC、人工输入或长时间业务计算;异常路径必须可靠回滚;连接池要监控 idle in transaction 和事务年龄。idle_in_transaction_session_timeout 与应用级 lock_timeout 可以作为最后护栏,但不能替代代码层正确结束事务。
演练结束后清理实验对象。
DROP TABLE lock_pileup_lab;预期输出:
DROP TABLE当你能从“连接堆积”一路追到“哪个事务、为什么没结束、结束后是否真正排空”,锁故障才算形成闭环;单纯把等待连接杀掉,只是在删除症状。