
PostgreSQL / 系统课时
还原死锁等待图
还原死锁等待图
死锁复盘真正有用的产物不是两段 SQL,而是一张方向明确的等待图:节点代表事务或会话,边从等待者指向阻塞者,边上标出等待对象。只要出现闭环,就能定位死锁结构;再叠加事务内前序 SQL,才能看清相反的加锁顺序。
学习目标
- 把死锁日志中的
waits for与blocked by转换成等待图的有向边。 - 用闭环判断死锁,而不是凭两条相似 SQL 猜测。
- 结合前序语句区分“当前等待资源”和“此前已持有资源”。
先把日志归一化成边
假设日志已经给出两条核心证据:
Process 4201 waits for ShareLock on transaction 9102; blocked by process 4202.
Process 4202 waits for ShareLock on transaction 9101; blocked by process 4201.
这不是两条独立告警,而是两条有向边。统一采用“等待者 → 阻塞者”的方向,可以把证据写成关系表。下面用 PostgreSQL 的 VALUES 把日志事实录入临时关系,便于检查方向是否抄反。
WITH edges(waiter_pid, blocker_pid, waiting_on) AS (
    VALUES
        (4201, 4202, 'transaction 9102'),
        (4202, 4201, 'transaction 9101')
)
SELECT waiter_pid, '->' AS edge, blocker_pid, waiting_on
FROM edges
ORDER BY waiter_pid;
预期输出:
 waiter_pid | edge | blocker_pid |    waiting_on
------------+------+-------------+--------------------
       4201 | ->   |        4202 | transaction 9102
       4202 | ->   |        4201 | transaction 9101
(2 rows)
当你看到 4201 → 4202 → 4201,闭环已经成立。若是三方死锁,形式同样只是更长,例如 A → B → C → A。
给等待边补上持锁顺序
等待图只说明“现在谁在等谁”。要解释为什么形成这个环,还必须找到事务内已经成功执行的前序语句。假设应用日志或 SQL 审计补充了以下顺序:
| 会话 | 已成功执行 | 当前等待 |
|---|---|---|
| 4201 | 先更新 accounts.id=1 |
再更新 accounts.id=2 |
| 4202 | 先更新 accounts.id=2 |
再更新 accounts.id=1 |
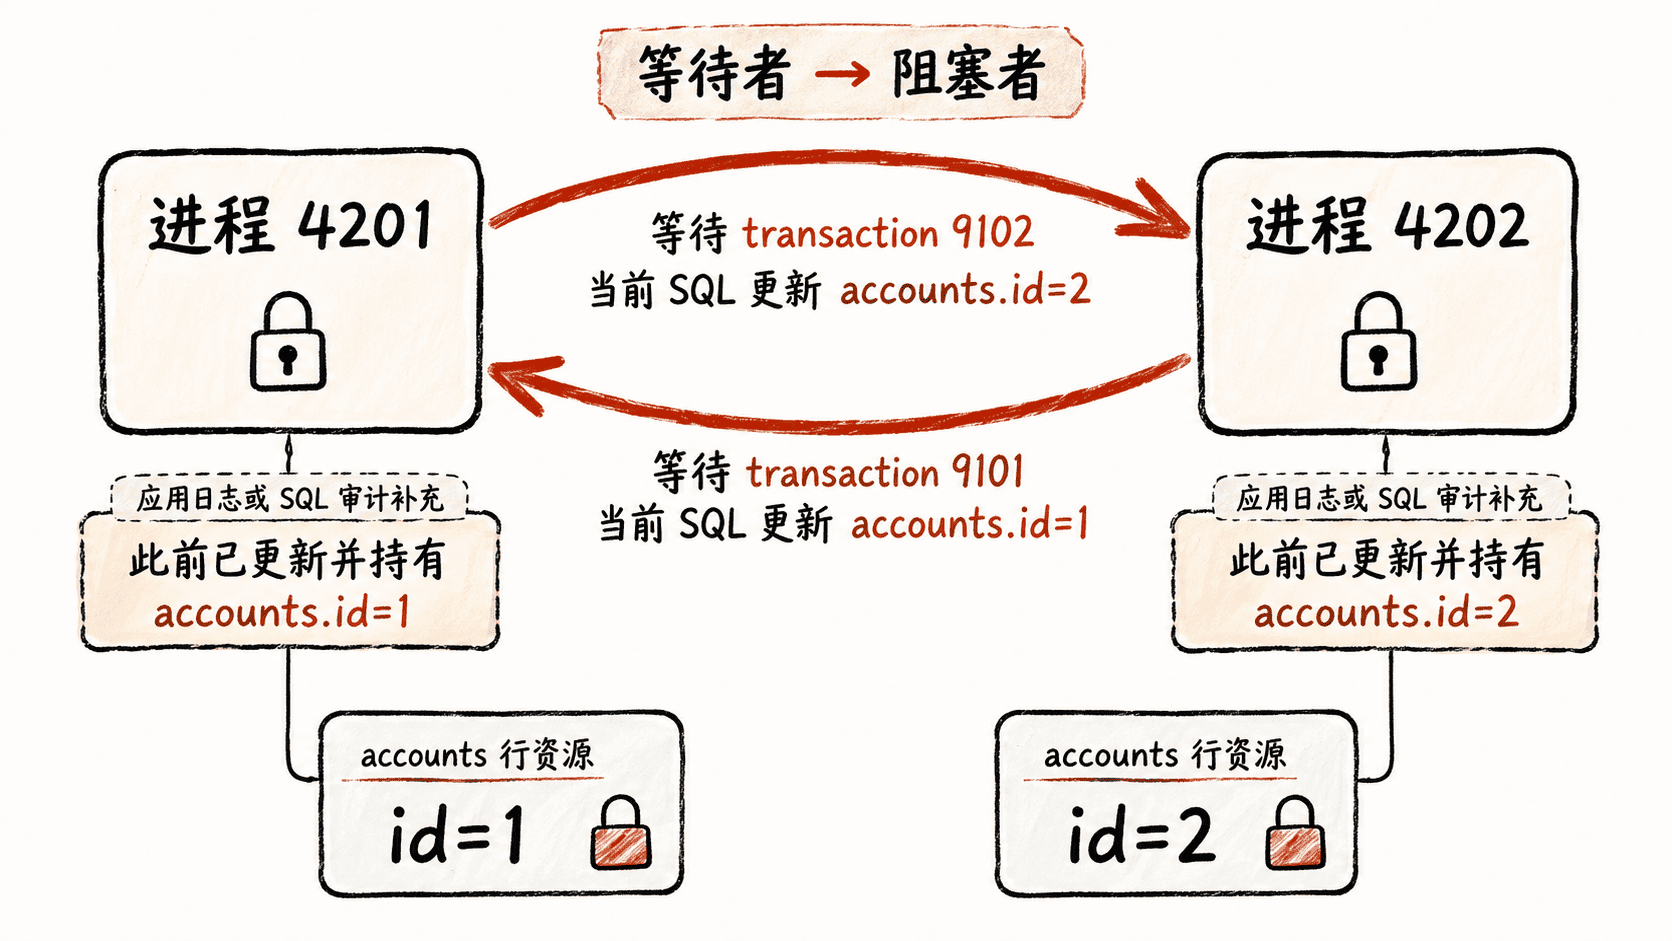
此时因果链就完整了:4201 持有 id=1 相关行锁并请求 id=2,4202 持有 id=2 相关行锁并请求 id=1。双方都只能等待对方事务结束,于是形成闭环。
这一步不能仅靠 STATEMENT 猜。死锁日志里的当前 SQL 是“正在等待的动作”,而前一个成功加锁动作可能早已执行完,必须从同一事务更早的证据中补齐。
不要把资源图和等待图混为一谈
等待图的节点应优先使用事务或 PID,边表达等待关系;资源信息放在边标签或旁注中。这样最容易判断环。若把表、行、transaction ID、PID 全都画成同一层节点,很容易把“进程等待事务结束”和“事务曾修改某一行”混成同一种关系。
对于 PostgreSQL 行更新冲突,日志常显示等待 transactionid,而真正的业务竞争对象通常可以从 SQL 谓词、CONTEXT、应用参数或审计日志映射回订单号、账户 ID 等业务键。复盘报告应同时保留数据库锁对象和业务对象,两者用途不同。
用统一加锁顺序消除闭环
还原图之后,修复目标应针对闭环条件,而不是只调大 deadlock_timeout。上例最直接的治理方式是让两个事务都按同一顺序访问资源,例如都先锁较小的账户 ID,再锁较大的账户 ID。这样即使发生等待,等待边也不会首尾相接成环。
如果业务无法统一访问顺序,还可以缩短事务、减少事务内交互、拆分不必要的批量更新,或在应用层对同一组资源建立确定性的排序规则。验收时应重新压测相同并发路径,确认不再出现同结构的等待闭环,而不仅仅是“这次没有报错”。