
PostgreSQL / 系统课时
判断阻塞影响范围
判断阻塞影响范围
发现一个阻塞 PID 只是定位起点,生产处置还要回答“影响了多少请求、持续多久、来自哪些业务、连接是否正在被耗尽”。本课用一组聚合查询把等待数量、事务年龄、业务来源和连接压力合并到同一判断路径,帮助你决定是立即止损、协调提交,还是继续观察。
学习目标
- 统计每个直接阻塞者影响的等待会话数量和最长等待时间。
- 结合
application_name、事务年龄与连接占用判断业务扩散范围。 - 用一致的优先级规则区分需要立即处置与可以观察的阻塞。
先把等待规模聚合到阻塞者
单看某个等待会话容易低估问题。一个阻塞者可能同时卡住多个请求,而这些请求还可能继续占着连接池连接。先对 pg_blocking_pids() 返回的直接阻塞关系做聚合:
WITH blocked AS (
    SELECT DISTINCT
        w.pid AS waiting_pid,
        w.application_name AS waiting_app,
        w.query_start AS wait_query_start,
        p.blocker_pid
    FROM pg_stat_activity AS w
    CROSS JOIN LATERAL unnest(pg_blocking_pids(w.pid)) AS p(blocker_pid)
)
SELECT
    b.blocker_pid,
    a.application_name AS blocker_app,
    a.state AS blocker_state,
    count(*) AS waiting_sessions,
    max(clock_timestamp() - b.wait_query_start) AS longest_wait,
    clock_timestamp() - a.xact_start AS blocker_xact_age,
    string_agg(
        DISTINCT COALESCE(NULLIF(b.waiting_app, ''), 'unknown'),
        ', '
    ) AS waiting_apps
FROM blocked AS b
JOIN pg_stat_activity AS a
  ON a.pid = b.blocker_pid
GROUP BY
    b.blocker_pid,
    a.application_name,
    a.state,
    a.xact_start
ORDER BY waiting_sessions DESC, longest_wait DESC;
预期输出
 blocker_pid | blocker_app  | blocker_state       | waiting_sessions | longest_wait | blocker_xact_age | waiting_apps
-------------+--------------+---------------------+------------------+--------------+------------------+-------------------------
 <PID>       | checkout-api | idle in transaction | 18               | 00:00:42     | 00:09:31         | order-api, inventory-api
这里的 waiting_sessions 是当前快照里的直接等待数量,不是“受影响请求总数”;已经超时失败、在应用侧排队或被熔断的请求不会出现在这个数字里。因此它适合做数据库侧实时证据,不能替代应用 QPS、错误率和队列长度。
再看连接是否被等待拖满
锁等待常见的二次伤害是连接被占住:查询虽然没跑,但会话仍然占用一个 backend。下面用 max_connections 计算一个粗略的客户端连接占用率:
SELECT
    count(*) FILTER (WHERE backend_type = 'client backend') AS client_backends,
    current_setting('max_connections')::int AS max_connections,
    round(
        100.0 * count(*) FILTER (WHERE backend_type = 'client backend')
        / current_setting('max_connections')::int,
        1
    ) AS usage_pct
FROM pg_stat_activity;
预期输出
 client_backends | max_connections | usage_pct
-----------------+-----------------+----------
 148             | 200             | 74.0
这个比例只用于快速判断压力,不能理解为“还有 26% 就一定安全”。普通业务连接实际可用槽位还会受到保留连接、其他数据库、管理任务和连接池自身上限影响。生产上应同时看各应用连接池的 active、pending、timeout 指标;如果数据库等待会话增加,而连接池 pending 也同步上升,说明阻塞已经从 SQL 层扩散到请求入口。
用业务来源和事务年龄判断优先级
application_name、usename、client_addr 能帮助确认阻塞者属于哪个服务或任务。建议让每个连接池设置稳定且可检索的 application_name,否则多个服务共用数据库账号时,阻塞来源很容易被混在一起。
事务年龄要和状态一起看。一个持续几百毫秒的 active 写事务即使暂时阻塞别人,也可能很快提交;一个已经数分钟的 idle in transaction 阻塞者则更像异常路径。相同等待数量下,后者通常具有更高处置优先级,因为它没有继续推进事务的迹象。
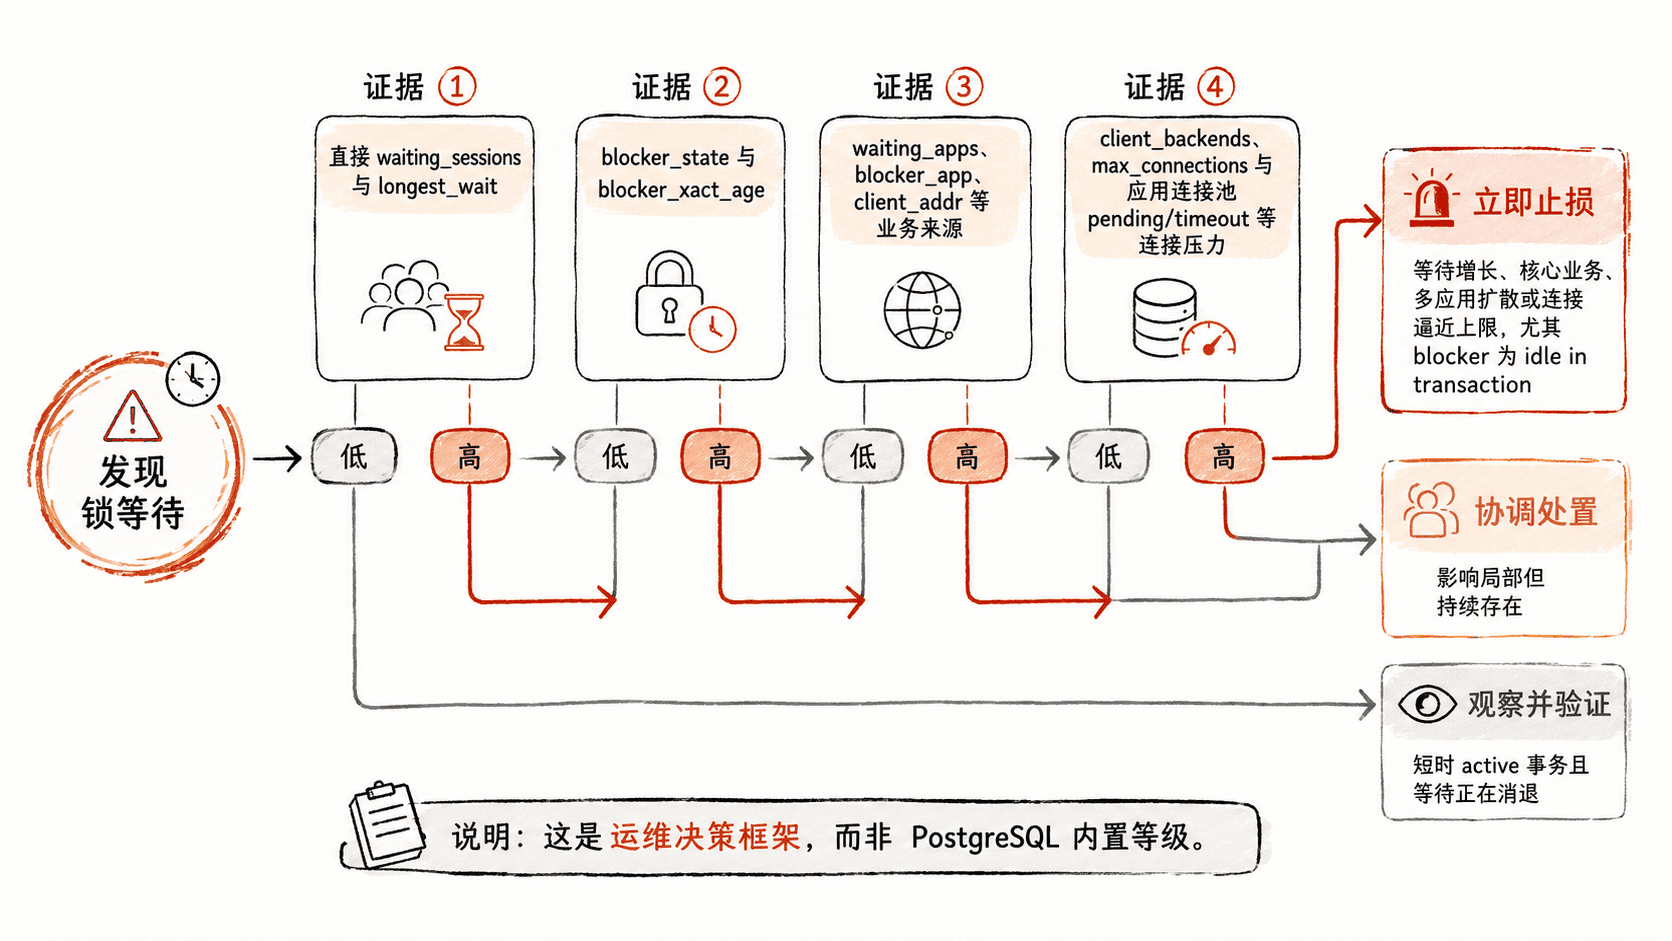
按扩散程度决定动作
可以把现场分成三类,但这些是团队运维规则,不是 PostgreSQL 内置等级。
| 现场特征 | 处置倾向 |
|---|---|
| 等待数量持续增长,核心业务受影响,连接池开始排队或超时,阻塞者又长期不推进 | 立即止损,优先消除阻塞源并保护入口容量 |
| 影响集中在单一服务,等待稳定但已经持续,阻塞事务仍可联系到明确 Owner | 协调提交或回滚,同时限制继续扩散 |
阻塞者是短时 active 事务,等待量小且正在下降,连接使用稳定 |
继续观察,避免为了“清零等待”误杀正常事务 |
不要仅凭“事务很老”或“等待很多”单独做决定。老事务可能根本没有阻塞关键路径;等待很多也可能是一个即将提交的批处理瞬时峰值。优先级应由等待规模 × 持续时间 × 业务重要性 × 连接压力 × 阻塞者是否继续推进共同决定。
处置后验证影响正在收敛
采取提交、回滚、终止阻塞会话或应用侧降载后,重新执行前面的阻塞聚合查询。正确的收敛信号不是“某个 PID 消失”这么简单,而是等待会话数量下降、最长等待不再增长、连接池 pending 回落,并且核心业务错误率恢复。
若等待关系换了一个 PID 后继续增长,说明你处理的可能只是阻塞链中的一环;若数据库侧已经没有锁等待但应用仍大量超时,则应转向连接池、线程池、下游依赖或慢 SQL 排查。判断影响范围的价值,就在于把“一个数据库锁事件”还原成业务上真正需要处置的故障半径。