
图形渲染与 Shader / 系统课时
使用着色器存储缓冲
使用着色器存储缓冲
当 Uniform Buffer 容量不足,或着色器不仅要读取数据还要写回结果时,可以改用 Shader Storage Buffer Object。下面用一个计算着色器原地递增整数数组,串起 SSBO 的创建、绑定、写入、同步和读回。
学习目标
- 能创建 SSBO,并把缓冲对象绑定到着色器声明中的 binding point。
- 能用
std430和无尺寸数组传递大规模结构化数据并从着色器写回。 - 知道 GPU 写入后何时需要
glMemoryBarrier,以及如何避免并发写冲突。
什么时候选 SSBO
SSBO 与 UBO 都把缓冲对象暴露给着色器,但目标不同。UBO 更适合小型、只读、更新频繁的统一参数;SSBO 支持更大的存储块、着色器写入以及运行时长度数组,适合实例数据、粒子、可见列表、计算结果等场景。
| 能力 | UBO | SSBO |
|---|---|---|
| 着色器访问 | 只读 | 可读写 |
| 常用布局 | std140 |
std430 |
| 运行时长度数组 | 不适合 | 支持末尾无尺寸数组 |
| 容量 | 受 GL_MAX_UNIFORM_BLOCK_SIZE 限制 |
受 GL_MAX_SHADER_STORAGE_BLOCK_SIZE 限制 |
实际容量不能靠固定常量猜测,应在目标设备上查询对应上限。std430 也不是“完全无对齐”,只是比 std140 更紧凑,例如标量数组不再强制使用 16 字节步长。
建立可写缓冲
下面的计算着色器是片段示例,要求 OpenGL 4.3 或相应扩展。binding = 0 必须与主机端的绑定点一致;无尺寸数组必须位于存储块最后。
#version 430 core

layout(local_size_x = 64) in;

layout(std430, binding = 0) buffer Values {
    uint data[];
};

void main() {
    uint i = gl_GlobalInvocationID.x;

    // 多余 invocation 直接退出,避免越界访问。
    if (i < data.length()) {
        data[i] += 1u;
    }
}
主机端的关键流程如下。片段示例假设已经创建 OpenGL 4.3 上下文,且 program 是由上面计算着色器成功链接得到的程序对象。
#include <glad/glad.h>
#include <array>
#include <cstring>
#include <iostream>

std::array<GLuint, 4> values{1, 2, 3, 4};

GLuint ssbo = 0;
glGenBuffers(1, &ssbo);
glBindBuffer(GL_SHADER_STORAGE_BUFFER, ssbo);
glBufferData(
    GL_SHADER_STORAGE_BUFFER,
    sizeof(values),
    values.data(),
    GL_DYNAMIC_COPY
);

// binding=0 必须和 GLSL 中的存储块声明一致。
glBindBufferBase(GL_SHADER_STORAGE_BUFFER, 0, ssbo);

glUseProgram(program);
glDispatchCompute(1, 1, 1);

// 让着色器写入对后续缓冲访问和 CPU 映射可见。
glMemoryBarrier(
    GL_SHADER_STORAGE_BARRIER_BIT |
    GL_BUFFER_UPDATE_BARRIER_BIT
);

glBindBuffer(GL_SHADER_STORAGE_BUFFER, ssbo);
void* ptr = glMapBufferRange(
    GL_SHADER_STORAGE_BUFFER,
    0,
    sizeof(values),
    GL_MAP_READ_BIT
);
std::memcpy(values.data(), ptr, sizeof(values));
glUnmapBuffer(GL_SHADER_STORAGE_BUFFER);

for (GLuint value : values) {
    std::cout << value << ' ';
}
std::cout << '\n';

glDeleteBuffers(1, &ssbo);
预期输出:
2 3 4 5这里一次 dispatch 会启动一个包含 64 个 invocation 的工作组,但只有索引 0~3 通过长度检查并访问数据,因此不会越界。真实程序中的工作组数量通常按元素数量向上取整,例如 (count + 63) / 64。
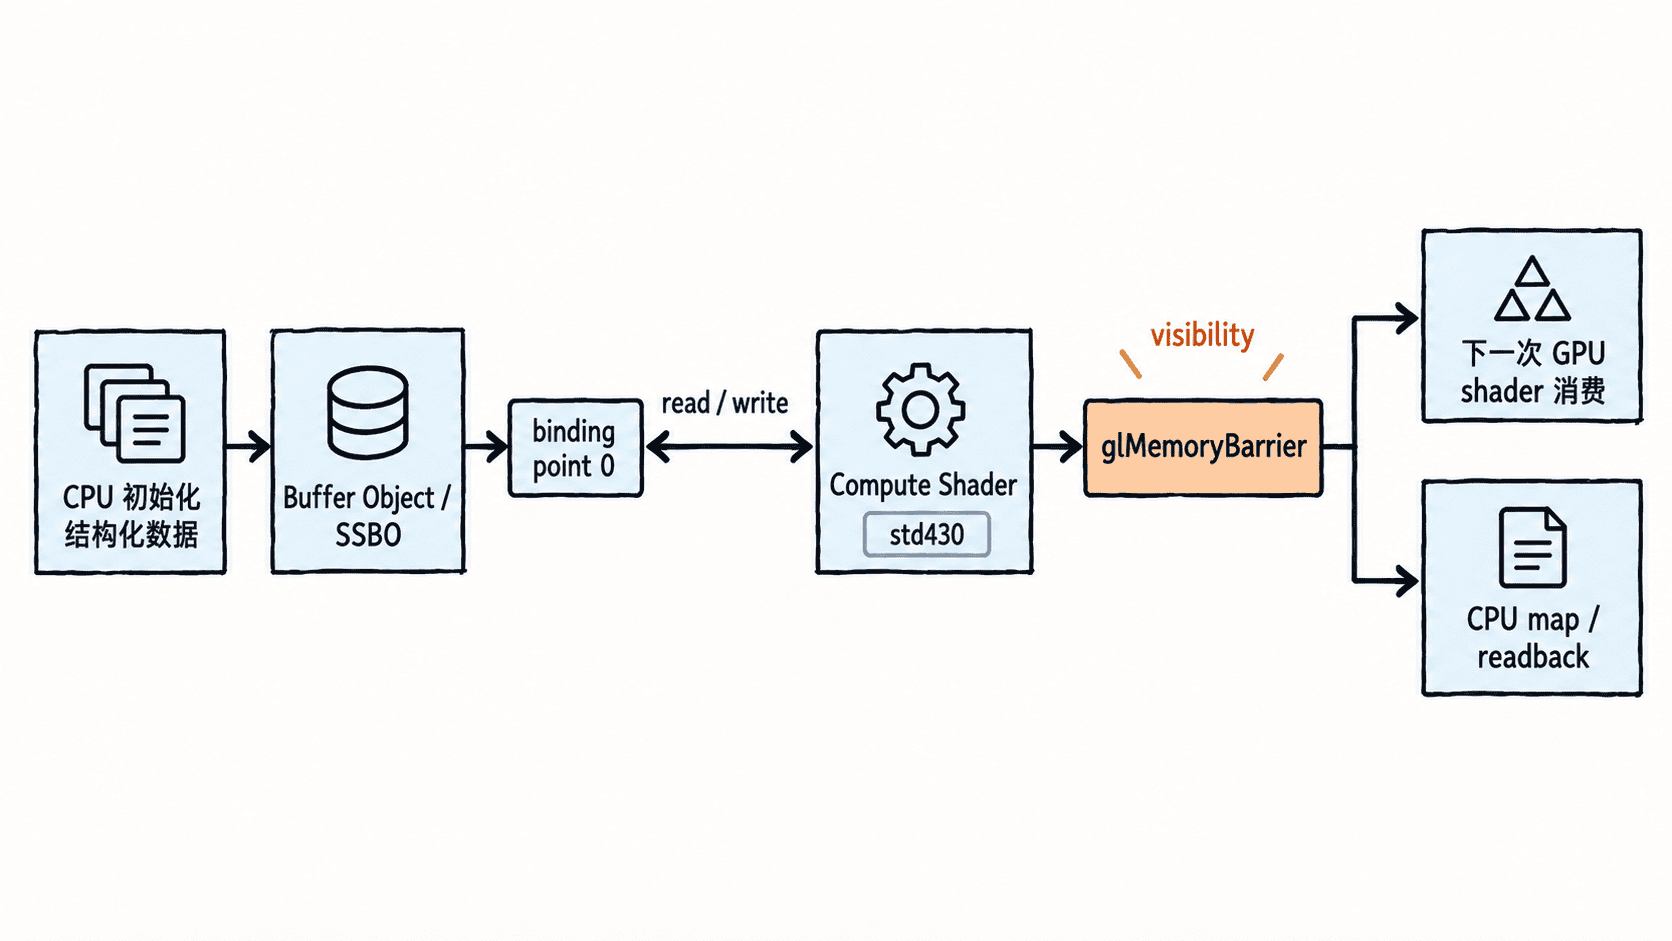
同步不是可选细节
glDispatchCompute 之后的写入可能仍在 GPU 流水线上。若后续命令要把同一缓冲再次作为 SSBO 读取,至少需要与目标访问匹配的 memory barrier;如果马上通过缓冲更新或映射类 API 在 CPU 侧读取,也应包含 GL_BUFFER_UPDATE_BARRIER_BIT。屏障解决的是可见性和顺序,不是自动修复数据竞争。
同一次 dispatch 内,如果多个 invocation 可能写同一个元素,简单的 data[i] += 1u 就可能产生竞争。应让每个 invocation 写独立区间,或改用 atomicAdd 等原子操作;工作组内部需要阶段性协作时,还要结合着色器中的内存屏障与 barrier()。
结构化数据的边界
SSBO 常和结构体数组一起使用。主机端布局必须与 GLSL 的 std430 规则一致,尤其要重新检查 vec3、嵌套结构体和数组步长,不能把 std140 的填充规则原样照搬。
另外,不要因为 SSBO 容量更大就把所有场景都改成 SSBO。少量全局只读参数仍适合 UBO;SSBO 更适合数据量大、需要随机索引、需要写回或需要运行时长度的缓冲。选择数据通道时,把容量、访问权限、同步成本和布局复杂度一起考虑,通常比单看“能不能放下”更可靠。