
图形渲染与 Shader / 系统课时
减少绘制调用
减少绘制调用
当场景里对象数量增加时,GPU 未必先成为瓶颈,CPU 可能已经忙于重复提交绘制命令和切换状态。本节从 Draw Call 的实际成本出发,把可以共享状态的数据集中提交,并建立可验证的批量渲染策略。
学习目标
- 识别 Draw Call 与频繁状态切换带来的 CPU 提交成本
- 按着色器、材质和几何数据组织可批量提交的对象
- 使用批量绘制接口减少一次帧中的绘制调用数量
绘制调用为什么会变贵
一次 glDrawElements 不只是通知 GPU “画几个三角形”。驱动还需要检查当前程序、VAO、缓冲区、纹理和其他状态,并把工作编码到 GPU 命令流中。单次成本通常不高,但当一帧出现成千上万次小型提交时,CPU 驱动开销会快速累积。
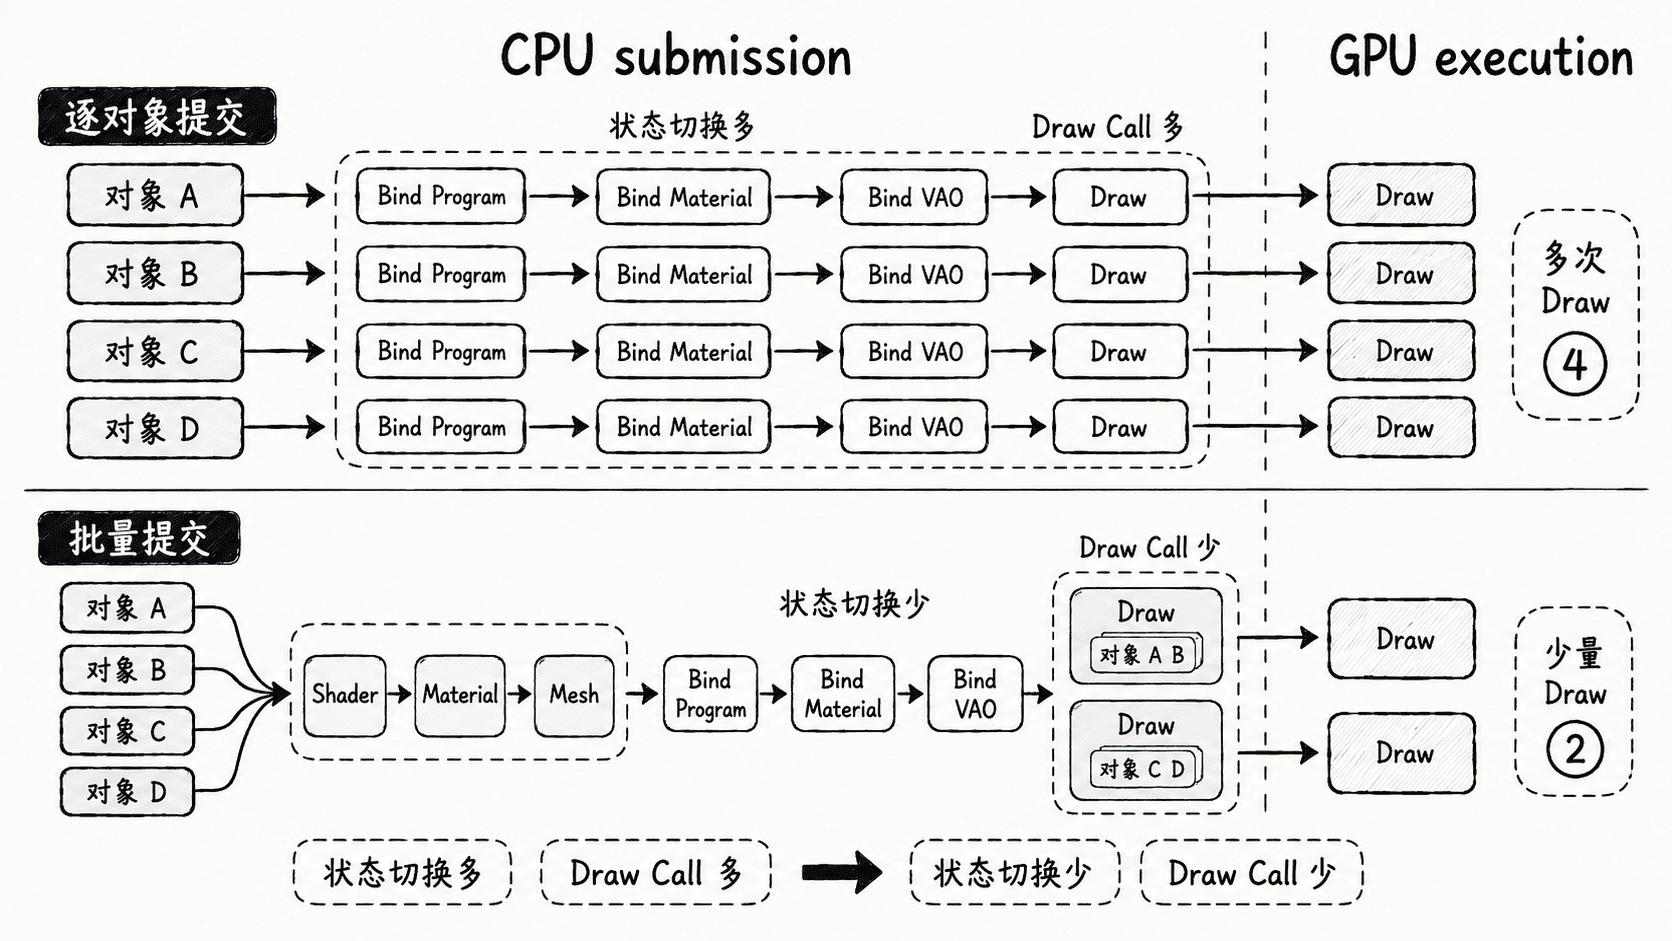
状态切换同样重要。如果连续对象不断更换着色器、纹理或 VAO,即使 Draw Call 数没有明显增加,也会产生额外验证和绑定成本。因此优化目标不是简单地“把所有东西合成一次绘制”,而是让状态兼容的对象连续提交。
先按状态组织提交顺序
最容易落地的策略是先排序,再批量。可以把渲染项按照 shader -> material -> mesh 的顺序分组,使相邻对象尽量复用已经绑定的状态。透明物体通常还需要保持从远到近的顺序,因此不能机械地与不透明物体使用同一套排序规则。
对于共享同一个 VAO、索引类型和图元模式的多个子网格,还可以进一步使用 glMultiDrawElements,一次函数调用提交多个索引区间。下面是依赖现有 OpenGL 上下文、VAO 和索引缓冲区的片段示例:
const GLsizei counts[] = {36, 24, 60};
const void* offsets[] = {
    reinterpret_cast<void*>(0),
    reinterpret_cast<void*>(36 * sizeof(GLuint)),
    reinterpret_cast<void*>((36 + 24) * sizeof(GLuint))
};

// 三段索引共享当前着色器、VAO 和其他绘制状态。
glBindVertexArray(batchVao);
glMultiDrawElements(
    GL_TRIANGLES,
    counts,
    GL_UNSIGNED_INT,
    offsets,
    3
);
预期结果
一次 glMultiDrawElements 调用提交 3 个索引区间,而不是执行 3 次 glDrawElements。这里的关键不是 API 名称,而是三个子绘制必须能共享当前状态。如果每个对象都需要完全不同的着色器或无法统一访问的材质资源,就不能只为了减少调用次数而强行合批。
选择合适的批量策略
减少 Draw Call 通常有三个层次。第一层是排序状态,几乎不改变资源布局;第二层是把多个静态网格合并到较大的顶点与索引缓冲区,再使用批量绘制;第三层是大量对象共享同一网格时使用实例化绘制。
批量越激进,管理成本也越高。把大量对象永久焊接成一个巨大网格,会让局部更新、视锥裁剪和对象删除变得困难。实践中更适合按照材质、空间区域或生命周期划分中等规模批次,而不是追求整帧只有一次 Draw Call。
用计数器验证优化是否有效
优化前后至少同时记录每帧 Draw Call 数、状态切换次数和 CPU 帧时间。若 Draw Call 明显下降但 CPU 时间没有变化,瓶颈可能位于场景遍历、资源更新或同步;若 GPU 时间反而上升,还要检查合批是否破坏了原有裁剪粒度。
一个可靠的批量策略应当满足两个条件:CPU 提交工作确实减少,同时不会为了少几个调用而让 GPU 绘制大量本可以跳过的数据。达到这个平衡后,再考虑实例化或更高级的间接绘制方案。