
消息队列 / 系统课时
理解 Kafka 事务对象
理解 Kafka 事务对象
本课解决 Kafka 事务中各对象容易混淆的问题。你将把 transactional.id、Producer、Transaction Coordinator、事务日志和事务状态放到同一条控制链路里,理解一次事务如何被注册、推进、提交或终止。
学习目标
- 说清 transactional.id、Producer 与 Transaction Coordinator 各自负责什么
- 理解事务日志与事务状态如何驱动事务生命周期
- 能从对象关系判断一次事务提交或中止时发生了什么
先建立对象边界
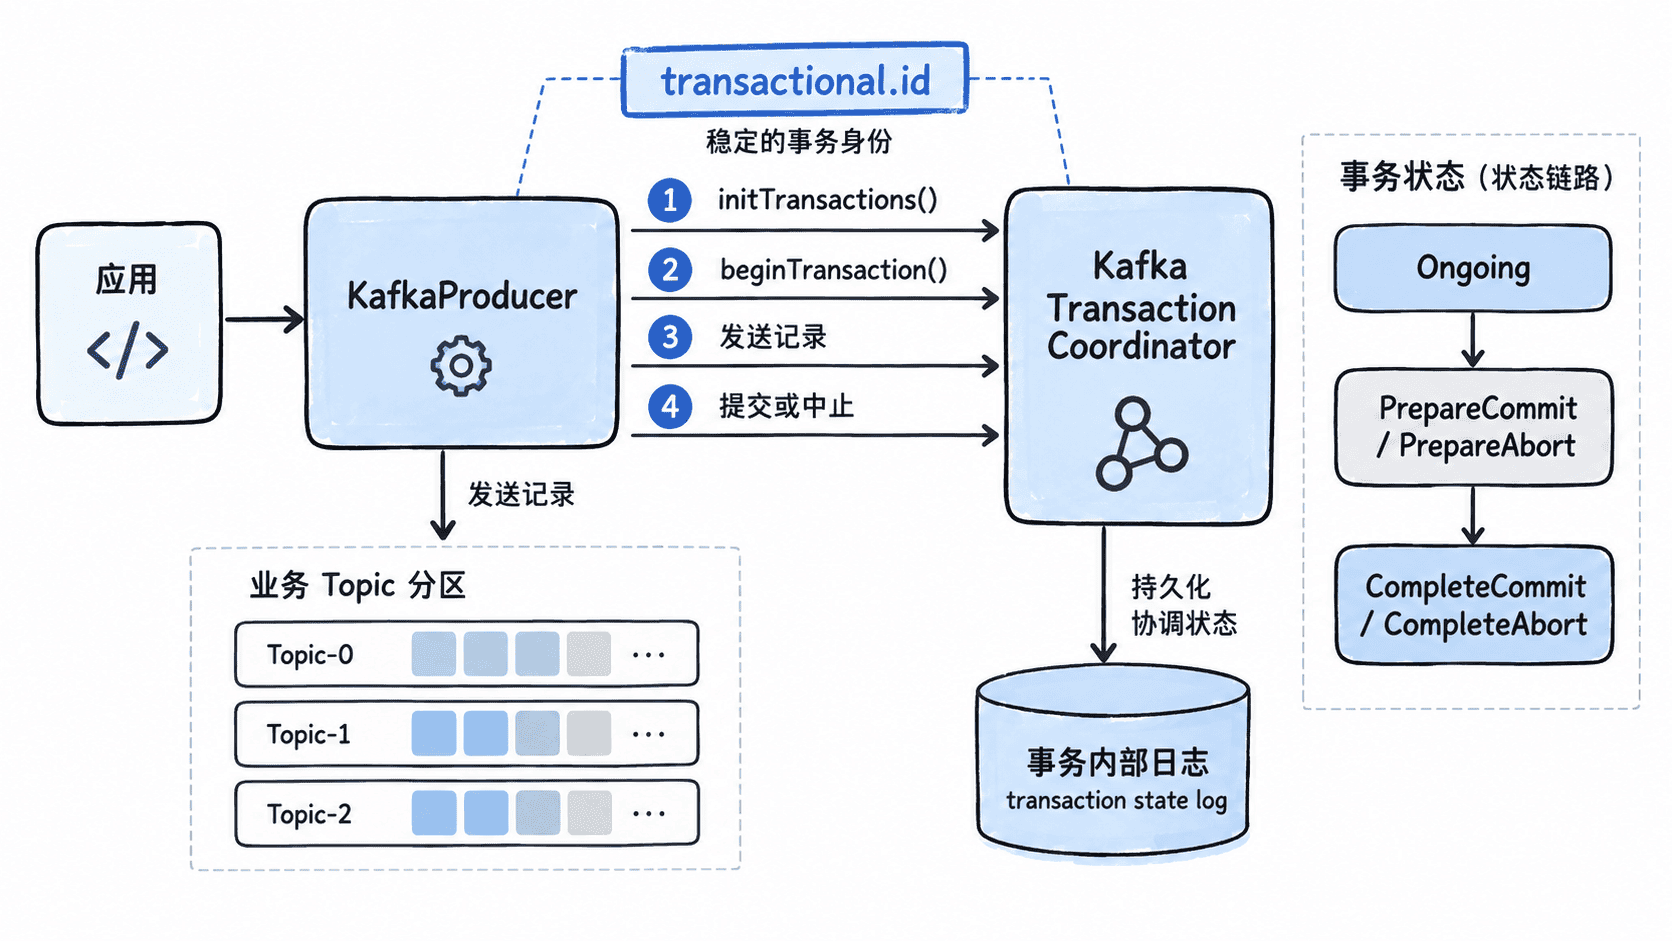
Kafka 事务不是某一个单独的 API 功能,而是一组对象共同完成的协议。应用侧最重要的是 KafkaProducer;服务端负责协调事务的是 Transaction Coordinator;事务身份通常由 transactional.id 建立稳定标识;协调过程中的状态会持久化到事务内部日志中。
可以把职责压缩成一句话:Producer 发起事务操作,transactional.id 标识可恢复的事务身份,Coordinator 协调状态,事务日志保存协调所需的状态信息。
transactional.id 为什么不是普通请求参数
transactional.id 是 Producer 的稳定事务身份。配置它后,Kafka 可以把一个逻辑上的事务 Producer 与服务端的事务状态关联起来,而不是把每次连接都当成完全独立的客户端。
这也是事务恢复和幂等语义的重要基础。实际部署中,一个 transactional.id 应对应一个逻辑 Producer 实例,不应让多个活跃实例随意共享同一个 ID,否则 Kafka 会根据生产者 epoch 机制淘汰旧实例,导致正在工作的 Producer 失效。
Producer 与 Transaction Coordinator 如何协作
应用调用 initTransactions() 时,Producer 会与 Kafka 集群建立事务上下文。Producer 并不是自己决定事务最终状态,而是通过事务协议与对应的 Transaction Coordinator 协作。
一次事务执行时,Producer 会向业务 Topic 写入记录,同时向 Coordinator 报告事务涉及的分区等信息。事务提交或中止时,Coordinator 负责推进事务状态,并让消费者能够根据事务标记判断哪些记录最终可见。
事务日志保存什么
Kafka 会使用内部事务状态日志持久化事务协调信息。它记录的是服务端协调事务所需要的状态,例如事务对应的 Producer 身份、涉及的分区以及事务状态变化,而不是把业务消息正文复制一份进去。
因此,事务日志与业务 Topic 的职责不同:业务 Topic 保存业务记录,事务日志保存事务协调元数据。两者共同作用,才能让 Kafka 在事务写入、提交和异常恢复过程中判断一批记录是否属于已经完成的事务。
事务状态如何变化
理解状态比背状态名更重要。一个事务通常经历“开始运行 → 准备提交或中止 → 完成”这样的生命周期。Producer 发起操作后,Coordinator 根据协议推进状态;提交成功后,消费者在 read_committed 模式下才能看到属于已提交事务的数据。
对于异常路径,事务不会因为 Producer 本地抛出异常就自动完成服务端协调。应用通常需要调用 abortTransaction() 结束事务,或者在初始化新事务时由 Kafka 依据 Producer epoch 等机制处理旧事务实例的状态。
用一个最小实验观察事务对象
下面示例只验证事务 Producer 能完成初始化和提交,不展开消费者验证。示例依赖 Kafka Java 客户端,并假设本机 Kafka Broker 已运行在 <PORT> 端口。
import java.util.Properties;
import org.apache.kafka.clients.producer.KafkaProducer;
import org.apache.kafka.clients.producer.ProducerRecord;

public class TransactionObjectDemo {
    public static void main(String[] args) {
        Properties props = new Properties();
        props.put("bootstrap.servers", "localhost:<PORT>");
        props.put("key.serializer", "org.apache.kafka.common.serialization.StringSerializer");
        props.put("value.serializer", "org.apache.kafka.common.serialization.StringSerializer");
        props.put("enable.idempotence", "true");
        props.put("transactional.id", "transaction-object-demo-<ID>");

        try (KafkaProducer<String, String> producer = new KafkaProducer<>(props)) {
            producer.initTransactions();
            producer.beginTransaction();
            producer.send(new ProducerRecord<>("orders", "order-1", "created"));
            producer.commitTransaction();
        }
    }
}
预期结果:程序正常结束;该 Producer 使用固定的 transactional.id 建立事务身份,并在一次事务中发送记录后成功提交。若 Broker、Topic 或客户端依赖未准备好,程序会在对应调用处抛出异常,而不是产生静默成功。
最容易混淆的三个边界
第一,transactional.id 不是 Topic 名称,它标识的是逻辑事务 Producer。第二,Transaction Coordinator 不是业务 Topic 的 leader,它负责事务协调。第三,事务日志不是业务数据表,它保存的是事务协议运行所需的状态信息。
掌握这三个边界后,再看 initTransactions()、提交、回滚和 Exactly-Once,就不会把“业务消息存在哪里”和“事务状态由谁协调”混成一件事。