
消息队列 / 系统课时
理解事务超时与 fencing
理解事务超时与 fencing
本课解决两个容易混在一起的问题:Kafka 为什么会因事务超时而终止事务,以及为什么同一个 transactional.id 建立新的 Producer epoch 后,旧 Producer 会被 fencing。掌握事务时间预算、Producer epoch 与实例恢复时序,就能准确判断长事务失败和身份冲突。
学习目标
- 理解 Producer 端
transaction.timeout.ms与 Broker 端transaction.max.timeout.ms的关系 - 区分事务超时与 Producer epoch 变化导致的 fencing,并判断各自的故障路径
- 区分单实例正常重启与同一
transactional.id被多个活跃实例同时使用的风险
事务超时由谁决定
事务不能无限期保持打开状态。Producer 通过 transaction.timeout.ms 声明事务允许持续的最长时间,Broker 通过 transaction.max.timeout.ms 限制客户端可以申请的最大值,因此客户端请求的事务超时时间不能超过 Broker 上限。
这里要区分事务生命周期与单次请求超时。transaction.timeout.ms 针对的是一个事务从开始到结束的时间预算,不是某条 send() 请求的网络等待时间。一个事务即使持续发送很多消息,只要整体没有及时完成,仍可能因事务超时而进入失败路径。
下面是一个典型 Producer 配置片段,用来表达超时边界。它不是完整客户端程序,因此只展示与本课直接相关的参数。
# 事务总时间预算必须落在 Broker 允许范围内
bootstrap.servers=<BOOTSTRAP_SERVERS>
transactional.id=<TRANSACTIONAL_ID>
transaction.timeout.ms=<VALUE>这是一个片段示例。其中 transaction.timeout.ms 必须符合 Broker 端 transaction.max.timeout.ms 的限制;实际数值应结合业务处理时长、重试策略和故障恢复窗口设置。若申请值超过 Broker 上限,Producer 初始化事务能力时会被拒绝,而不会自动突破 Broker 限制。
预期结果
transaction.timeout.ms 在 Broker 允许范围内:Producer 可以正常初始化事务能力
transaction.timeout.ms 超过 transaction.max.timeout.ms:事务初始化被 Broker 拒绝
实际日志与异常文本可能因客户端版本而不同
事务超时发生后会怎样
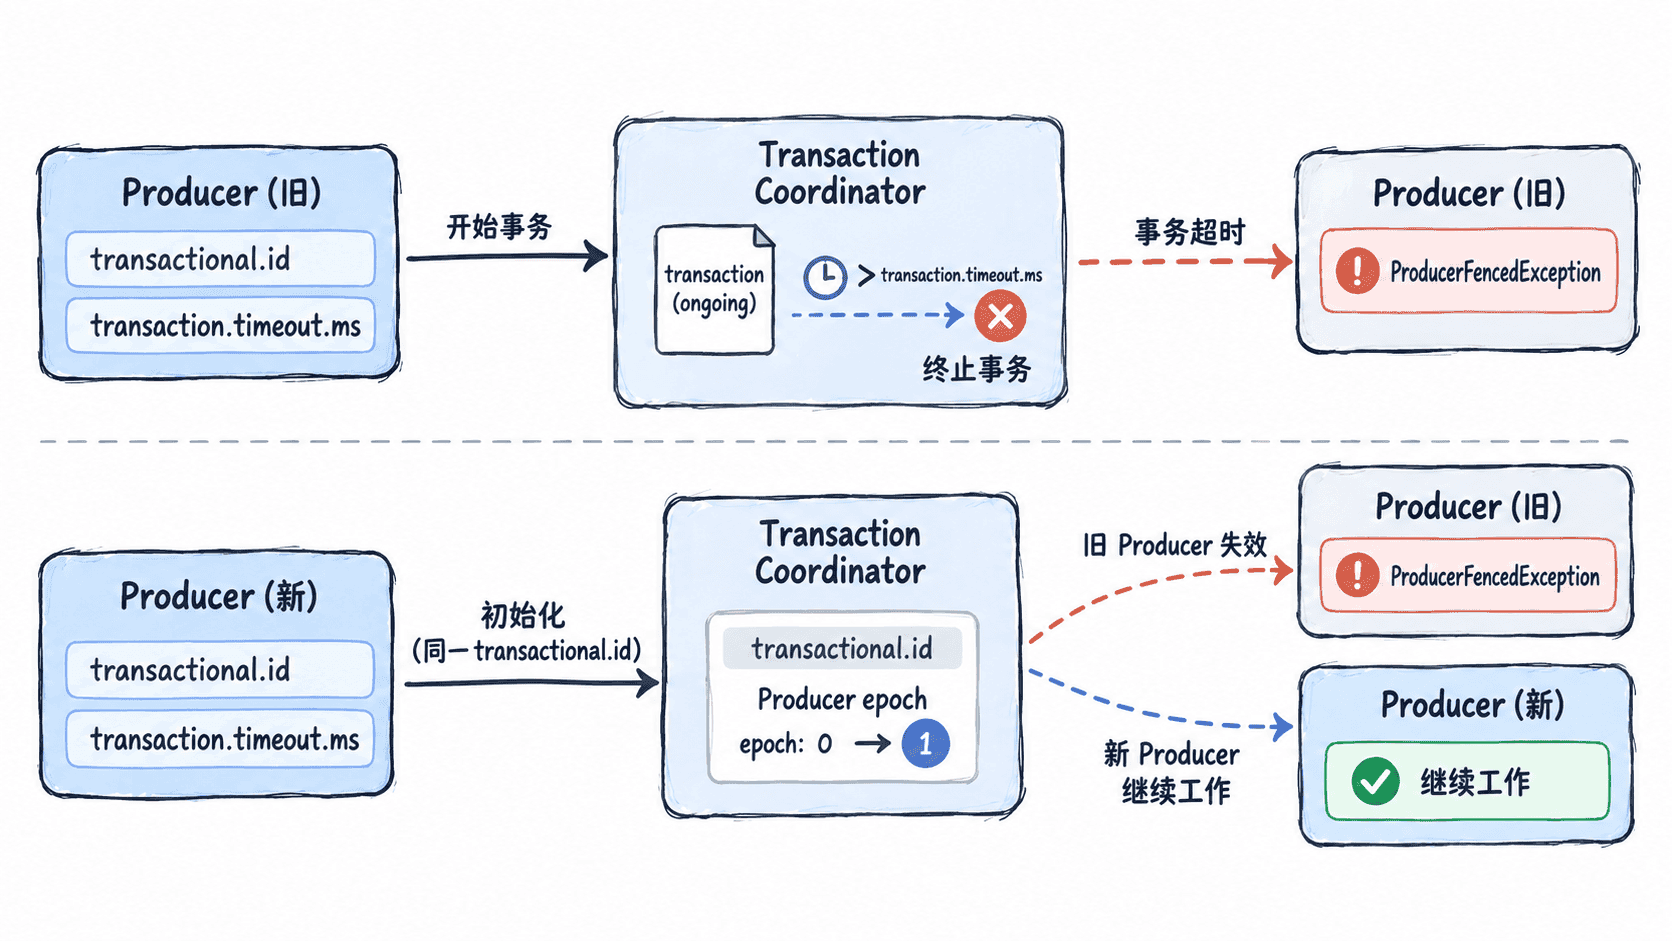
假设 Producer 已开启事务,但事务长时间没有结束,超过有效事务超时后,Kafka 的事务协调机制会使该事务进入终止路径。应用不能再把它当作仍然有效的事务继续提交,后续事务操作可能失败。
因此,事务超时并不只是“Producer 线程慢了一点”。一旦当前事务已经失效,业务必须按事务失败路径处理,并在需要时重新开始新的事务,而不能继续依赖原事务完成提交。
工程上应避免把数据库调用、远程 RPC、人工等待或不可控的批量计算无限塞进 Kafka 事务边界。事务时间预算越紧,网络抖动、下游变慢或进程长时间停顿带来的超时风险越高。
fencing 是什么
transactional.id 标识事务性 Producer 的逻辑身份。Kafka 会为事务性 Producer 维护 Producer ID 与 epoch;当同一个 transactional.id 被新的 Producer 身份初始化并取得更新后的 epoch 时,旧 epoch 即不再有效,这就是 producer fencing。
正常重启与双实例并存需要分开判断。正常重启是旧实例已经停止其事务工作,再由恢复实例使用相同的 transactional.id 重新初始化,这是恢复同一逻辑 Producer 的常见方式。真正危险的是旧实例尚未完全退出,新实例已经使用相同 transactional.id 完成初始化:此时两个进程可能同时存活,但 Kafka 只承认最新 epoch,旧实例会被 fencing。
典型时序是:Producer A 使用 <TRANSACTIONAL_ID> 工作;A 崩溃或正在恢复,新实例 Producer B 使用相同的 transactional.id 初始化并取得更新后的 Producer epoch。B 成为当前有效身份后,A 若仍继续发起事务相关请求,就可能收到 ProducerFencedException 等 fencing 失败;B 则继续代表该 transactional.id 工作。
超时与 fencing 不是一回事
两者都可能导致事务失败,但触发依据不同。事务超时回答的是“当前事务持续时间已经超过允许窗口”;fencing 回答的是“这个 Producer 使用的 epoch 已经过时,不再有资格代表该 transactional.id 工作”。
排查时可以先判断失败发生在事务生命周期超时还是Producer 身份竞争路径,再分别检查 transaction.timeout.ms、Broker 的 transaction.max.timeout.ms、transactional.id 是否被重复使用,以及是否存在实例重启、双实例并存或旧实例未及时退出。
如果系统经常出现事务超时,应先缩短事务内部不可控的工作并重新评估时间预算;如果频繁出现 fencing,则应重点检查 transactional.id 的分配策略、实例生命周期和故障恢复时序,确保同一逻辑身份不会长期由多个仍在工作的 Producer 同时占用。
最终可以把两个机制记成一句工程规则:超时限制事务能活多久,Producer epoch 与 fencing 限制谁有资格继续代表这个事务身份工作。