
消息队列 / 系统课时
验证状态与输出一致性
验证状态与输出一致性
这节解决一个实际问题:Kafka Streams 任务处理一批输入后,Kafka Streams 管理的状态、输入 offset 和 Kafka 输出如何保持对应关系,以及任务异常重启后能否从一致的位置恢复。最终你会用日志和状态观察验证事务边界,而不是只看“消息有没有发出去”。
学习目标
- 能准确区分 Kafka Streams 管理的状态、输入 offset 与 Kafka 输出之间的提交关系。
- 能通过可重复实验观察任务重启后的恢复结果。
- 能识别“输出存在但状态未更新”等现象为什么不应直接被视为最终一致结果。
验证三个结果是否处于同一处理边界
启用 Kafka Streams 的 Exactly-Once 语义后,验证范围应限定在 Kafka Streams 管理的可恢复状态、输入 offset 与 Kafka 输出。对于参与 Kafka Streams 处理语义的状态存储,状态变更会通过 Kafka Streams 的持久化与恢复机制管理;输入 offset 与 Kafka 输出则由 Kafka Streams 在处理事务中协调提交。这里的“一致”不是说每个 State Store 对象本身都是一个独立的外部事务资源,也不是所有状态变更都能脱离 Kafka Streams 的实现细节直接等同于数据库事务。
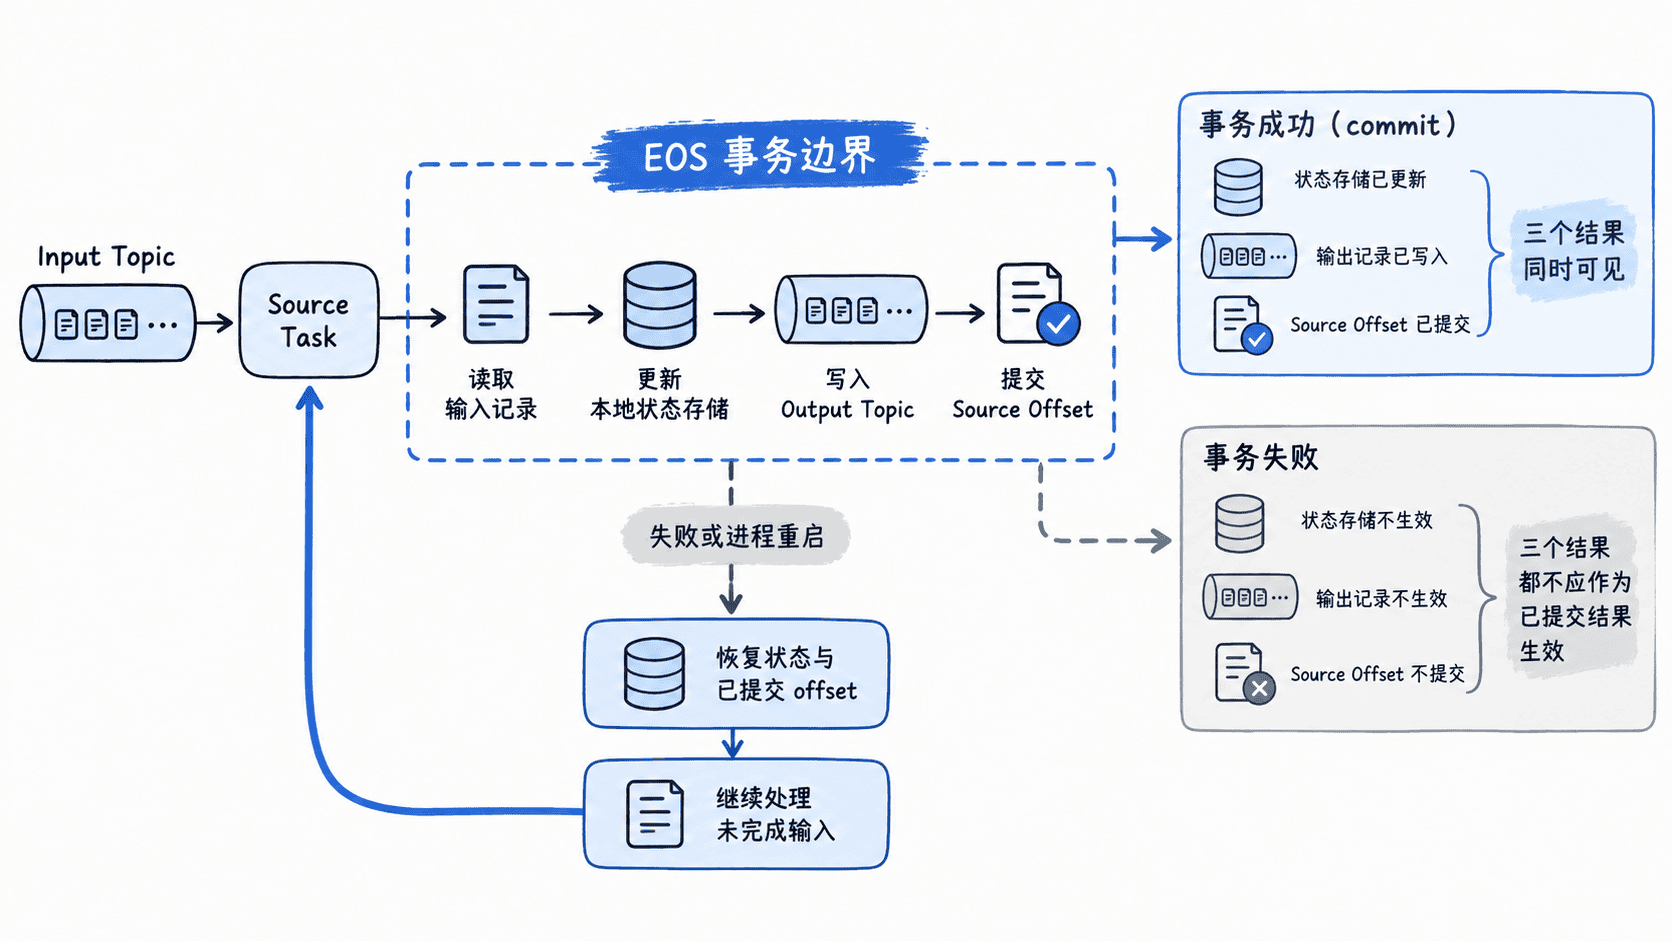
因此,验证时不要只检查输出 topic。至少同时观察三个信号:源分区的已提交 offset、Kafka Streams 管理状态的最终结果,以及输出 topic 中对 read_committed 消费者可见的记录。三者应放在同一个已提交处理边界中解释;事务尚未提交或失败后重新执行时出现的中间现象,不应直接当作最终结果。
用最小拓扑观察状态与输出
下面的片段示例使用 Kafka Streams 的聚合拓扑,把输入值按 key 累加,再把聚合结果输出到结果 topic。它依赖已经存在的 input-topic 与 output-topic,并要求应用使用 Exactly-Once 语义。由于 KTable 输出的是聚合更新,同一个 key 可能产生多条输出,因此验收时应比较最终聚合值与已提交输出中的最终更新,而不是简单比较消息条数。
import org.apache.kafka.common.serialization.Serdes;
import org.apache.kafka.streams.KafkaStreams;
import org.apache.kafka.streams.StreamsBuilder;
import org.apache.kafka.streams.StreamsConfig;
import org.apache.kafka.streams.kstream.KStream;
import org.apache.kafka.streams.kstream.KTable;

import java.util.Properties;

public class EosConsistencyExample {
    public static void main(String[] args) {
        Properties props = new Properties();
        props.put(StreamsConfig.APPLICATION_ID_CONFIG, "eos-consistency-demo");
        props.put(StreamsConfig.BOOTSTRAP_SERVERS_CONFIG, "localhost:9092");
        // 让输入 offset、Kafka 输出和 Kafka Streams 管理的状态按同一处理事务提交。
        props.put(StreamsConfig.PROCESSING_GUARANTEE_CONFIG, StreamsConfig.EXACTLY_ONCE_V2);
        props.put(StreamsConfig.DEFAULT_KEY_SERDE_CLASS_CONFIG, Serdes.String().getClass());
        props.put(StreamsConfig.DEFAULT_VALUE_SERDE_CLASS_CONFIG, Serdes.Long().getClass());

        StreamsBuilder builder = new StreamsBuilder();
        KStream<String, Long> input = builder.stream("input-topic");
        KTable<String, Long> totals = input.groupByKey().reduce(Long::sum);
        totals.toStream().to("output-topic");

        KafkaStreams streams = new KafkaStreams(builder.build(), props);
        Runtime.getRuntime().addShutdownHook(new Thread(streams::close));
        streams.start();
    }
}
预期结果
应用启动后正常建立 Stream Task 并开始处理输入。正常提交的处理边界对应已提交的输入 offset 与 Kafka 输出,Kafka Streams 管理的可恢复状态也可按其恢复机制重建到相应位置。任务异常重启后,未提交事务中的结果不会被当成已经成功提交的最终结果。运行后向 input-topic 写入同一个 key 的多条记录,并观察 output-topic 与任务状态。验证重点不是输出条数本身,而是重启发生在处理过程中时,恢复后的最终状态、已提交输出中的最终更新以及已提交输入位置是否仍然对应。
用重启验证恢复边界
验证恢复行为时,最好在持续输入过程中主动终止任务,再重新启动同一个 application.id。观察恢复日志、状态值和输出记录的最终结果。重点寻找的是“最后一个完整提交边界”,而不是进程被杀死的瞬间。
有一个常见误区:看到任务重启后某条输入似乎又被处理一次,就直接认定 EOS 失效。更准确的判断标准是最终可见结果。事务内的中间处理可以在失败后被放弃并重新执行;Exactly-Once 关注的是已提交结果的可见性与对应关系,而不是要求任何内部计算路径只执行一次。
如何判定验证通过
可以按下面的顺序验收:
- 记录输入 topic 的测试数据与源分区 offset,并确定测试 key 的预期聚合结果。
- 检查 Kafka Streams 管理的状态对应的最终聚合值,确认它包含已经成功提交的数据。
- 使用
read_committed方式检查输出 topic 中已经提交的记录,并按 key 对照最终聚合更新,而不是只比较记录条数。 - 在下一批数据处理期间重启任务,再次比较状态、已提交输出和恢复后的处理位置。
- 对失败场景区分“事务已提交”和“事务被中止”,不要用客户端缓存、未提交读取结果或单次处理日志下结论。
真正有效的验证,是让任务在处理中断、恢复,再检查最终可见状态。只要把“输入位置、Kafka Streams 管理的状态结果、Kafka 输出”放回同一个已提交的处理边界中观察,就能判断恢复后的结果是否符合预期,而不是只凭某一次处理日志下结论。