
消息队列 / 系统课时
演练重复与事务异常
演练重复与事务异常
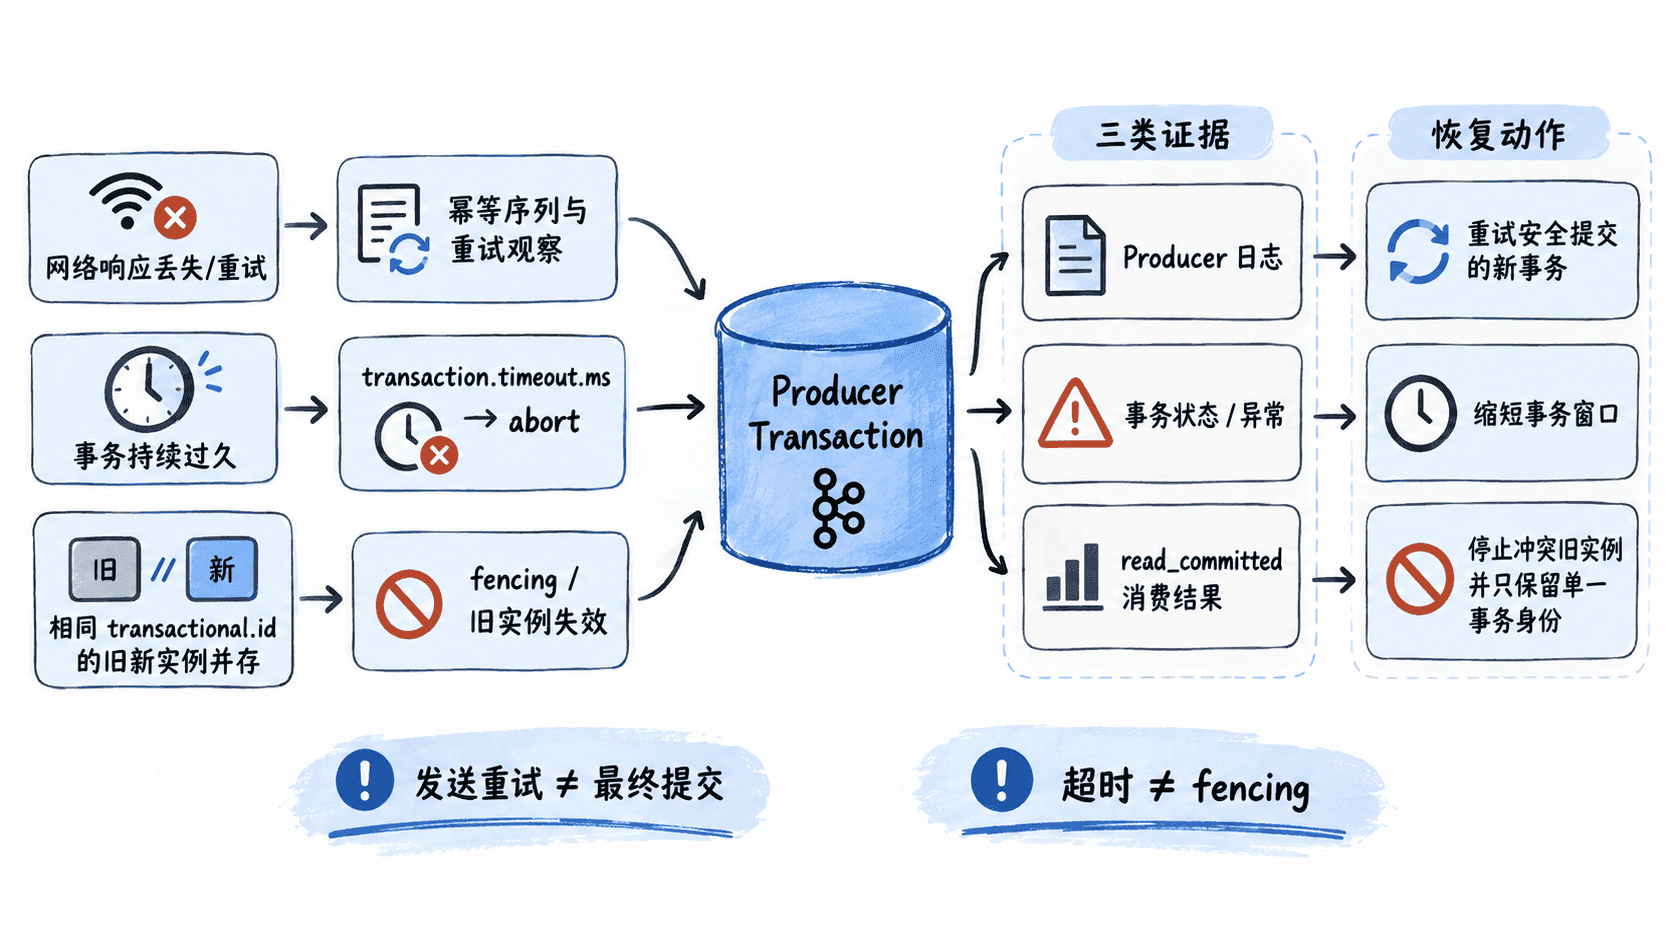
本课把网络重试、事务超时和 fencing 放进同一条诊断链。你将根据生产者日志、事务状态和消费者可见结果,判断故障发生在发送、事务存活还是事务身份层,并用一致的验收标准完成恢复。
学习目标
- 能区分网络重试造成的重复发送风险与事务最终结果。
- 能通过事务持续时间和协调器行为判断事务超时。
- 能识别 fencing 的根因,并安全地只保留一个有效生产者实例。
先建立故障判别框架
网络重试最容易误判:客户端可能因为响应丢失而再次发送,而幂等生产者可以抑制同一会话中重复的序列号;事务语义则进一步决定这一批写入最终提交还是中止。因此不能只看“发送失败”,还要确认事务最终状态。
事务超时属于另一层问题:事务持续时间超过允许窗口后,Broker 会使事务失效。transaction.timeout.ms 定义事务超时时间,并且不能超过 Broker 的 transaction.max.timeout.ms。
fencing 更像“身份冲突”:两个实例使用同一个 transactional.id 时,新实例成为有效身份持有者,旧实例的后续事务操作会失败。重新启动应用并复用相同事务身份,可以让 Kafka 淘汰旧实例。
演练事务超时
先构造一个事务持续时间超过允许窗口的场景。网络抖动可能让请求已经到达 Broker,但客户端没有及时收到响应,所以一次请求失败不能直接等同于重复结果。下面的示例专门验证事务超时后的失败路径,并把异常类别留给客户端实际返回结果,而不是写死某个异常类。
<TIME> 表示事务超时时间,单位为毫秒,实际值可按实验环境调整。实验脚本故意等待超过该窗口,生产环境不要照搬这个测试窗口。
import org.apache.kafka.clients.producer.KafkaProducer;
import org.apache.kafka.clients.producer.ProducerConfig;
import org.apache.kafka.clients.producer.ProducerRecord;
import org.apache.kafka.common.KafkaException;

import java.util.Properties;

public class TransactionTimeoutDemo {
    public static void main(String[] args) throws InterruptedException {
        String timeoutMs = "<TIME>";
        Properties props = new Properties();
        props.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG, "<BOOTSTRAP_SERVERS>");
        props.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG,
                "org.apache.kafka.common.serialization.StringSerializer");
        props.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG,
                "org.apache.kafka.common.serialization.StringSerializer");
        props.put(ProducerConfig.TRANSACTIONAL_ID_CONFIG, "eos-timeout-demo");
        props.put(ProducerConfig.TRANSACTION_TIMEOUT_CONFIG, timeoutMs);

        try (KafkaProducer<String, String> producer = new KafkaProducer<>(props)) {
            producer.initTransactions();
            producer.beginTransaction();
            producer.send(new ProducerRecord<>("eos-demo", "timeout-test", "pending"));
            producer.flush();

            // 故意让事务持续时间超过 transaction.timeout.ms。
            Thread.sleep(Long.parseLong(timeoutMs) + 2000L);
            producer.commitTransaction();
        } catch (KafkaException e) {
            System.out.println("transaction operation failed: " + e.getClass().getSimpleName());
        }
    }
}
预期输出
transaction operation failed: <KafkaException子类>实际异常类由客户端版本、Broker 状态和超时触发时序决定,因此这里不把 ProducerFencedException 或其他单一异常写成固定结果。稳定的验收标准是:该事务没有成功提交,事务中的 pending 记录不能作为已提交事务被 read_committed 消费者读取。
演练 fencing 并恢复
fencing 的典型事故是旧实例没有完全退出,新实例已经使用相同 transactional.id 启动。此时旧实例继续调用事务 API 会失败。恢复时不要让两个实例“各自继续”,而应先确认哪个实例应当存活,停止冲突实例,再让唯一有效实例重新初始化事务并提交新的事务。
排查顺序可以固定为:先确认 transactional.id 是否重复,再定位各实例启动时间和进程标识,随后检查哪个实例仍在主动发送事务请求,最后验证唯一存活实例能否重新 initTransactions 并完成新的提交。判断重点是“谁拥有当前有效事务身份”,而不是“谁最后打印了一条日志”。
用日志和消费者结果闭环验收
不要把“异常消失”作为恢复完成标准。至少同时验证三件事:故障事务没有成为 read_committed 的可见业务结果;恢复后的唯一生产者能够完成一次新的 commit;消费者最终只收到预期提交的数据。
可以用下面的命令做最终读取验证。<PATH> 是实际消费者配置文件路径,实际值可能不同。
kafka-console-consumer.sh --bootstrap-server <BOOTSTRAP_SERVERS> --topic eos-demo --from-beginning --isolation-level read_committed --consumer.config <PATH>预期结果
不会出现事务超时测试中的 pending 记录;恢复后若存在新的已提交测试数据,则仅显示这些已提交记录。最后把故障归类写回运行手册:网络重试优先检查请求是否真正完成以及幂等序列;事务超时优先检查事务持续时间和 Broker 上限;fencing 优先检查 transactional.id 是否被多个实例并用。恢复动作必须针对故障层级执行,而不是看到一次生产者异常就盲目重启所有组件。