
消息队列 / 系统课时
理解 Producer 重试与重复写入
理解 Producer 重试与重复写入
这一课解决一个常见但容易误判的问题:Producer 已经把消息发给 Kafka,却因为响应丢失而再次发送。最终你会看到,重试解决的是发送失败问题,却不天然解决重复写入问题。
学习目标
- 能解释响应丢失时为什么同一业务消息可能被写入两次
- 能区分“消息发送了一次”和“Broker 日志最终出现几份”
- 能识别普通 Producer 在重试场景下的语义缺口
重试为什么会制造重复消息
Producer 发送消息后,需要等待 Broker 的响应确认。真正麻烦的不是“Broker 一定没收到”,而是“Producer 无法确定 Broker 是否已经收到”。例如请求已经成功写入 Leader,但响应在网络中丢失,Producer 只能把这次发送视为失败并再次提交。
这会形成典型的“未知结果”场景:第一次请求可能已经成功,第二次请求又被正常处理。对于没有启用幂等能力的 Producer,Broker 没有足够的信息判断这两次请求其实来自同一次发送意图,因此可能把两个记录都写入日志。
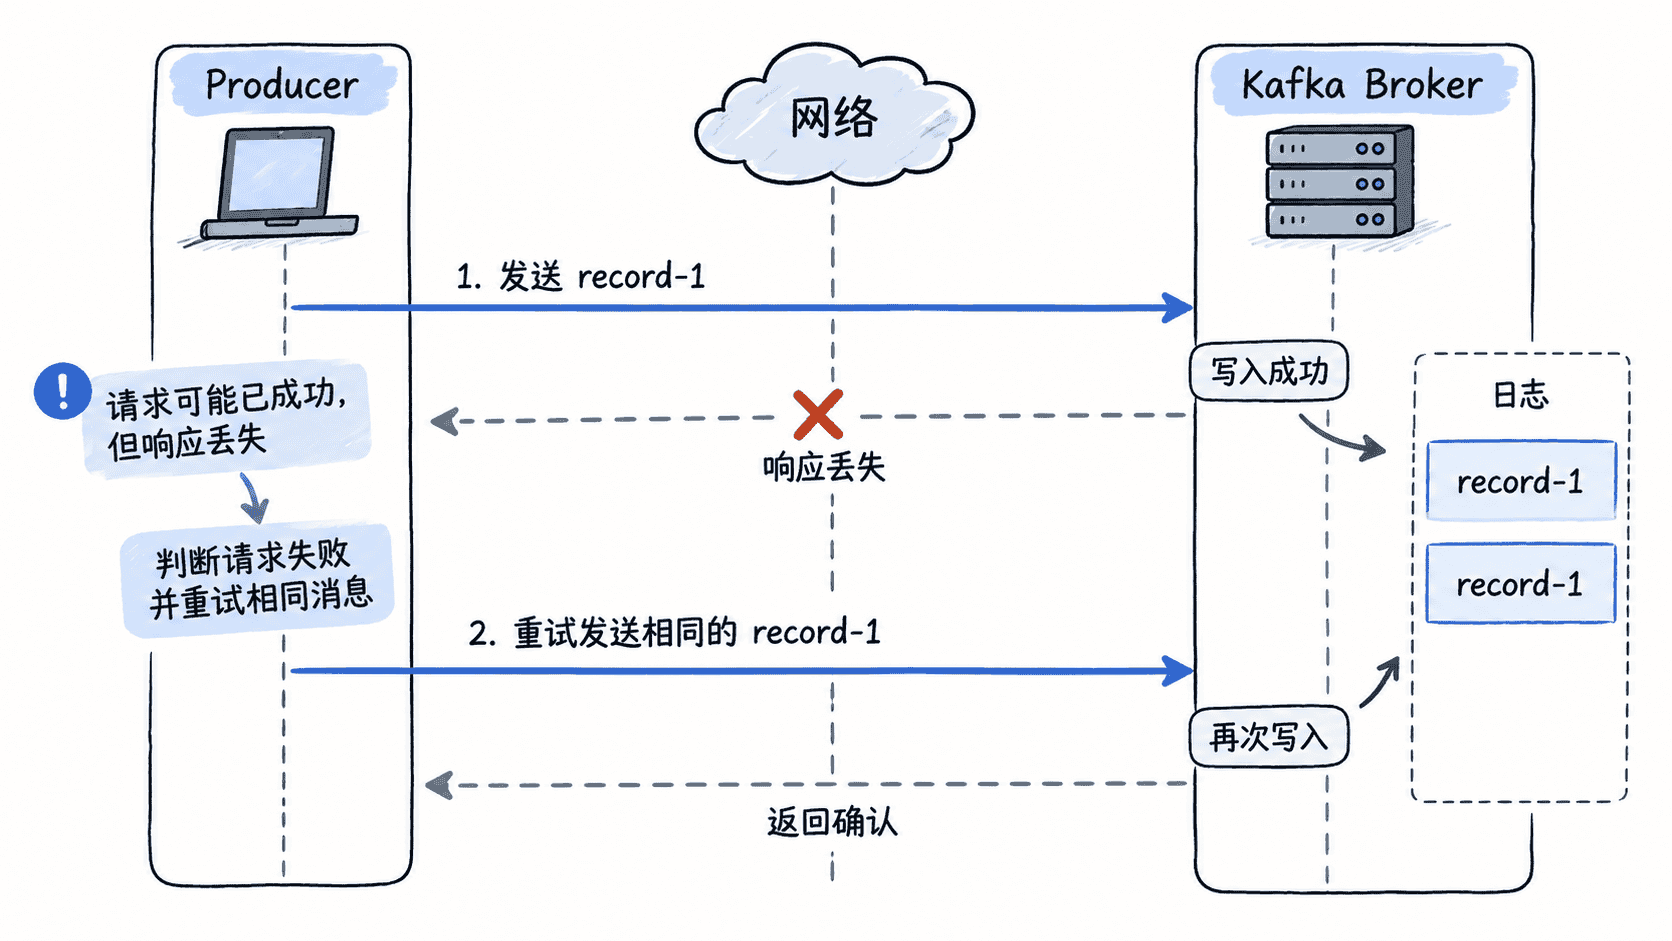
一次发送为什么不等于一次写入
可以把一次发送拆成三个不同问题:Producer 有没有发出请求、Broker 有没有接受请求、Producer 有没有收到成功响应。只有把这三个状态分开,才能理解重复消息的来源。
| 状态 | 可能结果 |
|---|---|
| 请求未到 Broker | 可以安全重试 |
| 请求已到且写入,但响应丢失 | 重试可能产生重复 |
| Broker 明确拒绝请求 | 根据错误类型决定是否重试 |
因此,“打开 retries”并不能自动得到 Exactly-Once。它首先是可靠传输机制:面对部分可恢复的网络或 Broker 故障,让客户端再次发送记录;在没有额外幂等机制时,这种再次发送本身就可能改变最终日志内容。
用一个生产者配置片段观察语义
下面只保留普通 Producer 的关键配置。它是配置片段示例,依赖已有 Kafka Producer 客户端和可访问的 Broker;重点是观察 retries 与 enable.idempotence 的关系。
bootstrap.servers=<HOST>:<PORT>
acks=all
retries=5
enable.idempotence=false
这里明确允许重试,却关闭了幂等性。发生“首次请求已写入、确认响应丢失”时,同一条记录可能再次进入 Broker。acks=all能够增强持久性确认,但它本身并不让重复请求自动合并;可靠性与去重是两个不同维度。
线上排查时先找什么
看到“业务消息重复”时,不要直接认定是消费者重复消费。先确认重复记录是否真的存在于 Kafka 日志中,再检查 Producer 是否发生重试,以及异常是否属于响应未知的网络路径。
一个实用判断顺序是:Producer 日志与重试次数 → Broker 端记录是否重复 → Consumer 是否重复提交或重新消费。如果 Kafka 日志本身已经存在两条业务等价消息,那么仅修改消费者提交策略无法消除源头问题。
还要注意,业务上的“相同消息”通常依据业务键判断,例如订单号,而 Kafka 自身首先处理的是具体 Record。没有幂等机制时,Kafka 并不知道两条携带相同订单号的 Record 是否代表同一次业务操作。
记住这个边界
Producer 重试解决的是“失败后再试一次”,而幂等生产解决的是“再试也不要在日志中产生重复副本”。二者经常一起出现,但并不是同一个语义层次。