
消息队列 / 系统课时
配置 read_committed 消费
配置 read_committed 消费
本课解决事务消息“生产成功了但消费者到底看不看得到”的问题。通过配置消费者的 isolation.level,可以控制 poll() 对事务消息的可见性:read_committed 只读取已提交事务消息,read_uncommitted 则会读取包括已中止事务消息在内的全部消息。
学习目标
- 理解
isolation.level对事务消息可见性的控制范围。 - 能用
read_committed和read_uncommitted做对照验证。 - 理解
read_committed与 Last Stable Offset(LSO)的关系。
两种可见性模式
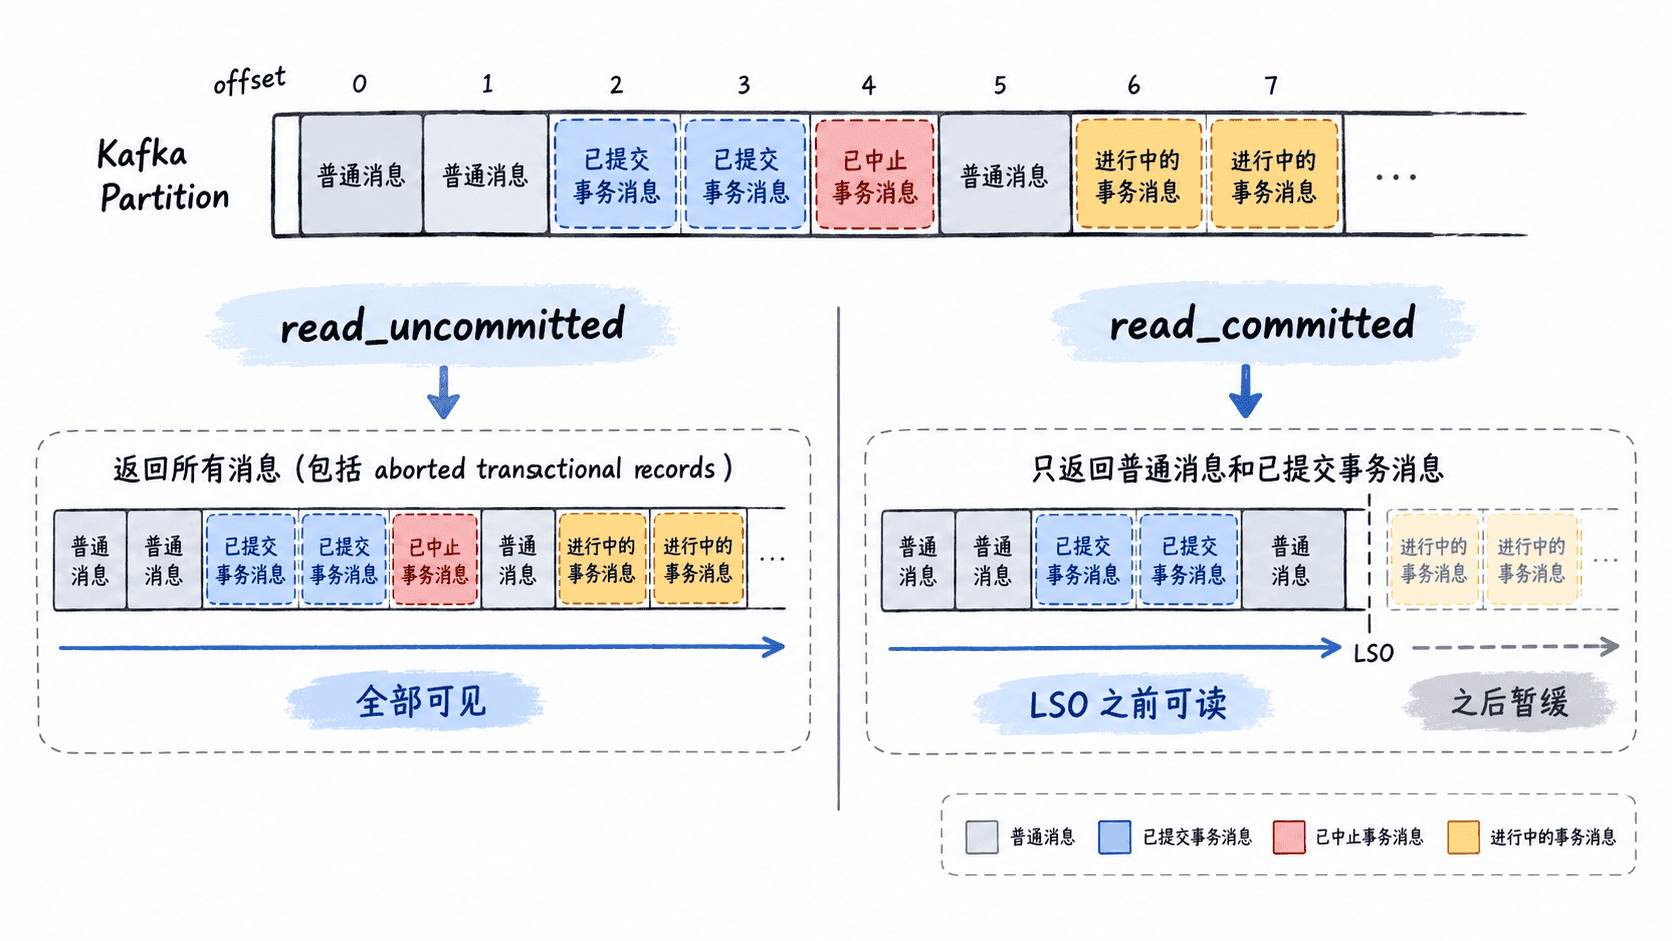
Kafka 消费者支持 read_committed 和 read_uncommitted 两种隔离级别。默认是 read_uncommitted:消费者会返回所有消息,包括事务最终被 abort 的消息;read_committed 则只返回已经成功提交的事务消息。非事务消息在两种模式下都可以正常返回。:contentReference[oaicite:5]{index=5}
因此,read_committed 不是“让生产端自动变成 EOS”,也不是“保证整个业务链路绝对只执行一次”。它解决的是消费者对事务结果的可见性,让下游消费方不会把已中止事务里的消息当成正常业务输入。
配置消费者
Java 客户端直接通过 ConsumerConfig.ISOLATION_LEVEL_CONFIG 配置。实践中,面向需要消费事务输出的下游应用,应明确写出 read_committed,不要依赖默认值,以免部署配置变化后误读已中止事务数据。
下面的配置片段只展示与本课直接相关的消费者配置,依赖标准 Kafka Consumer 创建上下文。
import org.apache.kafka.clients.consumer.ConsumerConfig;
import java.util.Properties;

Properties props = new Properties();
props.put(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG, "<BOOTSTRAP>");
props.put(ConsumerConfig.GROUP_ID_CONFIG, "<GROUP_ID>");
props.put(ConsumerConfig.KEY_DESERIALIZER_CLASS_CONFIG,
    "org.apache.kafka.common.serialization.StringDeserializer");
props.put(ConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG,
    "org.apache.kafka.common.serialization.StringDeserializer");
props.put(ConsumerConfig.ENABLE_AUTO_COMMIT_CONFIG, "false");
props.put(ConsumerConfig.ISOLATION_LEVEL_CONFIG, "read_committed");
预期结果
消费者创建成功后,poll() 只返回普通消息和已提交的事务消息;已中止事务中的消息不会返回给应用。这里的 ENABLE_AUTO_COMMIT_CONFIG=false 是为了避免本课的验证被自动提交行为干扰;它不是 read_committed 的必要条件。isolation.level 本身只负责事务消息读取时采用哪种可见性规则。Kafka 官方配置文档明确给出了这两个合法值以及默认的 read_uncommitted。:contentReference[oaicite:6]{index=6}
用同一份数据做对照验证
验证时最容易理解的方法,是让生产端写入三类结果:普通消息、一条已成功提交的事务消息,以及一条最终 abort 的事务消息,然后分别使用两种 isolation level 消费。
验证命令示例:
kafka-console-consumer.sh --bootstrap-server <BOOTSTRAP> --topic <TOPIC> --from-beginning --isolation-level read_uncommitted预期输出
ordinary-1
committed-tx-1
aborted-tx-1
再使用提交读模式:
kafka-console-consumer.sh --bootstrap-server <BOOTSTRAP> --topic <TOPIC> --from-beginning --isolation-level read_committed预期输出
ordinary-1
committed-tx-1这组结果体现的是事务状态过滤:已中止事务消息仍可能真实存在于日志的 offset 序列中,但 read_committed 不会把它们交给 poll()。Kafka 官方文档也明确说明,read_committed 会过滤掉 aborted transactional messages。:contentReference[oaicite:7]{index=7}
理解 LSO 带来的延迟现象
read_committed 还有一个很容易在生产环境造成误判的特性:消费者的可读边界可能落后于分区的 high watermark。原因是 Kafka 必须等进行中的事务最终完成,才能确定这些事务里的消息是 committed 还是 aborted,因此 read_committed 的可读位置受到 Last Stable Offset,也就是 LSO 的限制。:contentReference[oaicite:8]{index=8}
例如某个分区前面已经有普通消息,随后出现一笔尚未完成的事务;即使更后面的 offset 已经写入,read_committed 消费者也可能暂时拿不到这些更靠后的消息。事务完成后,LSO 才继续推进,消费者才可以继续读取。
因此,排查“Kafka 明明有数据,消费者却暂时读不到”时,不能直接得出“消息丢了”的结论。需要先判断消费者是否使用 read_committed,再确认前方是否存在未完成事务。Kafka 官方文档明确指出,在存在进行中事务时,read_committed 消费者可能无法读到 high watermark。:contentReference[oaicite:9]{index=9}
什么时候应该使用 read_committed
只要下游业务依赖上游的 Kafka 事务语义,希望把“已中止事务的数据”彻底排除在业务处理之外,就应优先使用 read_committed。特别是在 consume-transform-produce 链路中,下游若继续使用 read_uncommitted,即使上游已经正确执行事务,也可能把最终 abort 的中间结果读出来。
相反,read_uncommitted 并不表示消费者端发生错误,它只是选择不按事务状态过滤消息。在只关心日志原始记录、调试事务行为或明确接受 aborted records 可见性的场景下,它仍然有使用价值。
最终要把两个概念分开:**事务生产决定消息最终是 committed 还是 aborted,isolation.level 决定消费者看到哪一类事务结果。**只有把生产端事务边界和消费端 read_committed 一起设计,事务消息的可见性语义才能在上下游之间闭合。