
消息队列 / 系统课时
完成 Java EOS 链路
完成 Java EOS 链路
这一课把消费—处理—生产闭环落到可运行的 Java 示例:消费者读取输入,事务生产者写入输出,并把消费位点一起提交到 Kafka 事务中。运行并验证恢复流程后,你可以用 read_committed 判断失败事务不会留下可见的已提交结果。
学习目标
- 配置 KafkaProducer 的事务能力,并理解
transactional.id的作用。 - 使用
sendOffsetsToTransaction把消费者位点与输出写入绑定。 - 用
read_committed消费结果,验证失败事务与成功事务的可见性。
最小链路与依赖
示例使用 Java 17、Kafka 客户端库 3.9.x。核心链路只有四步:poll 输入、beginTransaction 开始事务、发送处理结果并提交 offsets、commitTransaction 一起落地。启用事务的生产者会按事务语义管理消息提交,并要求使用唯一且稳定的 transactional.id。
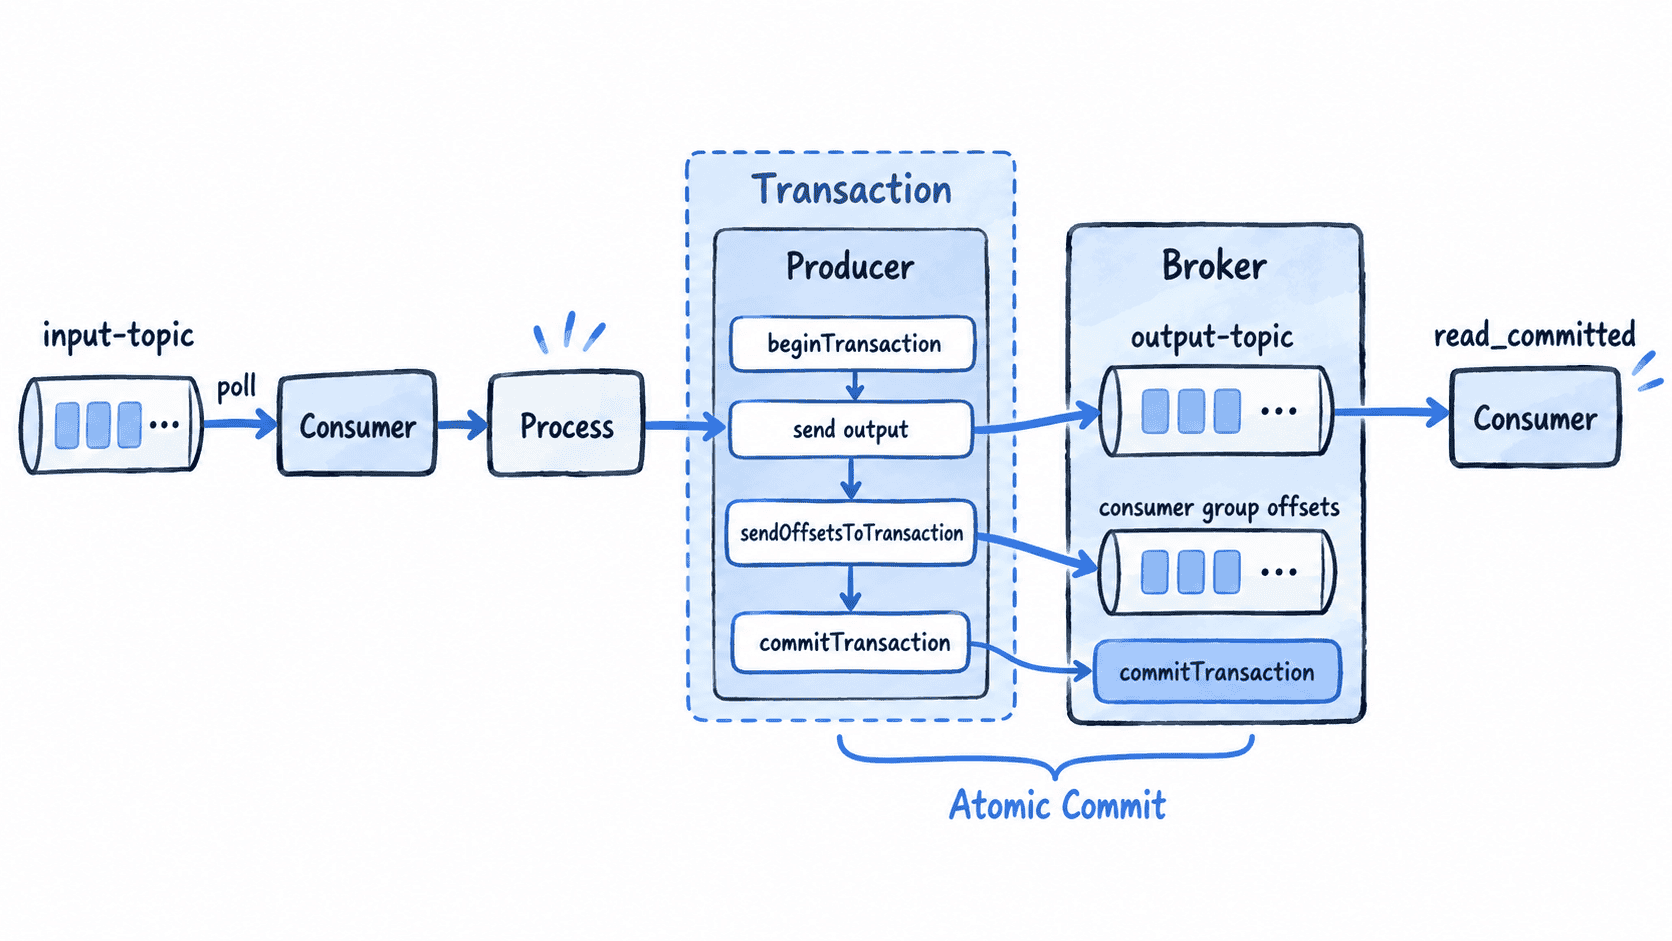
先准备依赖:
<dependency>
    <groupId>org.apache.kafka</groupId>
    <artifactId>kafka-clients</artifactId>
    <version>3.9.2</version>
</dependency>
预期结果
Maven 能解析 org.apache.kafka:kafka-clients:3.9.2;
项目可以使用 KafkaConsumer、KafkaProducer 与相关事务 API。
编写消费到生产事务
下面的示例把一批 input-topic 记录转换为 output-topic。为便于验证,它按一次 poll 开一个事务,并显式获取当前消费者组元数据。示例保持单个事务生产者身份,在同一个事务中完成输出写入和消费位点提交。
import org.apache.kafka.clients.consumer.ConsumerConfig;
import org.apache.kafka.clients.consumer.ConsumerRecords;
import org.apache.kafka.clients.consumer.KafkaConsumer;
import org.apache.kafka.clients.consumer.OffsetAndMetadata;
import org.apache.kafka.clients.producer.KafkaProducer;
import org.apache.kafka.clients.producer.ProducerConfig;
import org.apache.kafka.clients.producer.ProducerRecord;
import org.apache.kafka.common.TopicPartition;
import org.apache.kafka.common.serialization.StringDeserializer;
import org.apache.kafka.common.serialization.StringSerializer;

import java.time.Duration;
import java.util.Collections;
import java.util.HashMap;
import java.util.Map;
import java.util.Properties;

public class KafkaEosApp {
    public static void main(String[] args) {
        String bootstrap = "<BOOTSTRAP_SERVERS>";
        String inputTopic = "input-topic";
        String outputTopic = "output-topic";
        String groupId = "eos-demo-group";
        String transactionalId = "eos-demo-worker-1";

        Properties consumerProps = new Properties();
        consumerProps.put(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG, bootstrap);
        consumerProps.put(ConsumerConfig.GROUP_ID_CONFIG, groupId);
        consumerProps.put(ConsumerConfig.KEY_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class.getName());
        consumerProps.put(ConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class.getName());
        consumerProps.put(ConsumerConfig.ENABLE_AUTO_COMMIT_CONFIG, "false");
        consumerProps.put(ConsumerConfig.ISOLATION_LEVEL_CONFIG, "read_committed");

        Properties producerProps = new Properties();
        producerProps.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG, bootstrap);
        producerProps.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG, StringSerializer.class.getName());
        producerProps.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG, StringSerializer.class.getName());
        producerProps.put(ProducerConfig.ENABLE_IDEMPOTENCE_CONFIG, "true");
        producerProps.put(ProducerConfig.TRANSACTIONAL_ID_CONFIG, transactionalId);

        try (KafkaConsumer<String, String> consumer = new KafkaConsumer<>(consumerProps);
             KafkaProducer<String, String> producer = new KafkaProducer<>(producerProps)) {

            consumer.subscribe(Collections.singletonList(inputTopic));
            producer.initTransactions();

            while (true) {
                ConsumerRecords<String, String> records = consumer.poll(Duration.ofSeconds(1));
                if (records.isEmpty()) {
                    continue;
                }

                producer.beginTransaction();
                try {
                    for (var record : records) {
                        String value = record.value().toUpperCase();

                        // 输出记录和消费位点必须属于同一个 Kafka 事务。
                        producer.send(new ProducerRecord<>(outputTopic, record.key(), value)).get();
                    }

                    Map<TopicPartition, OffsetAndMetadata> offsets = new HashMap<>();
                    records.partitions().forEach(tp -> {
                        var partitionRecords = records.records(tp);
                        var lastRecord = partitionRecords.get(partitionRecords.size() - 1);
                        offsets.put(tp, new OffsetAndMetadata(lastRecord.offset() + 1));
                    });

                    producer.sendOffsetsToTransaction(offsets, consumer.groupMetadata());
                    producer.commitTransaction();
                    System.out.printf("committed records=%d%n", records.count());
                } catch (Exception e) {
                    producer.abortTransaction();
                    throw new RuntimeException("transaction failed", e);
                }
            }
        }
    }
}
预期输出
committed records=1多条输入时 records 数量可能不同;事务失败时不会打印 committed records。代码通过 get(size - 1) 取得分区内最后一条记录,兼容 Java 17,不使用 Java 21 才提供的 List.getLast()。
示例中的 <BOOTSTRAP_SERVERS> 代表实际 Kafka 地址,不能原样用于连接。records 跨多个分区时,代码分别取每个分区最后一条记录的下一位点,提交的是“本批已处理到哪里”,而不是当前 poll 的第一条位点。
运行前的两个边界
首先,transactional.id 必须具有稳定且唯一的处理身份。重启同一个逻辑实例时可以继续使用同一标识;横向扩容时不能让两个活跃实例共用它,否则 Kafka 会触发生产者围栏,旧实例的事务操作可能失败。
其次,事务只能保证 Kafka 内部的输出与消费位点原子提交。若事务中同时调用外部 HTTP、数据库或文件系统,Kafka 无法把这些副作用一起回滚,因此不要把“Kafka EOS”误解成整个业务系统的全局 Exactly-Once。
用 read_committed 验证结果
启动业务消费者时,将隔离级别设为 read_committed。准备一个输入记录,例如 order-1=created,运行应用后检查输出,应看到一条大写后的已提交消息。
输入:
key=order-1 value=created

预期输出:
key=order-1 value=CREATED
验证故障恢复时,可以在 beginTransaction() 到 commitTransaction() 之间强制终止进程,然后重新启动相同 transactional.id 的实例。下游 read_committed 消费者不应把那次未完成事务当成成功结果;恢复实例会从尚未提交的消费位点继续处理输入,最终形成新的已提交输出。
真正的验收标准是“已提交结果唯一”,而不是“代码从不重跑”。失败恢复允许重新处理输入,关键在于旧事务不能作为可见成功结果留下,同时新的输出和消费位点必须再次原子提交。