
消息队列 / 系统课时
理解 Producer 幂等机制
理解 Producer 幂等机制
这一课解决的是上一课留下的核心问题:响应可能丢失时,Producer 为什么可以安全重试同一条发送记录。重点不在“比较消息内容”,而在 Producer ID、epoch、分区序列号与 Broker 端状态如何协作识别重复发送,以及这些机制与事务身份之间的边界。
学习目标
- 理解
enable.idempotence开启后 Producer 与 Broker 如何协作避免重复写入 - 能说明 Producer ID、epoch、分区序列号和 Broker 重复检测各自承担什么职责
- 能区分幂等生产、事务语义与业务幂等,不再用“单次会话”简单概括其边界
幂等生产的核心思路
Kafka 的幂等 Producer 不是通过比较消息 value 来判断重复,而是让 Broker 能识别发送方身份及其对特定分区的写入顺序。Producer 获得 Producer ID(PID)后,向分区发送记录时会携带对应的序列号;Broker 根据该 Producer 在目标分区上的状态检查序列号,从而识别因响应丢失而产生的重试请求。
因此,去重依据不是“两个消息内容一样”,而是 Producer 身份与分区内序列推进关系。两条业务消息即使 value 完全相同,只要它们对应不同的发送记录,也不能仅凭内容相同就视为重复。
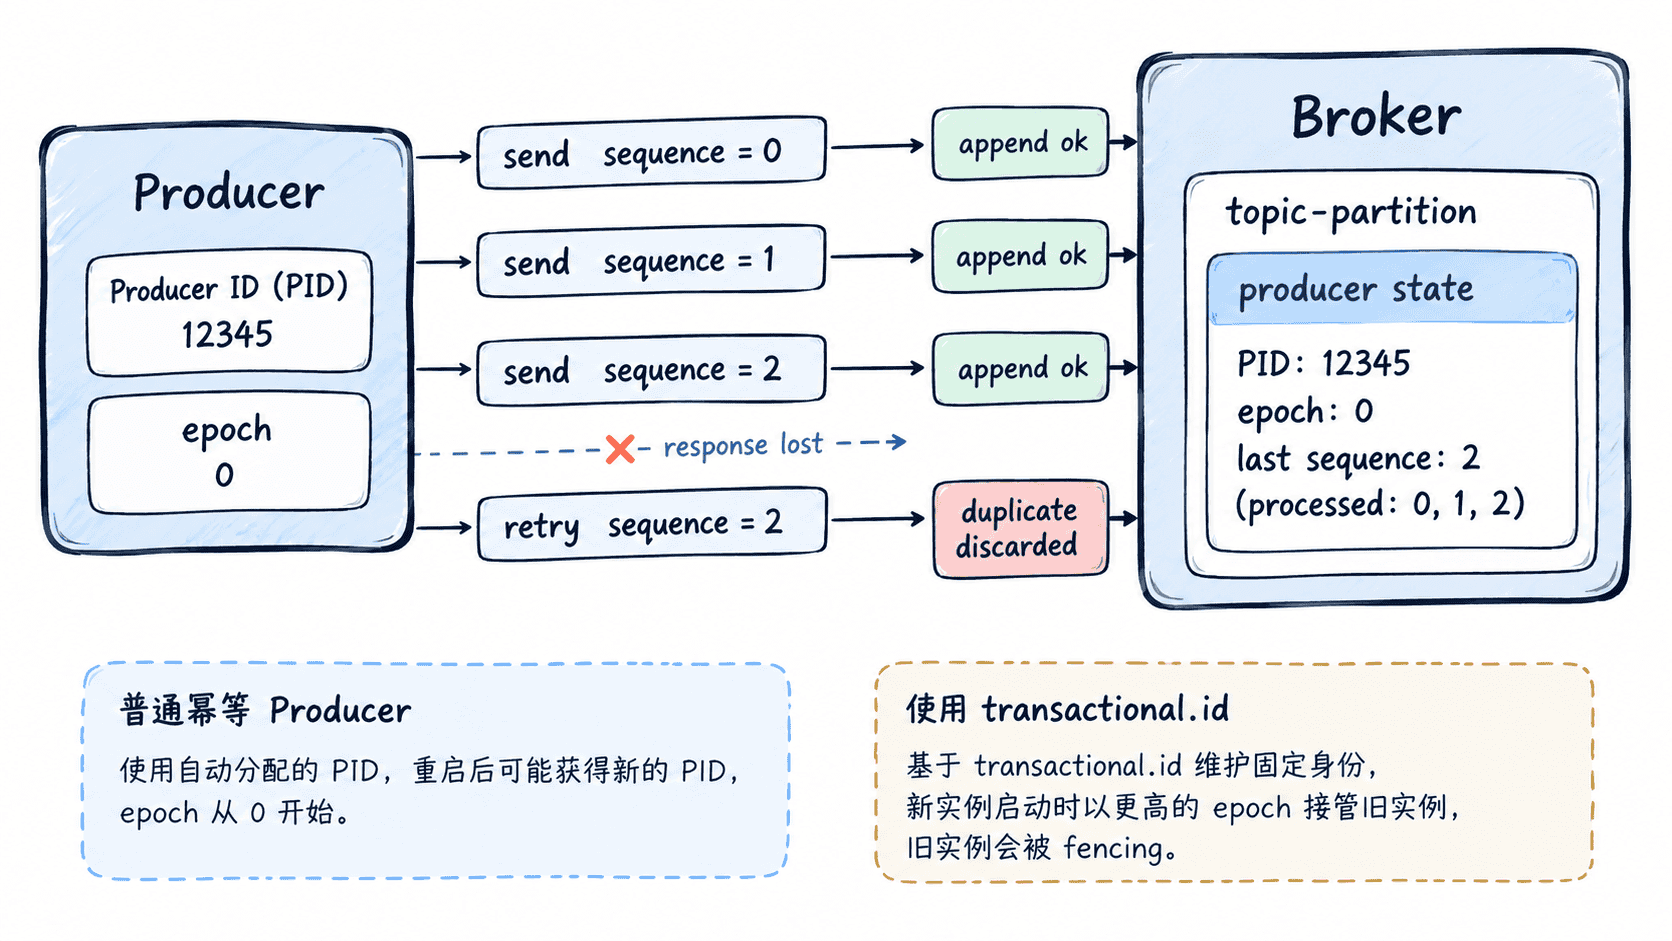
开启 enable.idempotence 后发生什么
生产者最关键的开关是 enable.idempotence=true。在支持的 Kafka Producer 配置中,启用幂等性要求相关可靠性参数满足约束,例如 acks=all、允许重试,以及 max.in.flight.requests.per.connection 不超过 5。具体参数仍应结合使用的 Kafka 客户端版本和其他配置一起验证。
bootstrap.servers=<HOST>:<PORT>
enable.idempotence=true
acks=all
retries=5
max.in.flight.requests.per.connection=5
这是配置片段示例,不包含实际集群地址。验证重点是 Producer 能以幂等模式成功初始化并完成发送;如果参数之间存在冲突,客户端应在初始化阶段拒绝不合法配置,而不是静默忽略幂等要求。
一个最小的 Java Producer
下面用 Java 展示核心配置和发送路径。代码假设项目已经加入 Kafka Clients 依赖,并且 <HOST>:<PORT> 对应可访问的 Kafka 集群。
import org.apache.kafka.clients.producer.KafkaProducer;
import org.apache.kafka.clients.producer.ProducerConfig;
import org.apache.kafka.clients.producer.ProducerRecord;
import java.util.Properties;

public class IdempotentProducerDemo {
    public static void main(String[] args) {
        Properties props = new Properties();
        props.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG, "<HOST>:<PORT>");
        props.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG,
                "org.apache.kafka.common.serialization.StringSerializer");
        props.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG,
                "org.apache.kafka.common.serialization.StringSerializer");
        props.put(ProducerConfig.ENABLE_IDEMPOTENCE_CONFIG, "true");
        props.put(ProducerConfig.ACKS_CONFIG, "all");
        props.put(ProducerConfig.RETRIES_CONFIG, "5");
        props.put(ProducerConfig.MAX_IN_FLIGHT_REQUESTS_PER_CONNECTION, "5");

        try (KafkaProducer<String, String> producer = new KafkaProducer<>(props)) {
            ProducerRecord<String, String> record =
                    new ProducerRecord<>("demo-topic", "order-1001", "created");
            producer.send(record).get();
            System.out.println("send completed");
        } catch (Exception e) {
            // 发送成功只说明 Kafka 这次写入成功,不代表整个业务链路已经 Exactly-Once。
            e.printStackTrace();
        }
    }
}
预期输出:
send completed这里的 send completed 只能说明这次发送最终获得成功结果,不能从一条 Producer 调用直接推导“整个系统已经 Exactly-Once”。幂等 Producer 解决的是 Kafka 日志写入阶段的重复发送问题。
PID、epoch 与序列号的边界
把幂等性简单说成“只覆盖单次 Producer 会话”并不准确。真正需要关注的是 Broker 如何维护 Producer 状态:PID 用来识别 Producer,sequence 用于记录某个 PID 在特定分区上的写入顺序并识别重复;epoch 则表示 Producer 身份状态中的代际信息,在事务场景下尤其用于区分同一 transactional.id 对应的新旧实例,并配合 fencing 使旧实例失效。
因此,“连接断了”“Producer 重建了”“进程重启了”都不能直接等价为“幂等状态全部清零”,也不能反过来理解成“重启后一定沿用原来的 PID 和 sequence”。身份如何重新建立取决于 Producer 生命周期以及是否使用 transactional.id 等上下文。特别是在事务场景中,同一个 transactional.id 的新实例可以接管事务身份并 fencing 旧实例;这与普通幂等 Producer 的重试去重相关,但不是同一个机制。
判断是否真正用对了
代码评审时至少检查四件事:是否明确启用幂等性;Producer 参数是否满足幂等约束;是否把业务唯一性错误地交给 Kafka Broker 处理;是否把“Kafka 日志层面避免重复写入”误称为“端到端只处理一次”。把 PID、epoch、sequence 与业务幂等分别放回各自的故障边界,才能准确理解 Producer 幂等机制。