
消息队列 / 系统课时
理解 Kafka Streams 处理模型
理解 Kafka Streams 处理模型
本课从一条输入记录进入 Kafka Streams 开始,梳理 Topology、Task、State Store 与 offset 的关系。理解这条处理链后,才能判断处理、状态更新、输出与输入进度分别发生在哪里,以及 Exactly-Once 后续究竟保护哪些边界。
学习目标
- 能说明 Topology、Task、State Store 与 offset 的职责关系
- 能区分处理任务、状态更新和输入位点推进三个动作
- 能用处理单元视角分析 Kafka Streams 的处理语义
从一条记录看处理单元
Kafka Streams 应用并不是简单地“消费一条消息、调用一次业务代码”。应用启动后会根据拓扑定义形成处理节点,并把输入 Topic 的分区分配给一个或多个 Task。Task 是实际承载输入处理、状态更新和结果输出的执行单元。
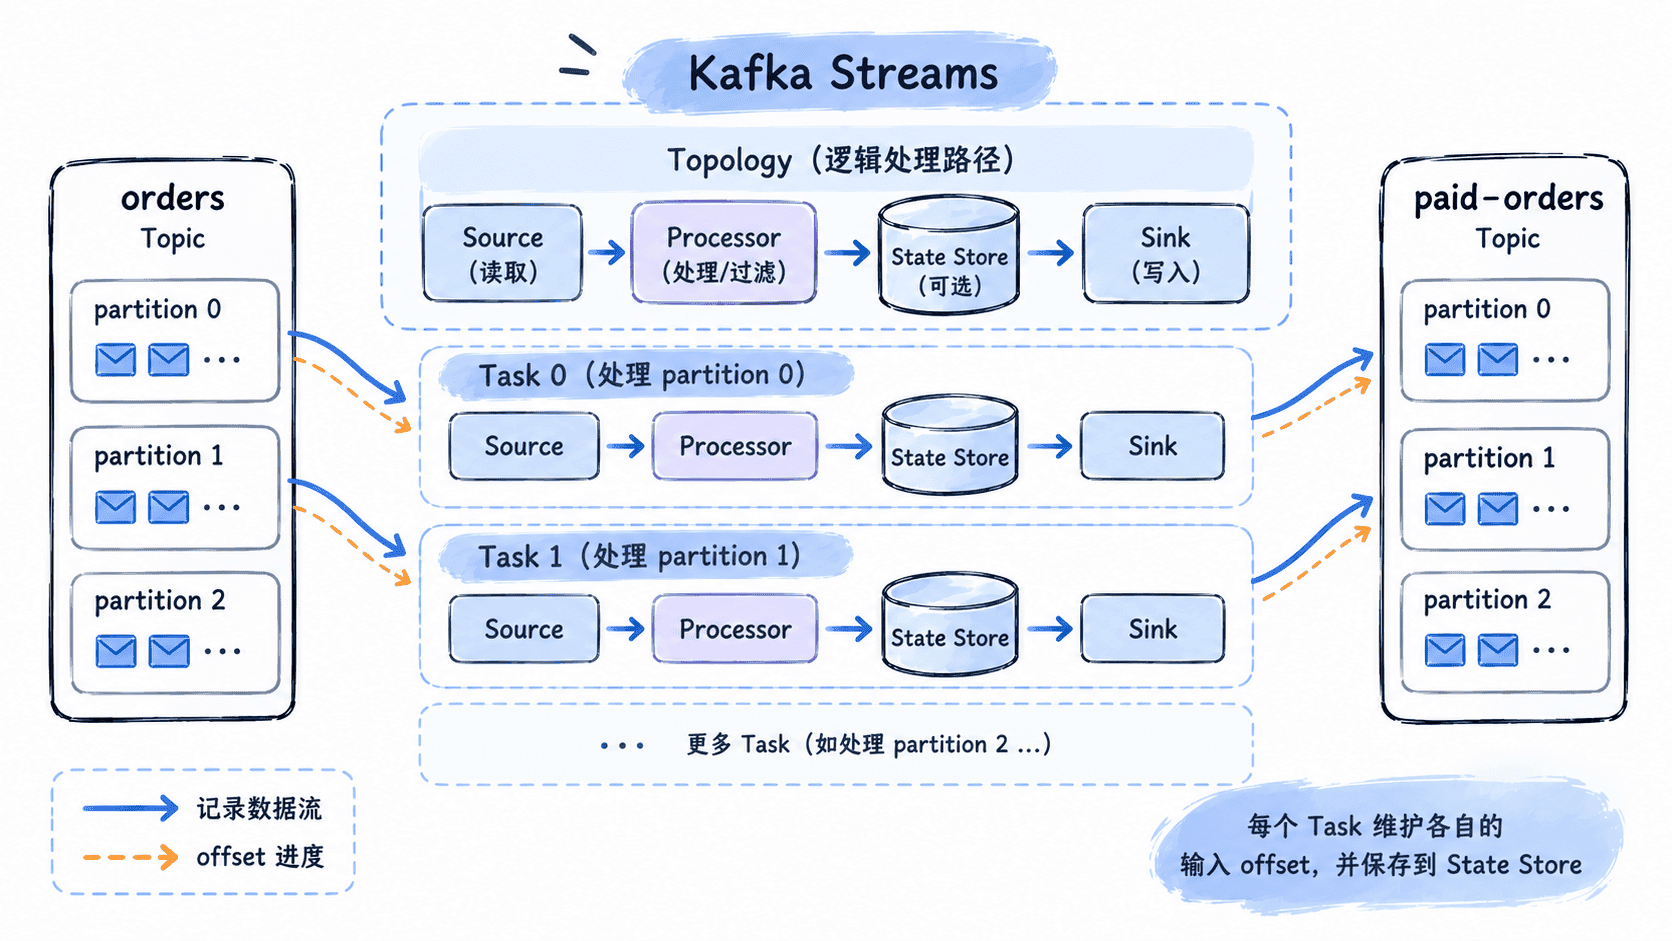
当一条记录进入 Task 后,处理逻辑可能只是转换字段,也可能读取和更新 State Store,再把结果写入下游 Topic。此时至少存在三个相互关联的进度:输入记录已经处理到哪里、状态更新到哪里、输出结果是否已经产生。
Topology 决定处理路径
Topology 描述处理节点以及节点之间的连接关系。常见节点包括 Source、Processor、Transformer、Filter、Aggregate 和 Sink。Topology 本身是逻辑结构,真正执行时由 Task 按所分配的输入分区承载这套结构。
例如下面的片段表示“读取订单 → 过滤状态 → 输出订单”这一逻辑拓扑:
import org.apache.kafka.streams.Topology;
import org.apache.kafka.streams.kstream.KStream;
import org.apache.kafka.streams.StreamsBuilder;

public class TopologyExample {
    public static void main(String[] args) {
        StreamsBuilder builder = new StreamsBuilder();

        KStream<String, String> orders = builder.stream("orders");
        orders.filter((key, value) -> value.contains("PAID"))
              .to("paid-orders");

        Topology topology = builder.build();
        System.out.println(topology.describe());
    }
}
预期结果
Topologies:
   Sub-topology: 0
    Source: KSTREAM-SOURCE-0000000000 (topics: [orders])
      --> KSTREAM-FILTER-0000000001
    Processor: KSTREAM-FILTER-0000000001 (stores: [])
      --> KSTREAM-SINK-0000000002
      <-- KSTREAM-SOURCE-0000000000
    Sink: KSTREAM-SINK-0000000002 (topic: paid-orders)
      <-- KSTREAM-FILTER-0000000001
这是 Topology.describe() 的典型输出结构,实际生成的节点编号或名称可能因拓扑组成而不同。重点是识别 Source 读取 orders、Processor 执行过滤以及 Sink 写入 paid-orders 的连接关系,而不是记住某一组自动生成的节点名称。
Task 负责真正执行
Task 可以把“逻辑拓扑”落实成“可执行上下文”。对于分区化输入,Kafka Streams 会按分区分配 Task,使不同输入分区能够被独立处理。这样做的关键价值是把并行度建立在 Kafka 分区之上,而不是让一个全局对象串行处理所有记录。
判断并行能力时不要只看应用实例数。应用实例、线程、Task 与 Topic 分区是不同层次的概念:分区决定输入并行度的上限,Task 是实际处理单元,而线程负责执行分配到它的任务。
State Store 与 offset 是两条不同进度线
State Store 保存聚合、计数、去重等有状态处理所需的数据。它描述的是“业务处理到什么状态”,而 offset 描述的是“输入日志读到什么位置”。两者不能简单视为同一个进度指标。
例如处理第 100 条记录时,代码可能已经计算出新的计数,但如果对应的输入进度尚未安全确认,应用发生故障后就可能再次处理这条记录。因此,讨论处理语义时必须同时观察状态更新、输出写入和 offset 管理,而不能只看消费位点。
为什么这套模型与 EOS 有关
Exactly-Once 的关键不是让代码“只执行一次”,而是让一次处理链中的输入消费、状态变更和输出结果具备协调后的提交语义。理解 Task 如何承载处理、State Store 如何保存中间状态、offset 如何代表输入进度,是理解后续事务处理的基础。
当排查重复结果、状态与输出不一致等问题时,优先问清楚三个事实:记录属于哪个 Task、状态是否参与处理、输入 offset 与输出结果是否在同一提交边界内。这样才能从“感觉像重复消费”进一步定位到具体处理阶段。
把 Kafka Streams 看成“Topology 定义路径、Task 执行处理、State Store 保存状态、offset 描述输入进度”的组合,而不是单纯的 Kafka Consumer 封装,就能更准确地理解它如何建立端到端处理语义。