
消息队列 / 系统课时
看懂 Kafka 的 Exactly-Once 边界
看懂 Kafka 的 Exactly-Once 边界
本课解决“Kafka 开了事务,是不是整个业务链路都 exactly-once”这个常见误区。核心结论是:Kafka 事务可以把 Kafka 内部的写入与消费位点提交纳入同一套事务语义,但外部数据库等系统通常仍在边界之外。
学习目标
- 能画出 Kafka 事务真正覆盖的资源边界
- 能解释 Kafka 内部 exactly-once 与外部数据库写入之间的差异
- 能识别“Kafka 开事务就全链路 exactly-once”的错误设计
Kafka 事务覆盖到哪里
Kafka 的事务语义主要围绕 Kafka 自身的消息写入与消费位点管理展开。典型的读-处理-写场景中,消费者读取输入消息后,把处理结果写入 Kafka,并将相应消费位点作为事务的一部分提交;成功时一起提交,失败时整体放弃。
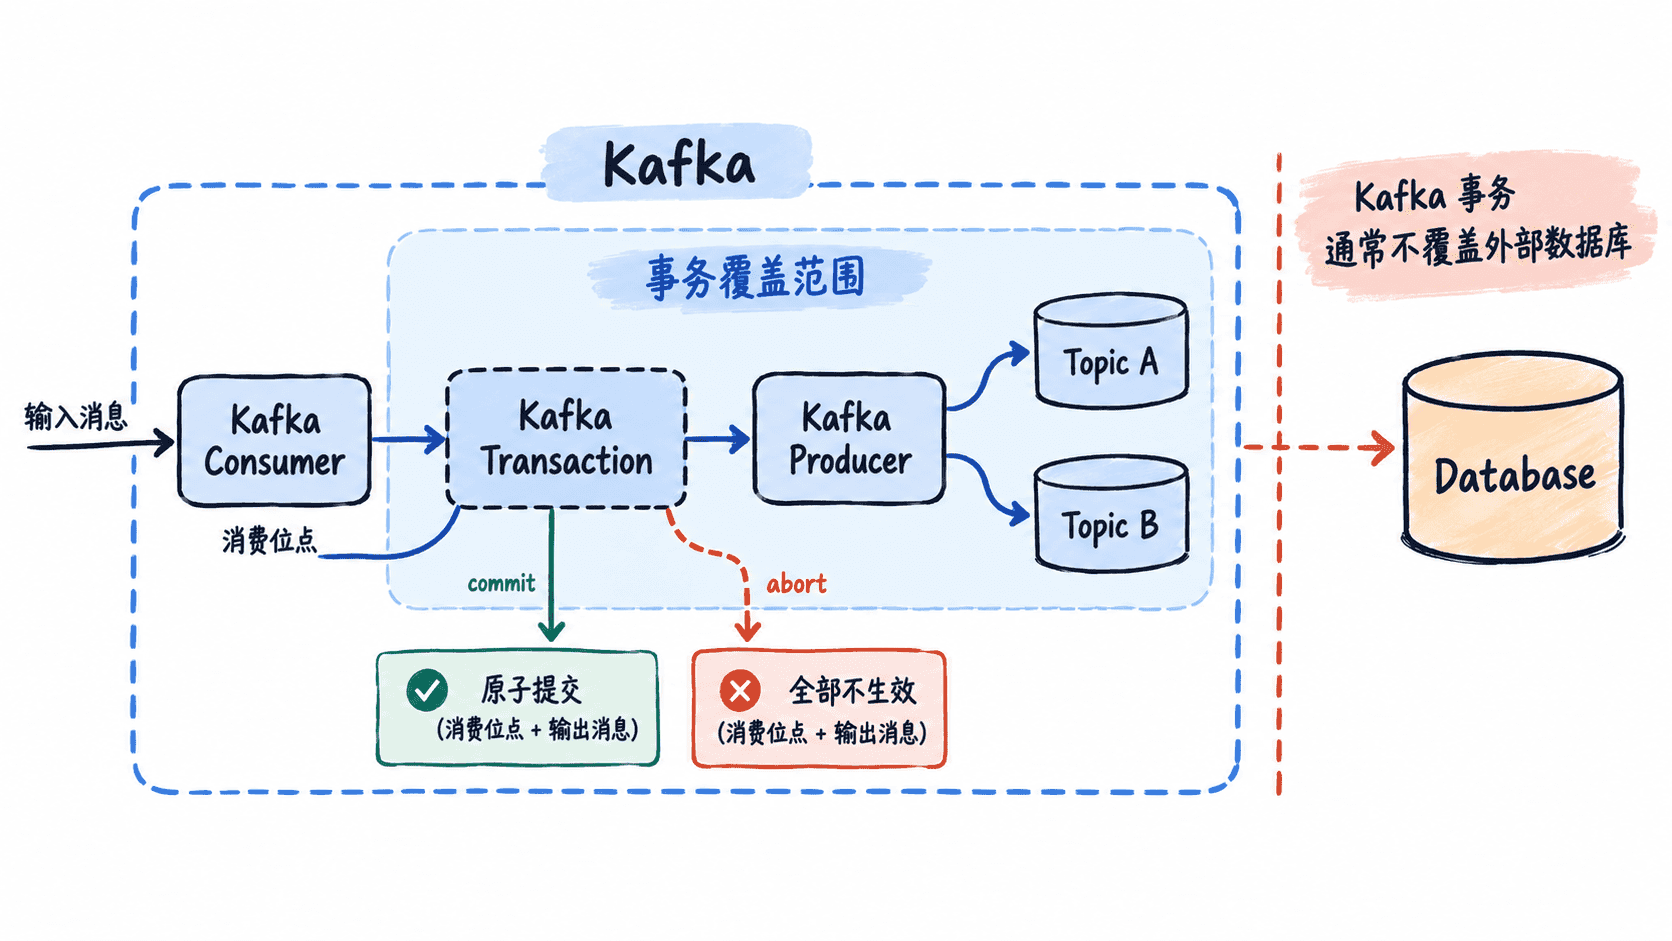
例如,一个流式处理任务从 Topic A 读取订单事件,计算后写入 Topic B。若处理结果和消费位点在同一 Kafka 事务中提交,那么消费者重启后不会简单地因为重复读取而让 Topic B 无限产生等价重复结果。这正是 Kafka 事务能够帮助解决的核心问题之一。
外部数据库为什么是边界
考虑另一种流程:消费者从 Kafka 读取消息,先更新 MySQL,再提交 Kafka 消费位点。此时至少存在两个独立资源:Kafka 与 MySQL。即使 Kafka 自己具备事务能力,也不能自动把 MySQL 的本地事务提交一起纳入 Kafka 的原子提交。
例如下面只是一个片段示例,用于说明边界关系;它依赖已经配置好的 Kafka Producer 与数据库事务环境,并不是可直接运行的完整程序。
@Transactional
public void handleOrder(String orderId) {
    orderRepository.updateStatus(orderId, "PAID");
    kafkaTemplate.send("order-result", orderId, "PAID");
}
预期结果
数据库本地事务和 Kafka 发送分别受各自资源的提交机制控制;不能仅凭 @Transactional 就断言二者原子提交。这里最关键的不是注解,而是事务管理器能够管理哪些资源。Spring 的本地数据库事务可以控制数据库连接,但这并不等价于 Kafka 与数据库被放进同一个分布式原子事务。
一个失败点就可能出现不一致
假设数据库更新成功,而 Kafka 输出没有成功提交,那么数据库已经发生状态变化,消息侧却可能缺失。反过来,消息已经成功发送,而数据库事务随后回滚,也会形成另一种不一致。
这意味着设计 exactly-once 时,不能只问“Kafka 是否开启事务”,还要问“业务最终结果落在哪个系统”。如果最终业务状态保存在数据库,那么数据库本身的写入一致性、消息发送可靠性以及二者之间的协调方案,都属于整体正确性的一部分。
设计时怎样划定边界
对于纯 Kafka 的消费、处理、再生产链路,可以重点利用 Kafka 事务把输入消费位点与输出消息纳入同一提交边界。对于 Kafka 加数据库的场景,则应把“Kafka 内 exactly-once”和“跨系统业务一致性”分开讨论。
常见做法包括 Outbox、幂等写入、状态表配合重试等,它们不是把 Kafka 的事务边界强行扩大,而是重新设计跨系统的一致性边界。选择哪种方案,应由业务允许的延迟、一致性要求以及故障恢复方式决定。
因此,判断 Kafka Exactly-Once 是否成立,第一件事永远是先画出资源边界:哪些操作由同一个 Kafka 事务控制,哪些操作属于外部系统,以及跨边界后由什么机制承担一致性责任。