
消息队列 / 系统课时
设计并发与实例扩缩
设计并发与实例扩缩
Kafka 的事务并发设计,真正容易出错的不是“实例多了”,而是同一个 transactional.id 被多个活跃 Producer 同时使用,或者任务迁移、实例重启后生成了不稳定的事务身份。本文把消费者组、分区、逻辑处理任务和运行实例放到同一套规则中,建立可扩缩且可恢复的实例分配方案。
学习目标
- 判断消费者组扩缩容后,实例并发量与分区数的关系。
- 区分逻辑处理任务身份与运行实例身份,并据此设计稳定的
transactional.id。 - 识别共享 ID、随机 ID 与过度并发导致的事务恢复风险。
先看四个对象如何配合
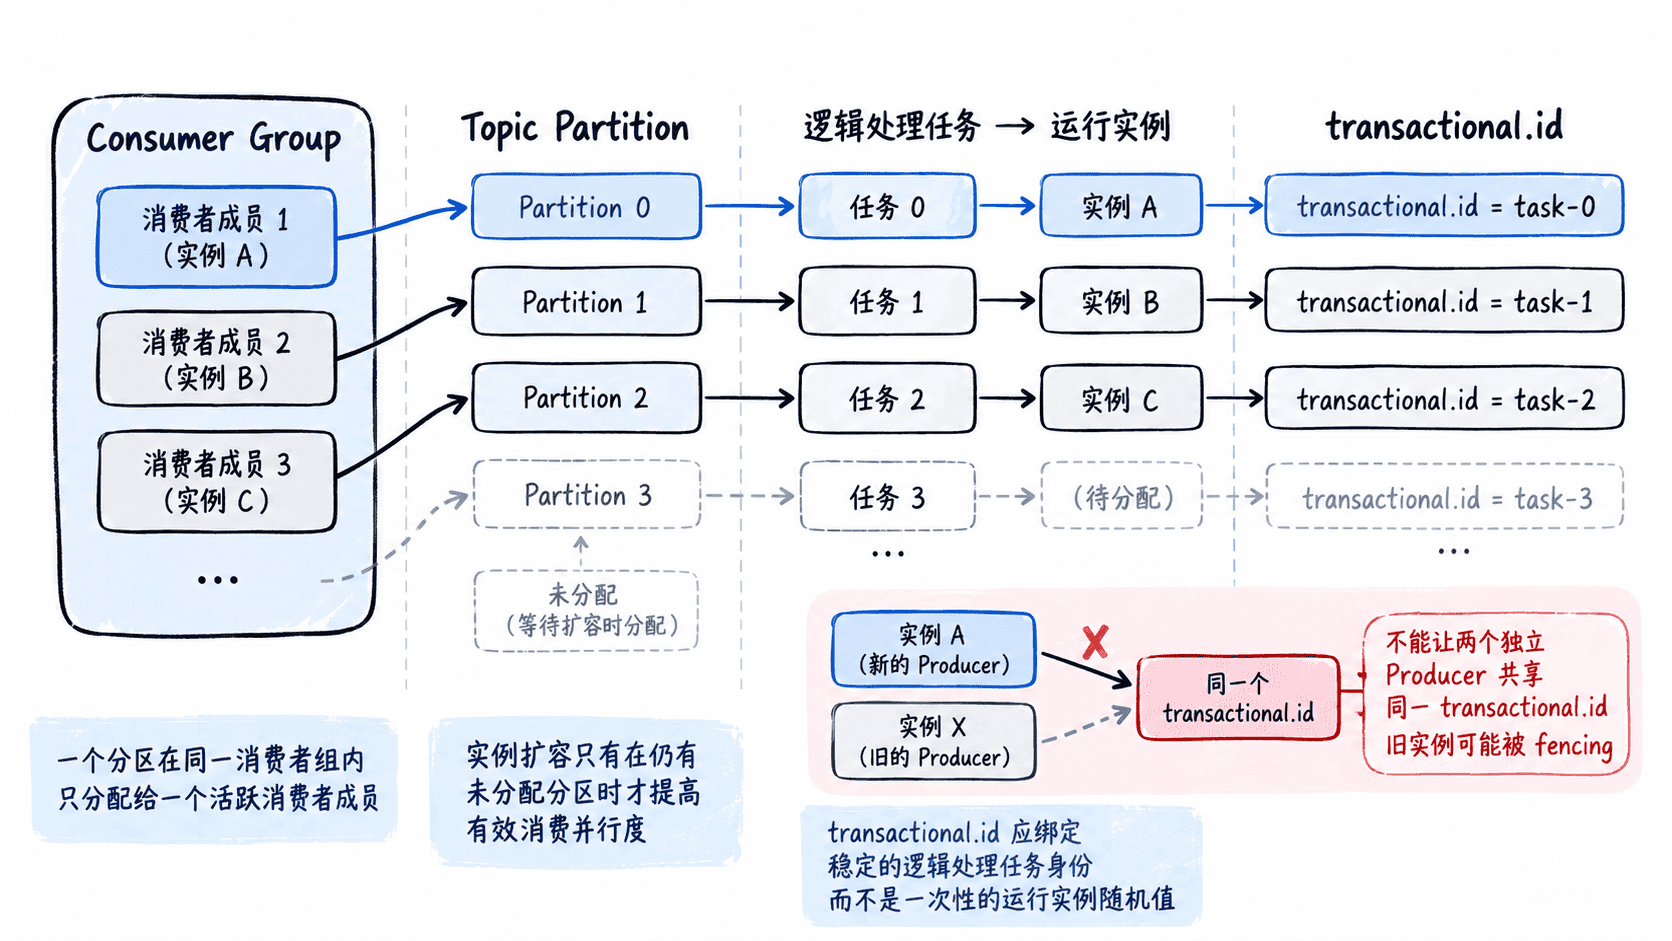
消费者组通过分区分配并发任务:一个分区在同一消费者组内同一时刻只会分给一个消费者成员。实例增加后,只有在仍有未分配分区时,并发处理能力才会继续提升;实例超过可并行处理的分区数,并不会凭空创造更多 Kafka 消费并发。
事务 Producer 则多一层约束:同一时刻不能让两个独立的活跃 Producer 共用同一个 transactional.id。当新的 Producer 使用同一个 ID 初始化并获得新的事务身份后,旧 Producer 可能被 fencing。这个机制用于阻止两个进程同时代表同一事务身份继续写入。
用稳定规则分配事务身份
最稳妥的原则不是“每台机器一个 ID”,而是“每个需要独立维护事务状态的逻辑处理任务拥有一个稳定且唯一的 transactional.id”。这里必须区分两个概念:逻辑任务身份表示“谁负责这份业务处理工作”,运行实例身份只表示“当前由哪一个进程承载它”。任务从实例 A 迁移到实例 B 时,逻辑任务身份应保持不变,运行实例身份可以变化;这样新实例才能继续使用同一个 transactional.id,同时让旧持有者失效。
因此,transactional.id 应由稳定的逻辑任务标识派生,例如 orders-eos-task-17,而不应把一次性的 instanceId 直接拼进去作为长期事务身份。实例 ID 可以进入日志和监控,用于追踪当前持有者,但不应改变事务身份。实际项目中,逻辑任务编号应来自稳定的任务分配规则,并保证同一时刻一个逻辑任务只有一个活跃持有者。
下面的 Java 片段展示这种确定性分配方法:taskId 是稳定的逻辑任务身份,instanceId 仅用于标识当前运行实例,不参与 transactional.id 生成。
import java.util.Objects;

public final class TransactionalIdAllocator {
    private TransactionalIdAllocator() {
    }

    public static String buildTransactionalId(String taskId) {
        Objects.requireNonNull(taskId, "taskId");
        if (taskId.isBlank()) {
            throw new IllegalArgumentException("taskId must not be blank");
        }

        // transactional.id 绑定逻辑任务,而不是一次性的运行实例。
        return "orders-eos-task-" + taskId;
    }

    public static void main(String[] args) {
        String taskId = "17";
        String instanceA = "instance-a";
        String instanceB = "instance-b";

        System.out.println(buildTransactionalId(taskId));
        System.out.println(instanceA + " -> " + buildTransactionalId(taskId));
        System.out.println(instanceB + " -> " + buildTransactionalId(taskId));
    }
}
预期输出:
orders-eos-task-17
instance-a -> orders-eos-task-17
instance-b -> orders-eos-task-17
这个结果体现了关键设计:任务迁移前后,事务身份不变;变化的是当前运行实例。示例只展示身份生成,不包含消费者组 rebalance、任务接管和 Producer 生命周期管理。真正部署时,还需要保证同一个逻辑任务不会被两个活跃进程同时持有,否则 Kafka 可能通过 fencing 阻止旧持有者继续操作。
扩容时先看分区,再看实例
假设 Topic 有 12 个分区,当前有 3 个实例,每个实例最多并发处理 4 个逻辑任务。把实例从 3 扩到 6,并不会让一个分区同时被两个实例处理;它首先触发消费者组 rebalance,然后把原有分区重新分配给更多成员。
因此,扩容规划至少同时看三个数量:Topic 分区数、消费者组活跃成员数、每个实例可承载的逻辑任务数。有效消费并行度首先受分区数约束;事务 Producer 的并发数量则取决于实际活跃逻辑任务数量,并且每个逻辑任务必须对应唯一的 transactional.id。
当实例数超过分区数时,会出现空闲消费者成员;当单实例并发槽位高于实际分区分配时,也应避免提前创建大量没有实际任务绑定的事务 Producer。事务身份不是越多越好,因为每个身份都带来对应的事务状态与恢复管理开销。
哪些扩缩方式最危险
最常见的问题是把 transactional.id 写成固定字符串,例如所有实例都使用 orders-eos。扩容后第二个实例启动 Producer,会与第一个实例争用同一事务身份,旧实例可能被 fencing。
另一个问题是每次启动都使用随机 UUID。它可以降低并发冲突,但也会让同一个逻辑任务在重启或迁移后获得全新的事务身份,失去任务与事务身份之间的稳定映射。因此,随机值可以用于运行实例标识,却不应直接作为逻辑任务的长期 transactional.id。
还有一种误区是只增加消费者线程数,却没有增加 Topic 分区数。这样应用层线程可能变多,但 Kafka 端真正能并行分配的分区数没有变化,额外线程只会带来上下文切换与管理复杂度。
扩缩容前后的验证
扩容前记录消费者组当前成员与分区分配,扩容后再次检查,确认新实例确实接到了预期分区,同时结合应用日志核对每个逻辑任务当前只由一个实例持有,且没有两个活跃 Producer 使用同一事务身份。
kafka-consumer-groups.sh \
  --bootstrap-server <HOST>:<PORT> \
  --group <GROUP_ID> \
  --describe
预期结果:
GROUP       TOPIC       PARTITION  CURRENT-OFFSET  LOG-END-OFFSET  LAG  CONSUMER-ID
<GROUP_ID>  <TOPIC>     0          <VALUE>         <VALUE>         0    <CONSUMER_ID>
<GROUP_ID>  <TOPIC>     1          <VALUE>         <VALUE>         0    <CONSUMER_ID>
重点不是某个固定 CONSUMER-ID,而是分区分配是否符合预期、是否存在异常空闲成员,以及扩缩容后 Lag 是否在业务可接受范围内。实际 offset、consumer ID 和成员数量会随运行状态变化。
最终可以把扩缩容原则压缩成一句话:**用分区决定可扩展的消费并行度,用稳定的逻辑任务身份决定 Producer 事务身份,再用实例持有关系控制当前活跃持有者。**这样实例重启、rebalance 和水平扩容才能同时满足吞吐与事务恢复要求。