
消息队列 / 系统课时
演练进程崩溃与恢复
演练进程崩溃与恢复
本课用一次“事务提交前崩溃、相同 transactional.id 重启”的实验,验证 Kafka 如何接管未完成事务,以及恢复后的新事务如何被 read_committed 消费者正确看到,形成可重复的故障恢复闭环。
学习目标
- 能在事务提交前制造可重复的进程崩溃,并定位崩溃时机。
- 能理解相同 transactional.id 的新 Producer 如何通过 initTransactions() 接管未完成事务。
- 能使用 read_committed 验证中止事务不可见、恢复后已提交事务可见。
演练场景与观察点
实验只围绕生产者事务恢复展开:第一次进程固定使用同一个 transactional.id,在发送记录后、commitTransaction() 前直接退出;第二次进程仍使用该 transactional.id,调用 initTransactions() 完成事务身份初始化,再提交一笔新事务。
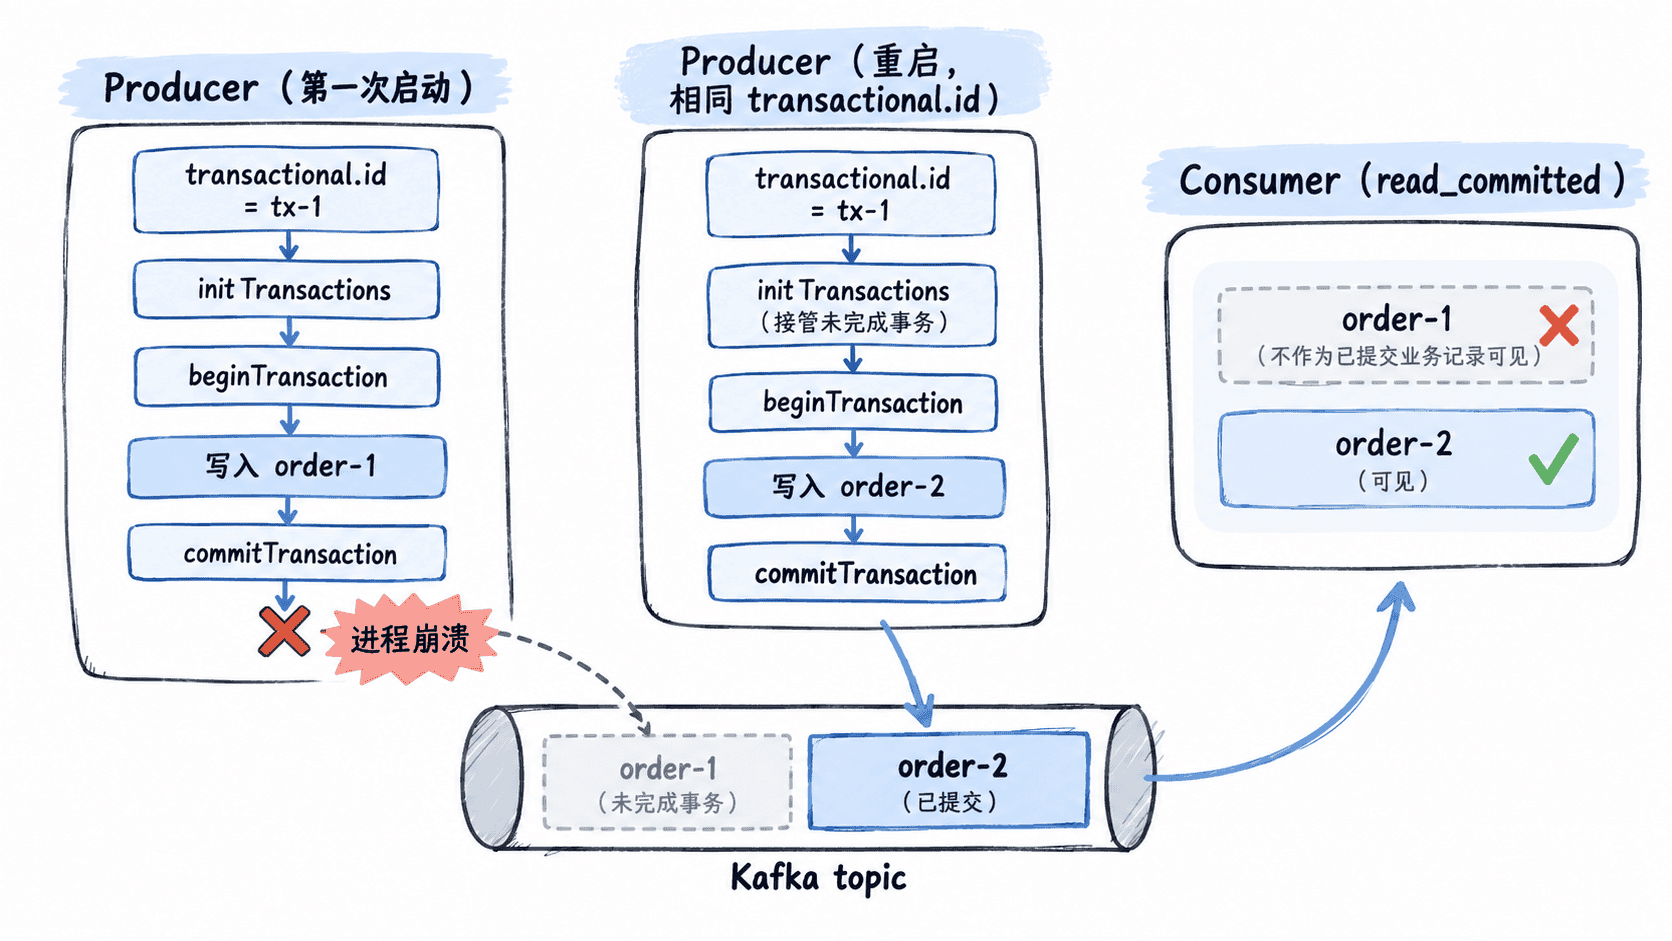
真正需要观察的是“崩溃发生在哪里”。如果进程在 beginTransaction() 之后、commitTransaction() 之前退出,这一轮事务不会成为已提交结果。重新启动时,新的 KafkaProducer 对象不会延续旧 Java 对象的执行现场,而是依靠相同 transactional.id 调用 initTransactions(),让 Kafka 完成该事务身份的重新初始化,并处理此前未完成的事务状态。
注入进程崩溃
下面用一个程序覆盖两个模式,避免把“崩溃”和“恢复”拆成两个容易漂移的示例。第一次运行 crash:发送 order-1 后直接结束进程,不调用 commitTransaction();第二次运行 recover:仍使用相同的 transactional.id,初始化后开始新事务并提交 order-2。示例依赖 kafka-clients,<BOOTSTRAP_SERVERS> 与 Topic 名称按实验环境替换。
import org.apache.kafka.clients.producer.KafkaProducer;
import org.apache.kafka.clients.producer.ProducerConfig;
import org.apache.kafka.clients.producer.ProducerRecord;

import java.util.Properties;

public class CrashProducer {
    private static final String TRANSACTIONAL_ID = "eos-crash-demo";
    private static final String TOPIC = "eos-demo";

    public static void main(String[] args) throws Exception {
        if (args.length != 1 || (!"crash".equals(args[0]) && !"recover".equals(args[0]))) {
            throw new IllegalArgumentException("usage: CrashProducer <crash|recover>");
        }

        Properties props = new Properties();
        props.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG, "<BOOTSTRAP_SERVERS>");
        props.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG,
                "org.apache.kafka.common.serialization.StringSerializer");
        props.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG,
                "org.apache.kafka.common.serialization.StringSerializer");
        props.put(ProducerConfig.TRANSACTIONAL_ID_CONFIG, TRANSACTIONAL_ID);

        try (KafkaProducer<String, String> producer = new KafkaProducer<>(props)) {
            // 相同 transactional.id 是恢复此前事务状态的关键身份。
            producer.initTransactions();
            producer.beginTransaction();

            if ("crash".equals(args[0])) {
                producer.send(new ProducerRecord<>(TOPIC, "order-1", "created")).get();
                producer.flush();
                System.out.println("record-sent-before-crash");
                Runtime.getRuntime().halt(137);
            }

            producer.send(new ProducerRecord<>(TOPIC, "order-2", "committed")).get();
            producer.commitTransaction();
            System.out.println("recovery-transaction-committed");
        }
    }
}
预期输出:第一次运行 crash 时完成发送后立即退出;第二次运行 recover 时完成新的事务提交。
record-sent-before-crash
recovery-transaction-committed
第一次输出只证明发送请求完成,不能证明事务已经提交。恢复的关键点是第二次启动时的 initTransactions():它使用相同 transactional.id 建立新的事务会话,并使此前未完成事务进入 Kafka 定义的终止处理路径,随后新事务才能正常提交。
重启并验证结果
先执行 crash,再执行 recover。两次运行必须使用相同的 transactional.id;如果改成新的身份,就不再是本实验要验证的“同一事务身份重新初始化”场景。
java CrashProducer crash
java CrashProducer recover

kafka-console-consumer.sh --bootstrap-server <BOOTSTRAP_SERVERS> --topic eos-demo --from-beginning --isolation-level read_committed --consumer.config <PATH>
预期结果
record-sent-before-crash
recovery-transaction-committed
order-2	committed
其中 order-1 不应作为已提交业务记录出现在 read_committed 消费结果中,而第二次事务提交的 order-2 应最终可见。实际消费输出可能包含 Topic 中已有数据,因此验收时重点检查这两条实验记录,而不是机械比较总行数。
区分事务恢复与消费组重平衡
这次实验实际验证的是生产者事务恢复,不应把它误解为消费组重平衡实验。生产者进程崩溃后,新 Producer 通过相同 transactional.id 和 initTransactions() 恢复事务身份;而消费组成员离开导致的重平衡,解决的是分区归属重新分配,两者属于不同机制。
因此排查时,先确认新 Producer 使用的 transactional.id 与旧实例一致,再确认 initTransactions() 成功返回,随后验证新事务能够提交;消费者侧再确认 isolation.level=read_committed。仅看到消费组发生重平衡,不能单独证明生产者事务已经恢复。
一次合格的故障演练至少应完成“提交前崩溃 → 相同 transactional.id 重启 → initTransactions() → 新事务提交 → read_committed 验证”这一闭环。若仍能在 read_committed 中读到 order-1,应优先检查实际崩溃是否确实发生在 commitTransaction() 之前、消费者隔离级别是否正确,以及 Topic 中是否混入了同名实验数据。