
消息队列 / 系统课时
建立 EOS 观测指标
建立 EOS 观测指标
这节课解决“业务说出现重复、延迟或吞吐下降时,到底该看什么”的问题。你会把事务、消费、重试和再均衡拆成可观测信号,并建立口径明确、可切分、能直接用于告警和排障的指标体系。
学习目标
- 能为 Kafka EOS 链路定义成功率、耗时、abort、retry、consumer lag 和 rebalance 指标
- 能为计数器明确事件口径和分母,避免成功率在不同实现间失真
- 能根据指标组合判断事务失败、处理变慢、积压或再均衡的主要方向
指标设计的核心
EOS 观测不能只看“事务成功了多少次”。真正有价值的是把一次处理链路拆成几个阶段:消费是否持续推进、事务是否提交、事务是否被 abort、应用是否频繁 retry,以及消费者是否发生 rebalance。这样才能把“业务重复”与“系统性能下降”区分开。
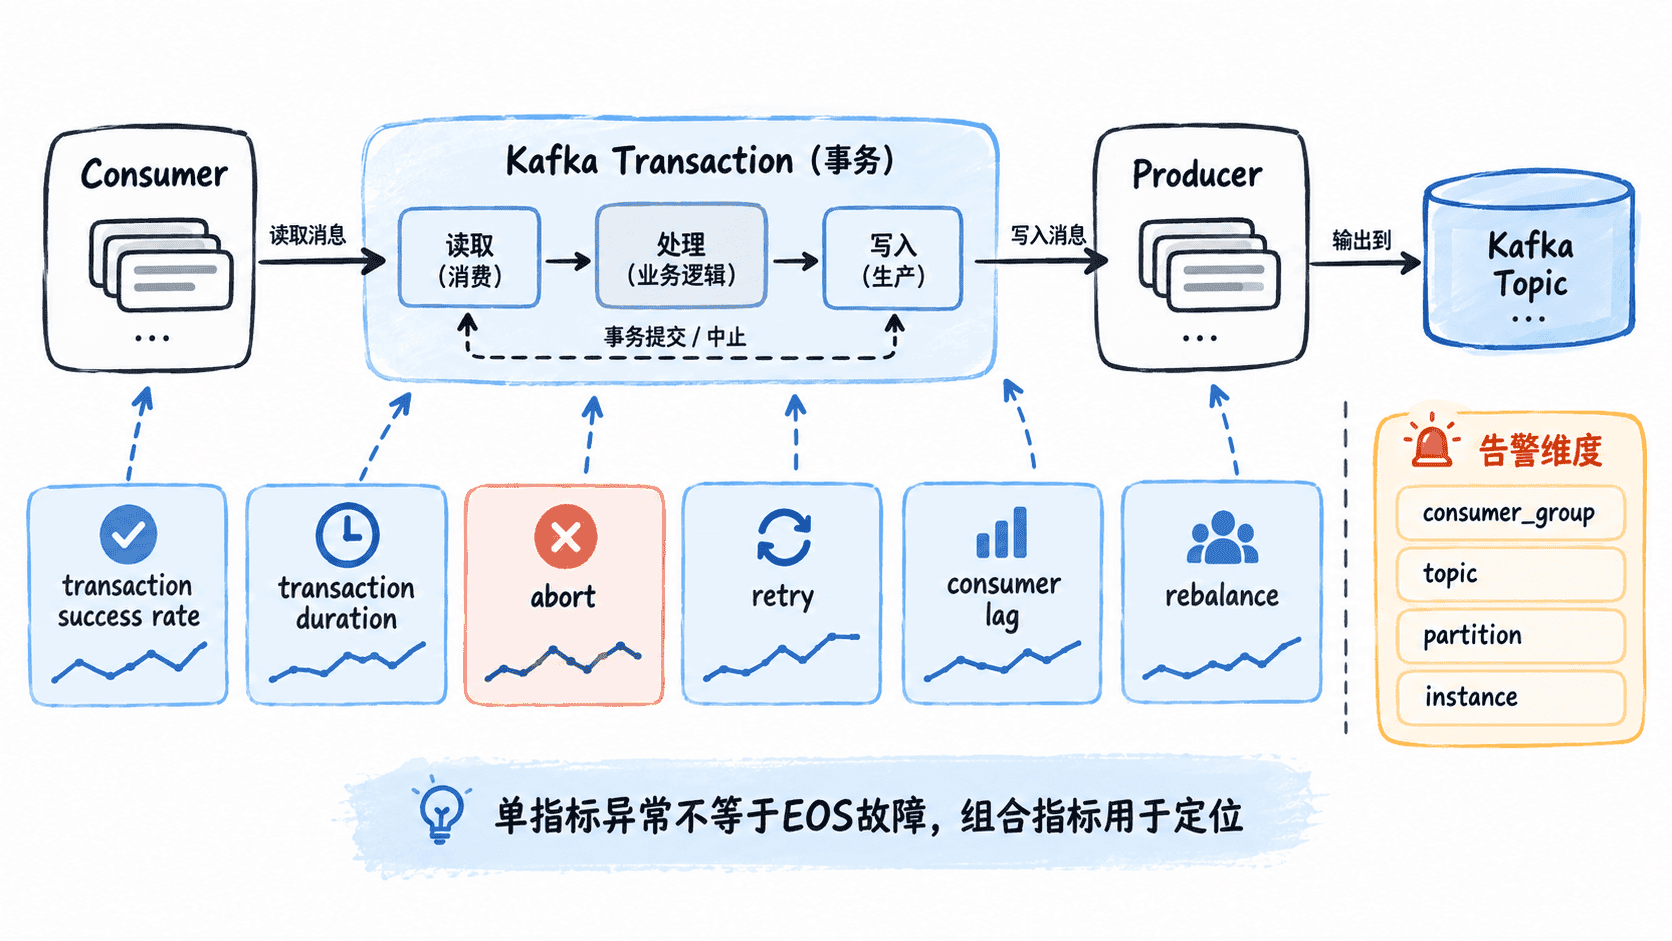
用成功率和耗时判断事务健康度
事务成功率回答“尝试过的事务中,有多少最终提交”,事务耗时回答“完成一次事务是否越来越慢”。建议至少记录 transaction_started、transaction_committed、transaction_aborted 和 transaction_duration,并明确这些事件分别在什么时刻计数。
成功率不能机械地固定写成 committed/started,而应先定义分母。一个稳定的口径可以是:transaction_started 只统计“进入正式事务处理并成功调用 beginTransaction 的一次事务尝试”。这样,主动 abort、超时 abort 和事务执行异常都继续留在分母中;初始化失败、尚未进入事务的请求不计入该分母。发生重试时,每一次真正重新开始事务的尝试分别计数,并通过业务操作 ID 或独立的 retry 指标关联起来,避免把“最终成功”覆盖掉前一次失败尝试。
因此,在这一口径下,成功率可表示为:
例如一次业务操作第一次事务主动 abort,随后重试并提交成功,且两次都真正调用了 beginTransaction,那么 started=2、aborted=1、committed=1,成功率为 50%。这表示“事务尝试”的结果,而不是把最终重试成功误认为第一次就成功。
public class EosMetricExample {
    public static void main(String[] args) {
        long started = 2;    // 两次都真正进入事务处理
        long committed = 1;  // 第二次提交成功
        long aborted = 1;    // 第一次主动中止

        double successRate = started == 0 ? 0.0 : (double) committed / started;
        double abortRate = started == 0 ? 0.0 : (double) aborted / started;

        System.out.printf("started=%d committed=%d aborted=%d successRate=%.2f abortRate=%.2f%n",
                started, committed, aborted, successRate, abortRate);
    }
}
预期输出
started=2 committed=1 aborted=1 successRate=0.50 abortRate=0.50生产环境不要只盯绝对值。更实用的是观察同一消费者组的时间序列,例如成功率突然下降,同时 p95 事务耗时上升,通常比单独一个指标更能说明处理链路出现压力。
Abort 与 Retry 要分开看
abort 表示事务没有以 commit 结束,但它不必然意味着系统故障。某些设计会主动 abort 后重试;真正值得关注的是 abort rate 与 retry rate 是否持续升高,并且事务耗时是否同步拉长。排障时还要区分“业务逻辑主动放弃”和“超时、网络、Producer 错误等被动失败”。
建议把原因作为低基数分类,例如 exception、timeout、producer_error、rebalance,而不要把订单号、消息内容等高基数字段直接作为 label。否则指标本身可能先把监控系统打爆。
Consumer Lag 与 Rebalance 负责解释“为什么变慢”
consumer lag 用来判断输入是否持续追不上生产速度;rebalance 用来解释消费者处理能力突然下降或分区分配发生变化。排查时应把两者与事务耗时放在同一时间窗口,避免把暂时的输入突增误判成事务异常。
| 现象 | 优先观察 | 典型判断 |
|---|---|---|
| lag 上升、事务耗时稳定 | consumer lag、处理吞吐 | 消费能力不足或输入突增 |
| lag 上升、事务耗时上升 | transaction duration | 单次处理变慢 |
| abort 与 retry 同时升高 | abort、retry、错误分类 | 事务执行不稳定 |
| rebalance 频繁、lag 跟着上升 | rebalance、lag | 消费组频繁重分配影响处理 |
| 成功率正常但业务仍报重复 | 提交结果、下游边界 | 需要继续检查 EOS 资源边界,而非只看成功率 |
告警维度要能直接指向故障范围
建议优先保留 consumer_group、topic、partition、instance 等有限集合。告警既要告诉你“哪里异常”,又不能制造海量时间序列。
例如可以建立三层告警:先以 consumer group 发现整体 lag 或 rebalance,再下钻到 topic/partition 定位热点,最后结合 instance 和事务错误分类判断具体处理节点。这样一条告警就能自然进入排障路径。
最后,EOS 监控的目标不是堆满指标,而是让一次异常能够回答三个问题:是否提交成功、处理为什么变慢、异常集中发生在哪里。只要成功率、事务耗时、abort/retry、lag 和 rebalance 能按统一事件口径放在同一时间轴上,重复与延迟问题就不再只能靠业务日志猜测。