
消息队列 / 系统课时
拆解消费与生产的原子关系
拆解消费与生产的原子关系
这节解决一个看似简单却决定 EOS 是否成立的问题:消费者处理完输入后,输出记录与消费进度怎样保持一致,才能避免“结果已写、offset 未提交”或“offset 已提交、结果没写”的失配。
学习目标
- 能解释消费 offset 与输出记录为什么必须协调。
- 能区分普通手动提交、重复处理与 Kafka 事务的原子关系。
- 能判断 Kafka-to-Kafka 场景下 EOS 的成立条件。
先看失配从哪里产生
消费者通常经历“读取输入 → 处理 → 写出结果 → 保存消费进度”。只要输出和 offset 不是一个不可分割的提交单元,进程就可能在中间步骤崩溃,于是恢复后的行为会出现分叉。
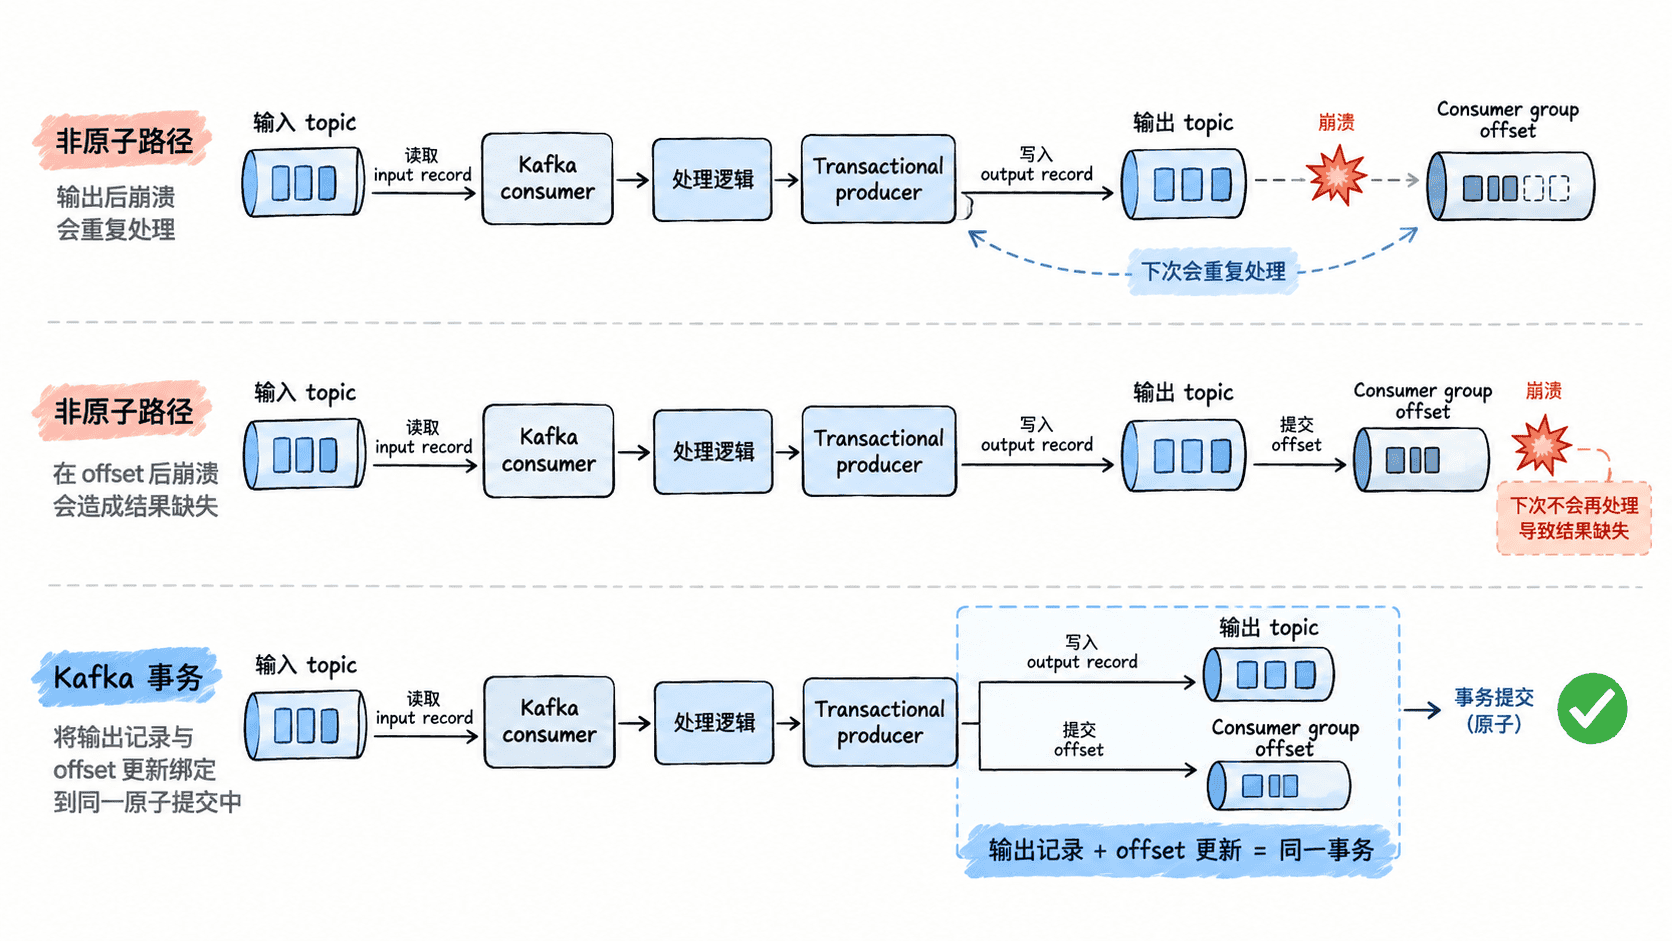
普通消费为什么会重复
假设处理输入偏移量为 42 的记录,业务已经成功写出结果,但消费者在提交 offset 前崩溃。恢复后仍可能从 42 重新读取,于是同一输入再次执行。这是典型的至少一次处理行为,而不是处理逻辑本身失效。:contentReference[oaicite:0]{index=0}
反过来,如果先提交 offset 再写结果,提交成功后进程崩溃,恢复时会从下一个位置继续,导致这条输入对应的输出可能永远没有产生。因此,“先提交”与“后提交”只能分别偏向避免重复或避免丢失,却无法单独形成原子处理。
Kafka 事务解决什么
Kafka 的关键设计不是让 consumer 本身变成事务对象,而是让 transactional producer 在同一事务中写入输出记录,并原子更新代表消费进度的 offset。事务提交成功,两者一起生效;事务中止,则输出和该次 offset 更新都不会作为已提交结果留下。:contentReference[oaicite:1]{index=1}
因此,Kafka-to-Kafka 的核心关系可以概括为:输入 offset 表示处理进度,输出记录表示处理结果,两者必须由同一个事务提交来建立一致的边界。 下游消费者还需要使用 read_committed 才能只看到已提交事务产生的记录;read_uncommitted 仍可能读到已中止事务的记录。:contentReference[oaicite:2]{index=2}
不要把三个概念混在一起
幂等生产主要解决生产者重试造成的重复写入问题;事务解决多个输出写入以及消费进度更新的原子性;Exactly-Once Processing则是在明确处理边界和读取隔离条件下,把“处理一次”的业务语义落到输入、输出和进度之间的协调上。Kafka 官方也明确区分了发布可靠性与消费处理语义。:contentReference[oaicite:3]{index=3}
如果输出目标不是 Kafka,而是外部数据库、HTTP 服务或其他存储,仅靠 Kafka 事务并不能自动把外部副作用一起纳入原子提交。此时必须进一步采用目标系统支持的幂等、事务协调或“结果与 offset 共存储”等方案,否则最多只能解决 Kafka 内部那一段链路。:contentReference[oaicite:4]{index=4}
理解这条边界后,判断 EOS 就不再是“有没有开事务”,而是检查结果写入、处理进度和最终副作用是否处在同一个可证明的一致性边界内。