
通信工程 / 系统课时
按带宽时延与复杂度选择纠错码
按带宽时延与复杂度选择纠错码
对 64 字节短包,纠错能力更强的编码未必能部署:冗余会挤占带宽,交织会增加等待,译码还要消耗算力。这里用统一的包长、最坏时延和内存预算筛选候选码,最后得到一套可验证的短包抗突发错误方案。
学习目标
- 把带宽、时延、纠错能力和算力限制写成可以比较的指标。
- 计算短包采用 Hamming 码与缩短 RS 码的实际传输开销。
- 用突发错误分散、预算脚本与实测验收确定编码组合。
把链路需求写成硬约束
假设设备每 2 ms 产生 64 B 有效载荷,物理层可用数据速率为 1 Mb/s。发送端先为载荷追加 4 B CRC-32,再交给纠错编码器,因此待保护的数据共 68 B。CRC 用于检测纠错后仍存在的错误,不应被误算成纠错能力。
本例的验收条件是:每个业务包编码后最多占 100 B;从第一包数据就绪到交付的最坏时延不超过 8 ms;单码字译码耗时不超过 1 ms,接收端峰值 RAM 不超过 16 KiB;在字节边界保持同步的前提下,必须能处理连续 20 个受损字节。
原始业务速率是 。即便编码后每包占 100 B,每 2 ms 也只占用 400 kb/s 物理带宽;因此本例更紧的限制是单包开销、突发错误和端到端时延。这里的 100 B 不含物理层前导码、链路帧头和重传开销。
用相同载荷核算候选码
| 候选方案 | 编码后大小 | 能保证的纠错能力 | 初筛 |
|---|---|---|---|
| 仅 CRC-32 | 68 B | 检错,不纠错 | 20 B 突发错误无法恢复 |
| Hamming(7,4) | 119 B | 每个 7 bit 码字最多纠正 1 bit | 超出 100 B |
| 缩短 RS(100,68) | 100 B | 每个码字最多纠正 16 个未知错误字节 | 码长合格,需处理突发集中 |
Hamming 方案将 68 B 转成 544 bit,再按每 4 bit 信息生成 7 bit 码字: bit,即 119 B。即使译码计算量很小,也过不了包长预算。
RS(100,68) 可由 GF(256) 上具有 32 个校验符号的 RS(255,223) 缩短得到。68 B 信息中已经包含 CRC-32,编码后追加 32 B 校验符号;对于未知位置的错误,最多可纠正 16 个错误字节。若另选 LDPC 或 Polar 实现,也必须先查清实际码长与填充量:例如一个 1024 bit 的候选码字就占 128 B,直接超限,但这不代表所有短码长 LDPC 或 Polar 实现都不适用。
用两路交织分散连续错误
20 B 连续受损如果全部落在同一个 RS 码字内,就超过了 16 字节纠错半径。可先分别编码相邻两包,再按字节交替发送两个 100 B 码字。这样,在连续 20 个传输字节出错且没有字节插入、丢失的条件下,两条码字各承受 10 个错误字节,均未超过纠错能力。
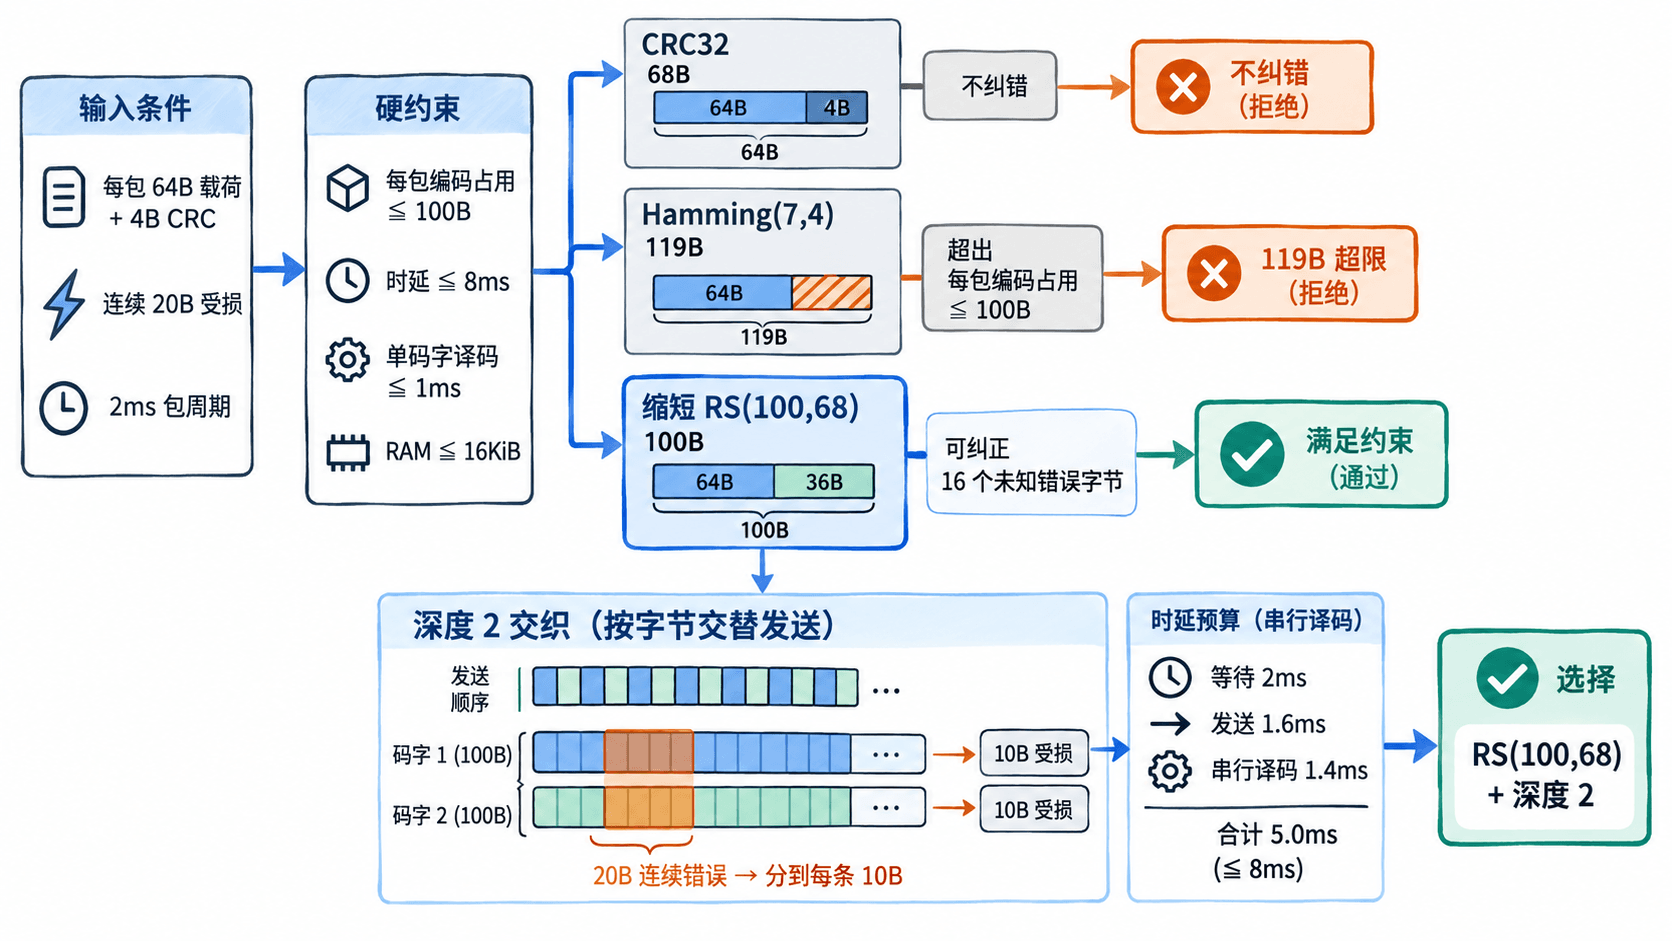
代价是要等第二包到达:等待 2 ms,两包共 200 B 在 1 Mb/s 下发送用 1.6 ms。假设目标设备单码字译码最坏耗时 0.70 ms、两条串行译码,首包预算为 ms,满足 8 ms。此处 0.70 ms 和包括交织缓冲区在内的 12 KiB RAM 是用于演示筛选的假设测量值,不是 RS 算法的固定性能。物理层还必须允许跨两包发送 200 B 交织块;若只允许独立的 100 B 物理帧,需要重新设计交织映射。
用脚本执行同一套筛选
下面的 Python 3 程序以相同口径计算三种方案。将其中译码时间和 RAM 数值替换为目标板卡上测得的最坏值后,就能复用筛选过程。correct_bytes=0 对非 RS 候选仅表示不保证恢复本例的整段字节突发,并不否认 Hamming 的单比特纠错能力。
from math import ceil

rate_bps = 1_000_000
period_ms = 2.0
burst_bytes = 20
max_bytes, max_latency_ms = 100, 8.0
max_decode_ms, max_ram_kib = 1.0, 16

# 译码时间与 RAM 为演示输入,实际要替换为板上最坏值
plans = [
    {"name": "CRC32", "bytes": 68, "depth": 1, "correct_bytes": 0, "decode_ms": 0.05, "ram_kib": 1},
    {"name": "Hamming(7,4)", "bytes": ceil((68 * 8 / 4) * 7 / 8), "depth": 1, "correct_bytes": 0, "decode_ms": 0.10, "ram_kib": 2},
    {"name": "RS(100,68)+D2", "bytes": 100, "depth": 2, "correct_bytes": 16, "decode_ms": 0.70, "ram_kib": 12},
]

for p in plans:
    depth = p["depth"]
    # 按攒齐一批码字并串行译码,估算首包时延
    latency_ms = (
        (depth - 1) * period_ms
        + depth * p["bytes"] * 8 / rate_bps * 1000
        + depth * p["decode_ms"]
    )
    damaged = ceil(burst_bytes / depth)
    fits = (
        p["bytes"] <= max_bytes
        and latency_ms <= max_latency_ms
        and p["decode_ms"] <= max_decode_ms
        and p["ram_kib"] <= max_ram_kib
        and damaged <= p["correct_bytes"]
    )
    print(f"{p['name']}: {p['bytes']} B, {latency_ms:.2f} ms, burst={damaged}, {'PASS' if fits else 'FAIL'}")
预期输出:
CRC32: 68 B, 0.59 ms, burst=20, FAIL
Hamming(7,4): 119 B, 1.05 ms, burst=20, FAIL
RS(100,68)+D2: 100 B, 5.00 ms, burst=10, PASS
PASS 只说明在给定错误模型和假设资源值下通过硬约束,不等于已经通过真实链路的误包率测试。
用失败样本完成最终验收
在统一载荷、帧头开销和编码后传输速率口径下,对入选方案开展三类验证:
- 固定随机种子
20261022,分别在独立比特误码率 和 下发送至少 30000 包,统计 CRC 拒收形成的误包率 PER;本例将目标定为 PER 不超过 。零失败也不等于失败概率为零。 - 对交织后的发送字节流插入连续 20 B 错误,遍历交织块内不同起点及跨块边界,检查解交织、RS 译码和 CRC 验证;再用连续 34 B 错误确认超出纠错半径时不会误报“保证恢复”。
- 在目标 CPU 主频、负载和最坏输入下测量单码字译码时间、峰值 RAM 与首包最长交付时延;必须分别满足 1 ms、16 KiB 和 8 ms 的上限。
本例可优先采用缩短 RS(100,68) + 深度 2 字节交织 + 译码后 CRC 校验。若实测时间或存储超预算,应重新比较交织深度、短码长替代方案或重传机制;若信道存在整包丢失或字节失步,不能把这里针对“受损字节”的纠错保证直接套用。