
通信工程 / 系统课时
衡量交织深度带来的额外时延
衡量交织深度带来的额外时延
交织能将线路上的连续错误分散到多个纠错码字,但收发两端必须暂存数据才能重排。本篇用 RS(255,223)、48 字节突发错误和确定的编码字节速率,算出不同交织深度的缓存开销与首组可用时间,并按低时延预算选择深度。
学习目标
- 区分交织深度、码字长度和实际缓存容量。
- 换算整组交织的首组等待时间及相对基线增加量。
- 用可运行的仿真比较纠错余量与时延预算。
明确交织深度的含义
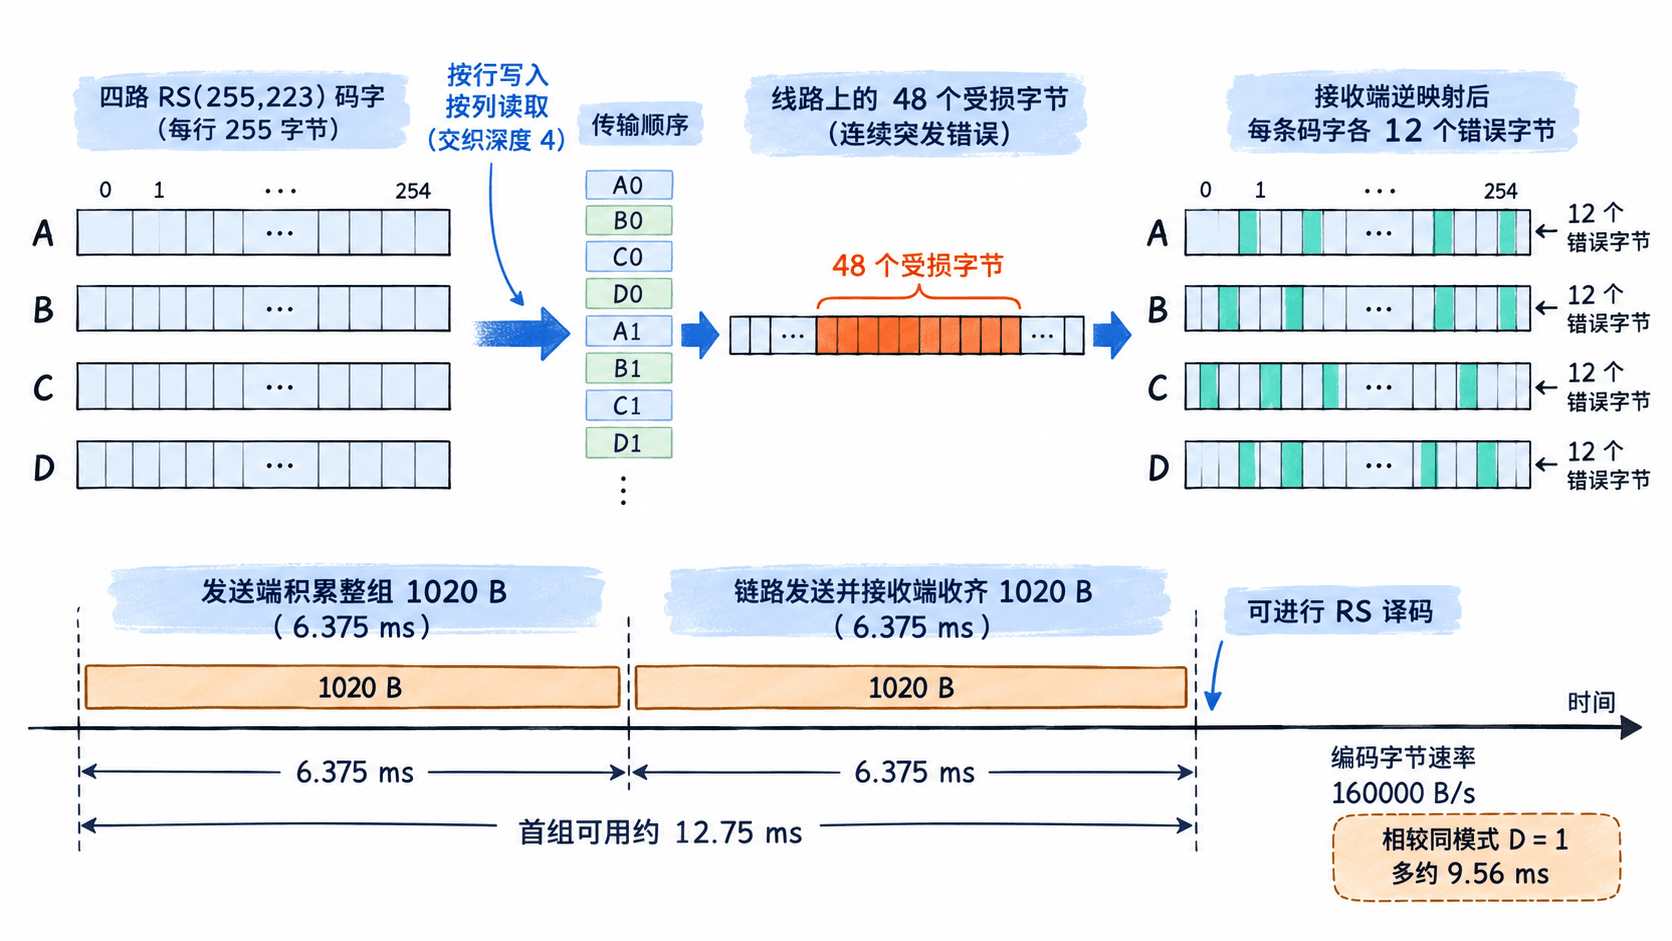
采用字节级 RS(255,223):每个码字含 223 个数据字节和 32 个校验字节,单个码字最多纠正 16 个错误字节。设交织深度为 ,表示同时交织 个完整码字;先按行放入不同码字,再逐列轮流取出字节发送,而不是把单一码字本身变长。
整组容量为 字节。若信道出现连续 个受损编码字节,逐列轮询使每个码字最多承受 个错误字节。例如 时每个码字承受 12 个错误字节,低于 16 字节纠错上限。该结论假定错误按编码字节连续出现,且没有额外随机错误。
估算缓冲空间与首组等待
假设编码后的线路有效速率为 字节/秒,发送端先积累一整组再发送,接收端收齐整组后才批量输出解交织结果。发送端和接收端各需至少 字节的整组缓存;若用双缓冲并行处理前后两组,则每端约需 字节,不含 RS 译码工作区。
从第一个已编码字节进入发送缓冲,到接收侧拿到完整首组,简化模型的时间为 秒:前半段积累整组,后半段串行发送并同步填满接收缓存。以同样采用整组缓存的 为基线,增加量为 秒。
取 ,单端每组缓存为 1020 字节,首组可用时间约 12.75 毫秒,比基线多约 9.56 毫秒;双缓冲则每端预留约 2040 字节。若改为 ,每端单组缓存翻倍到 2040 字节,相对基线增加约 22.31 毫秒。
用 Python 复算错误分散和时延
下面的 Python 3 示例先生成交织后的码字归属顺序,再模拟线路从偏移 17(从零计)开始连续损坏 48 个编码字节。输出显示每个深度下单端缓存、首组时间、相对基线增量以及最坏码字错误数。
N = 255
RATE = 160_000
BURST = 48
T = 16

def evaluate(depth):
    # 同一列轮流发送 D 个码字的对应字节
    order = [row for col in range(N) for row in range(depth)]
    errors = [0] * depth
    # 假设线路偏移 17 开始的 48 字节全部受损
    for row in order[17:17 + BURST]:
        errors[row] += 1

    block = depth * N
    first_ms = 2 * block / RATE * 1000
    # D=1 也采用完整组缓存,以保持比较口径一致
    extra_ms = 2 * (depth - 1) * N / RATE * 1000
    return block, first_ms, extra_ms, max(errors)

for depth in (2, 3, 4, 8):
    block, first, extra, worst = evaluate(depth)
    verdict = "PASS" if worst <= T else "FAIL"
    print(f"D={depth}: buf={block}B, first={first:.2f}ms, extra={extra:.2f}ms, errors={worst}, {verdict}")
预期输出:
D=2: buf=510B, first=6.38ms, extra=3.19ms, errors=24, FAIL
D=3: buf=765B, first=9.56ms, extra=6.38ms, errors=16, PASS
D=4: buf=1020B, first=12.75ms, extra=9.56ms, errors=12, PASS
D=8: buf=2040B, first=25.50ms, extra=22.31ms, errors=6, PASS
这里的 PASS 仅代表本次突发错误在 RS(255,223) 的符号纠错数限制内,并非执行了真正的 RS 译码。若还有独立随机字节错误,某个码字仍可能超出 16 个错误字节。
按低时延预算确定深度
假设业务允许交织相对同实现的 最多新增 12 毫秒,同时要承受最坏 48 字节连续突发错误。 会让每码字出现 24 个错误字节,无法可靠纠正; 的 16 个错误字节恰好压线,没有额外余量。 只增加约 9.56 毫秒,并保留每码字 4 个错误字节的余量,应优先选择。 虽然更能分散突发错误,但新增约 22.31 毫秒,超过预算。
落地时应记录发送端首字节入组、接收端整组可用的时间戳,比较 P95/P99 首组等待、峰值缓存和译码失败率。若完整业务时延仍超标,应结合更短码字、更高传输速率或适用场景下的重传机制重新核算,不应仅继续加深交织。