
通信工程 / 系统课时
验证汉明码(7,4)的纠错效果
验证汉明码(7,4)的纠错效果
把 4 位消息编码成 7 位码字,再人为翻转接收比特,使用综合症定位和纠正错误。通过 Python 遍历全部信息组合与错误位置,可以验证汉明码的单错纠正能力,并观察双错为何可能被误纠,从而明确这种译码方法的适用边界。
学习目标
- 实现汉明码(7,4)的偶校验编码、综合症计算和单错纠正。
- 使用具体码字验证单比特错误的定位与恢复过程。
- 穷举单错和双错组合,解释双错误纠原因及 SECDED 改进方案。
确定码字位序与偶校验规则
汉明码(7,4)将 4 位信息映射成 7 位码字,其中 3 位是校验位,码率为 。本例采用从左到右编号 1~7 的约定,校验位位于第 1、2、4 位,信息位依次放入第 3、5、6、7 位。
采用偶校验规则:每组参与校验的比特进行异或运算,结果必须为 0。三个校验位分别覆盖以下位置:
- 校验位 :位置 1、3、5、7。
- 校验位 :位置 2、3、6、7。
- 校验位 :位置 4、5、6、7。
例如,输入信息位 1011,依次放入第 3、5、6、7 位,计算得到 、、,最终码字为 0110011。对上述三组比特重新计算异或,结果全部为 0,说明生成的码字满足校验约束。
这三个校验关系对应一个具有 3 行、7 列的校验矩阵。第 1~7 列分别是各位置编号的三位二进制表示,按 的顺序排列,因此每个单比特错误都会产生独一无二的非零综合症。
根据综合症定位并纠正错误
接收码字记为 。接收端无需知道原始信息,只需要重新计算三组奇偶校验:
将三个校验结果合成整数综合症 。当 时,不执行纠错;当 为 1~7 时,在最多发生一个比特错误的前提下,直接翻转码字的第 位。
例如,把码字 0110011 的第 6 位翻转,得到 0110001。此时 、、,所以 。接收端翻转第 6 位后恢复原码字,再读取第 3、5、6、7 位,得到信息 1011。
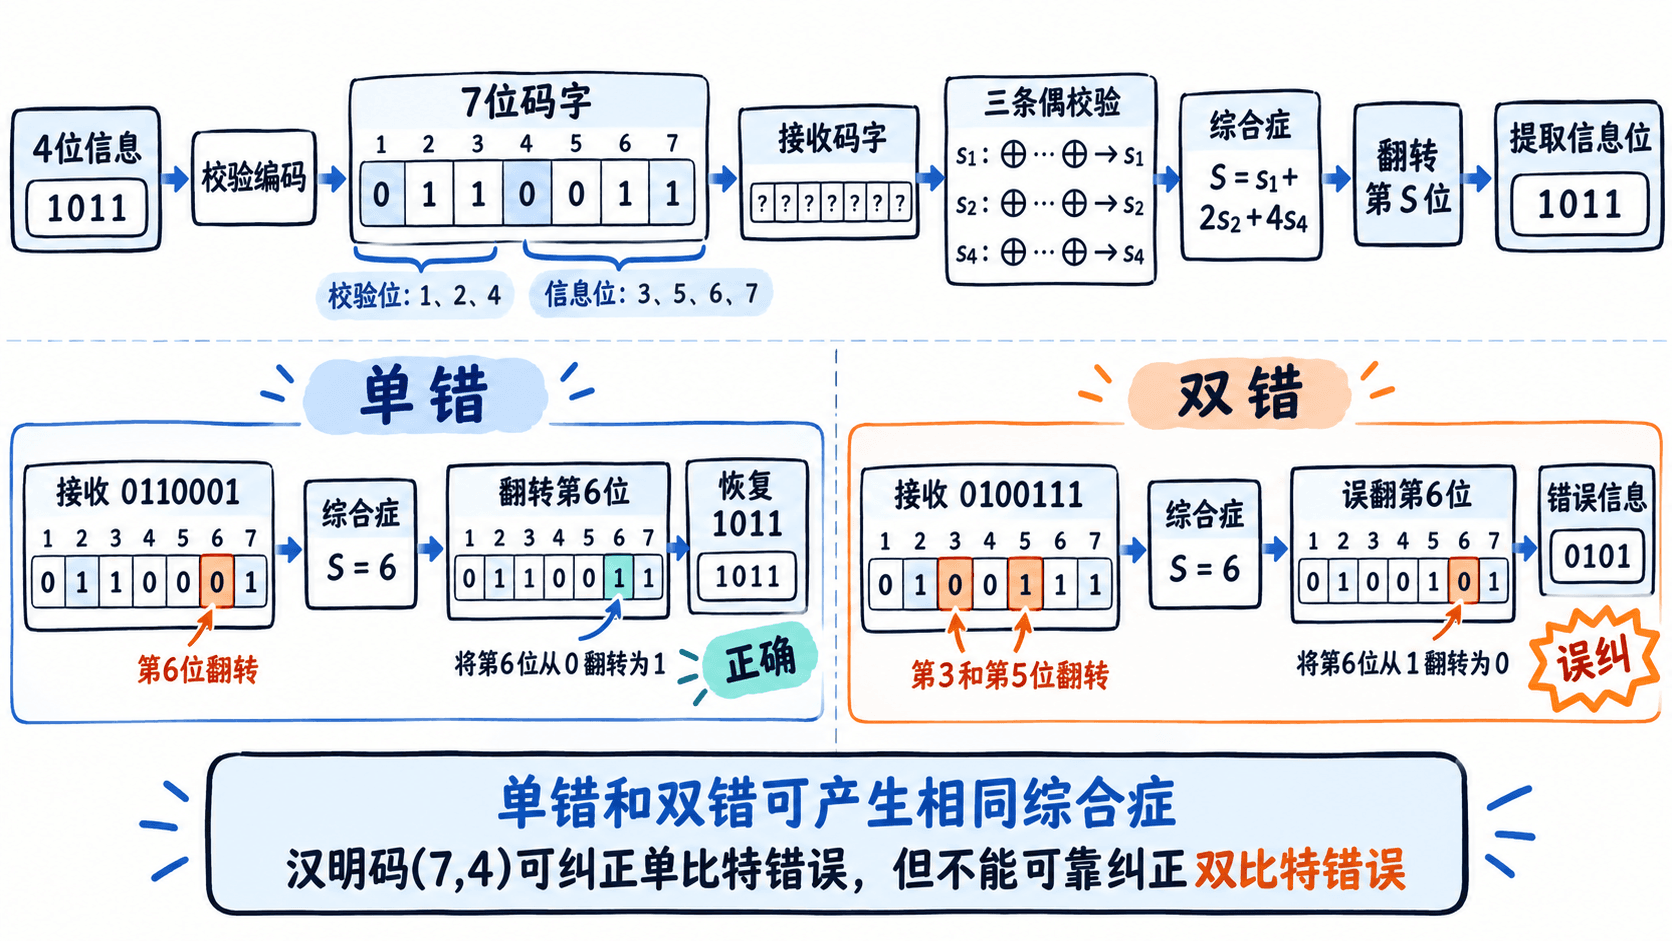
这里最重要的前提是最多只有一位出错。非零综合症只说明校验未通过,并不能保证接收序列中恰好存在一个错误。如果存在两位错误,它们的综合症也可能对应某个合法的单错位置。
使用 Python 穷举验证纠错效果
下面使用 Python 3.8 或更新版本的标准库,实现编码、综合症译码和错误注入。代码先展示一个具体消息的无错、单错、双错结果,再穷举所有 16 种四位信息、7 个单错位置及 21 组双错位置。
将代码保存为 hamming74.py,执行 python hamming74.py。不需要安装第三方依赖。
from itertools import combinations, product

DATA = (3, 5, 6, 7)
CHECK = (1, 2, 4)


def encode(data):
    # 使用1起始的下标,与码字位置编号保持一致
    word = [0] * 8
    for pos, bit in zip(DATA, data):
        word[pos] = bit

    # 计算校验位,使对应校验组的异或结果为0
    for mask in CHECK:
        for pos in range(1, 8):
            if pos != mask and pos & mask:
                word[mask] ^= word[pos]
    return word[1:]


def syndrome(word):
    s = 0
    for mask in CHECK:
        check = 0
        for pos in range(1, 8):
            if pos & mask:
                check ^= word[pos - 1]
        if check:
            s |= mask
    return s


def decode(received):
    corrected = received.copy()
    position = syndrome(corrected)
    # 仅在最多单错的假设下,综合症才是可靠的错误位置
    if position:
        corrected[position - 1] ^= 1
    return tuple(corrected[p - 1] for p in DATA), position


def corrupt(word, positions):
    output = word.copy()
    for pos in positions:
        output[pos - 1] ^= 1
    return output


data = (1, 0, 1, 1)
code = encode(data)
print('编码码字:', ''.join(map(str, code)))

for label, positions in [
    ('无错', ()),
    ('单错(第6位)', (6,)),
    ('双错(第3、5位)', (3, 5)),
]:
    restored, s = decode(corrupt(code, positions))
    decoded_str = ''.join(map(str, restored))
    print(f'{label}: S={s}, 信息位={decoded_str}, 正确={restored == data}')

# 穷举所有消息及单错、双错位置组合
single_ok = double_wrong = 0
for message in product((0, 1), repeat=4):
    word = encode(message)
    assert syndrome(word) == 0

    for pos in range(1, 8):
        restored, _ = decode(corrupt(word, (pos,)))
        single_ok += restored == message

    for pair in combinations(range(1, 8), 2):
        restored, _ = decode(corrupt(word, pair))
        double_wrong += restored != message

print(f'单错正确: {single_ok}/112')
print(f'双错误纠: {double_wrong}/336')
预期输出:
编码码字: 0110011
无错: S=0, 信息位=1011, 正确=True
单错(第6位): S=6, 信息位=1011, 正确=True
双错(第3、5位): S=6, 信息位=0101, 正确=False
单错正确: 112/112
双错误纠: 336/336
这里的枚举数量可以直接核对:单错样本数为 ;双错样本数为 。每种信息都经过相同的编码、错误注入和译码流程,避免只测试一条消息而误判算法能力。
结果显示,112 组单错全部正确恢复;336 组双错在当前纠错策略下全部得到错误信息。后一个数字不是随机信道中的误码率,而是在恰好翻转两个比特的测试条件下,这个单错译码器发生误纠的次数。
理解双错局限与改进方法
汉明码(7,4)的最小码距为 3,因此可以保证纠正一个比特错误;如果只做错误检测而不尝试纠正,最多可以保证检测两个比特错误。但是使用综合症直接定位并翻转时,双错会被当成某个单错,无法可靠地区分。
以第 3、5 位同时出错为例,两次错误对应的综合症分别是 3 和 5,组合后的综合症为 。译码器会错误翻转第 6 位,造成总共三个位置与原码字不同。即使再次检查综合症得到 0,也无法证明恢复的信息正确。
一种常用改进是增加一个覆盖全部 7 位码字的总体偶校验位,形成扩展汉明码(8,4),也称 SECDED(单错纠正、双错检测)。在假设最多两位错误时,可联合判断原有综合症和整体奇偶校验:
| 原综合症 | 总体奇偶校验 | 处理方式 |
|---|---|---|
| 偶数 | 判定无错 | |
| 奇数 | 纠正前7位中的第S位 | |
| 奇数 | 纠正新增的总体校验位 | |
| 偶数 | 判定双错,报告不可纠正 |
可以进一步修改 corrupt() 的错误位置组合,验证不同双错产生的综合症。对于标准汉明码(7,4),关键验收结论是:7 个单错位置都能被正确纠正,而双错不能交给同一个单错纠正规则安全处理;如果业务要求双错可检测,需要增加总体校验位或选择纠错能力更强的编码方案。