
通信工程 / 系统课时
排查误码平台与译码不收敛问题
排查误码平台与译码不收敛问题
当 BER 曲线在提高信噪比后不再下降,或 LDPC 译码器始终达到迭代上限,先不要直接更换编码方案。本课用原始硬判决、LLR、校验综合症与逐轮日志分层定位故障,并通过一段可运行的归一化 Min-Sum 示例验证修复方法。
学习目标
- 根据原始 BER、译码 BER 与综合症区分信道参数错误和译码错误。
- 校验 BPSK 软信息的符号、噪声方差与码率换算。
- 用迭代上限、提前停止和固定测试向量复现不收敛问题。
先确定平台出现在哪一层
在同一组 点上,分别记录译码前的硬判决 BER、译码后的信息位 BER、帧错误率 FER、平均迭代次数,以及未通过校验的帧数。不要只保存一条最终 BER 曲线。
| 观察现象 | 优先检查 |
|---|---|
| 高信噪比下硬判决 BER 接近 1 | BPSK 比特映射或 LLR 正负方向颠倒 |
| 硬判决 BER 接近 0.5 | 发送与接收比特错位、解交织顺序或判决几乎随机 |
| 未译码 BER 明显偏离理论基线 | 噪声标准差、符号能量和 换算 |
| 未译码 BER 正常,译码后出现平台 | 校验矩阵、软输入、迭代上限与停止条件 |
| 极低 BER 区域少数帧反复失败 | 量化饱和、陷阱集或有限码长固有错误平台 |
检查路径应从调制解调开始,经过软信息、译码迭代,再到有效码字判定。否则调高 max_iter 可能掩盖前端的符号错误。
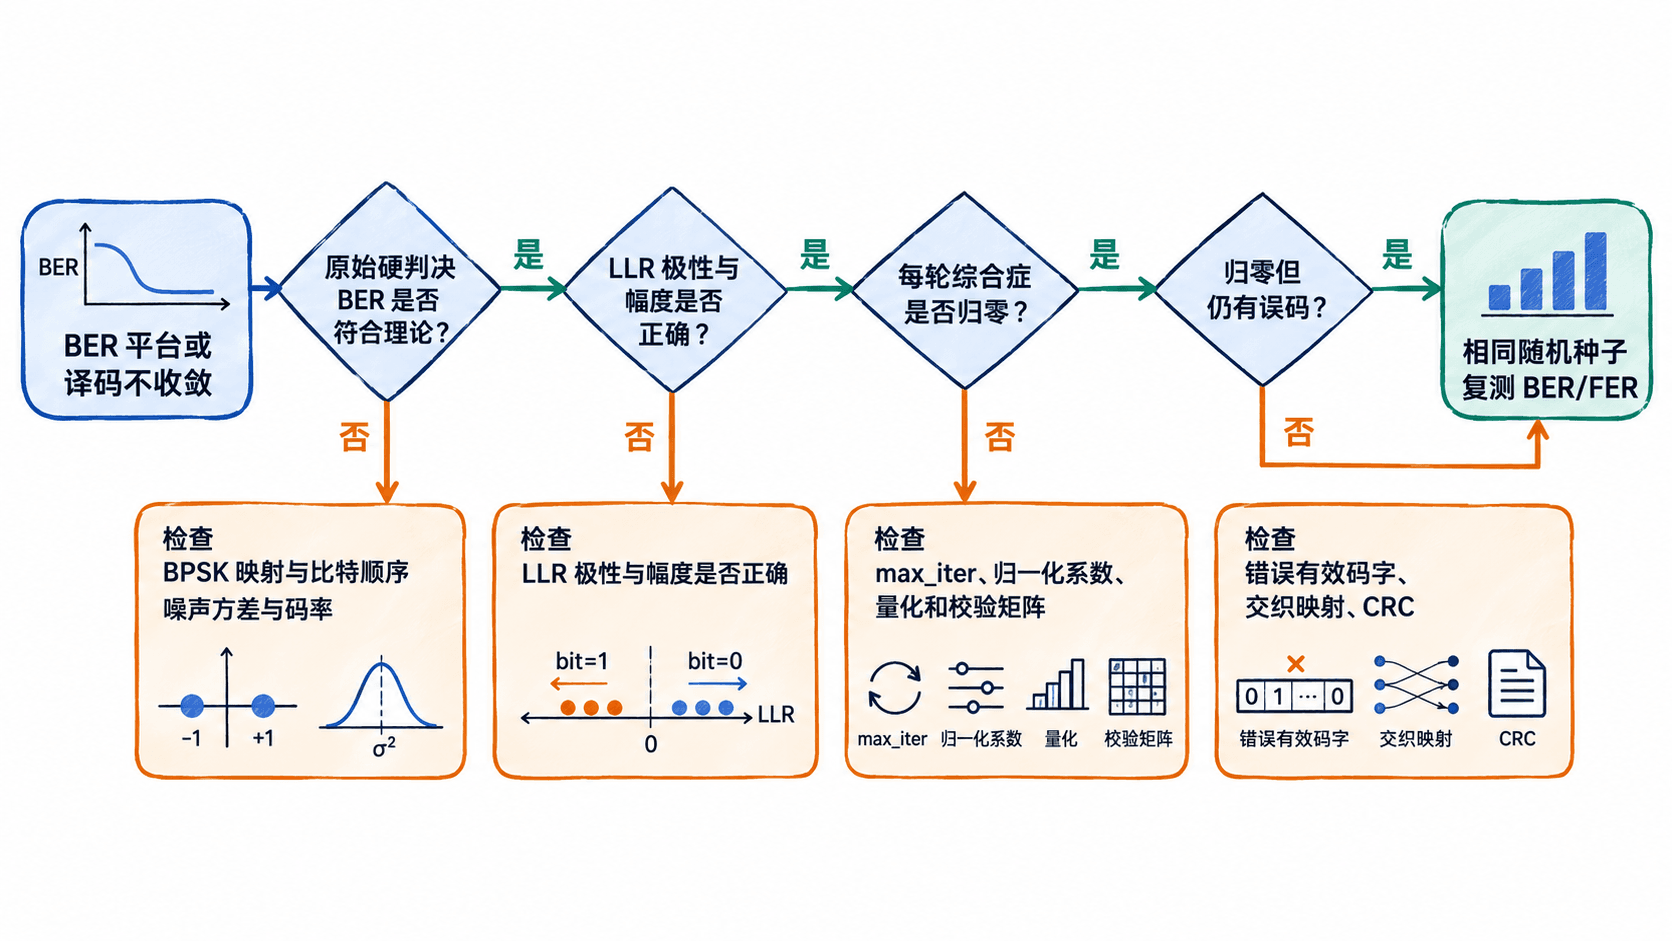
校准 LLR 极性和噪声方差
约定发送比特 0 映射 BPSK 符号 +1,比特 1 映射 -1,接收值为 ,其中 是均值为零、方差为 的实高斯噪声。若采用“比特 0 相对比特 1”的对数似然比,则
因此 正 LLR 倾向比特 0,负 LLR 倾向比特 1。若译码器接口定义相反,必须在接口边界统一翻转,不能只翻转输出位。先用 y=+0.8 和 y=-0.4 验证硬判决应分别为 0、1。
当每个实 BPSK 符号的能量归一为 1、横轴使用每信息位的 、码率为 时:
例如 、 时,;若不编码,,则 ,理论硬判决 BER 约为 0.0229。比较曲线时必须明确横轴是 还是 ,不能把码率因子计算两次。
用固定软输入验证迭代停止
以下示例使用 Python 3 标准库、一个教学用的 校验矩阵与归一化 Min-Sum,发送全零码字。固定输入含两个初始错误位,对比 max_iter=1 与 10;这是译码单元测试,不是用于估计 BER 的蒙特卡洛实验。
from math import sqrt

H = ((1, 1, 0, 1, 0, 0),
     (0, 1, 1, 0, 1, 0),
     (1, 0, 1, 0, 0, 1))

def decode(llr, max_iter, alpha=0.8):
    m, n = len(H), len(llr)
    edges = [[j for j, h in enumerate(row) if h] for row in H]
    v2c = [[llr[j] if H[i][j] else 0.0 for j in range(n)]
           for i in range(m)]
    for iteration in range(1, max_iter + 1):
        c2v = [[0.0] * n for _ in range(m)]
        # 校验节点更新时,排除发送目标变量的入边消息
        for i, cols in enumerate(edges):
            for j in cols:
                other = [v2c[i][k] for k in cols if k != j]
                sign = -1 if sum(v < 0 for v in other) % 2 else 1
                c2v[i][j] = alpha * sign * min(abs(v) for v in other)
        posterior = [llr[j] + sum(c2v[i][j] for i in range(m))
                     for j in range(n)]
        bits = [int(v < 0) for v in posterior]
        syndrome = [sum(H[i][j] * bits[j] for j in range(n)) % 2
                    for i in range(m)]
        # 只有综合症全零,才报告校验收敛
        if not any(syndrome):
            return bits, iteration, True
        v2c = [[posterior[j] - c2v[i][j] if H[i][j] else 0.0
                for j in range(n)] for i in range(m)]
    return bits, max_iter, False

rate, ebn0_db = 0.5, 3.0
sigma2 = 1 / (2 * rate * 10 ** (ebn0_db / 10))
print(f"sigma={sqrt(sigma2):.3f}")
print("hard_bits=", [int(2 * y / sigma2 < 0) for y in (0.8, -0.4)])

llr = (0.51, 2.94, -0.40, 1.66, -0.83, 2.54)
for limit in (1, 10):
    bits, iters, ok = decode(llr, limit)
    print(f"max_iter={limit}: converged={ok}, iterations={iters}, errors={sum(bits)}")
预期输出:
sigma=0.708
hard_bits= [0, 1]
max_iter=1: converged=False, iterations=1, errors=2
max_iter=10: converged=True, iterations=3, errors=0
示例在第 3 轮校验通过,说明 max_iter=1 会造成可重现的“迭代耗尽”。这里的 errors 等于输出的 1 的数量,仅因为已知发送的是全零码字;真实仿真必须逐位对比原始信息位。
区分译码耗尽、误停止与错误码字
每帧至少保存 iterations、最终综合症中非零校验数、译码成功标志与实际信息位错误数。排查时按照以下顺序改动,每次只改一个变量:
- 检查停止判断:每轮对最终后验硬判决计算 ;只有综合症全零才可报告“校验通过”。到达
max_iter仍非零时标记为失败,不能丢弃该帧后再计算 BER。 - 确认码字关系:综合症全零只代表得到合法码字,不保证等于发送码字。若校验通过却仍有误码,核对
H列顺序、编码器输出顺序、交织与解交织;有 CRC 时再检查 CRC。 - 隔离算法参数:保持相同输入,比较
max_iter=10、30、50与 Min-Sum 系数alpha=0.7、0.8、0.9。若更高上限显著减少非零综合症帧,属于迭代预算不足;若无改善,再查消息更新和错误陷阱。 - 检查软信息边界:打孔且未知的位通常输入
LLR=0;已知缩短为0的位应输入足够大的正 LLR。定点译码先对比浮点结果,再检查裁剪阈值是否让大量 LLR 饱和。
用可比实验确认平台已经消失
固定编码器、码率、调制、帧长和随机种子(例如 20261022),分别跑 1、2、3、4 dB 的 。每个信噪比点记录总信息位数、错误信息位数、错误帧数、迭代耗尽帧数,以及迭代次数分布;同时保留 的无编码 BPSK 基准用于核对噪声生成器。
信息位 BER 为“错误信息位数 / 已发送信息位数”,FER 为“错误帧数 / 已发送帧数”。每点尽量累计至少 100 个比特错误,此时独立稀有错误计数的相对统计波动仍约 10%;若 N 个信息位中没有观察到错误,不能宣称 BER 等于零,可报告约 3/N 的 95% 上界。
修复前后用相同测试向量与噪声实现对照:LLR 符号正确、无编码基准吻合、迭代耗尽比例下降、译码后 BER 随信噪比总体降低,才算形成完整证据。若仅在极低 BER 留下少数可复现的失败帧,应继续分析陷阱集和有限码长错误平台,而非无限提高迭代上限。